

GPU 应用程序正在使用日益强大的加速器处理不断增长的数据集。根据 2025 年斯坦福 AI 指数,知名 AI 模型的计算能力几乎每五个月就会翻一番,而用于训练 LLM 的数据集规模大约每八个月就会翻一番。随着计算和数据的共同扩展,高效地从存储中移动数据成为保持加速器供应的必要条件。
NVIDIA Magnum IO GPUDirect Storage (GDS) 通过在受支持的存储和 GPU 显存 之间启用直接数据路径来应对这一挑战。这避免了不必要的 CPU 内存暂存,并降低了系统中的整体 CPU 利用率。GDS 由包括许多主要存储供应商在内的不断发展的生态系统提供支持。
在应用层,Python 在现代 AI 开发中发挥着核心作用。截至 2025 年 8 月,在 GitHub 上的所有新 AI 项目中,有近一半主要使用 Python 构建,而 GDS 的主要应用接口是 cuFile C API。
NVIDIA KvikIO 是一个用于高性能文件 I/ O 的 Python 和 C++ 库,可弥合这一差距。它提供高级惯用 Python 和 C++ 接口,以及对如何执行 I/ O 请求的其他控制。
本文教程将演示如何使用 NVIDIA KvikIO Python API 配置存储 I/ O、将数据读入 GPU 显存,以及确认 GDS 中的加速路径是否已激活。它还展示了如何检查影响每次操作路径的 KvikIO 和 cuFile 设置。
NVIDIA KvikIO 如何利用 GDS?
GDS 是更广泛的技术,可在受支持的存储和 GPU 显存之间加速数据传输。对于基于文件系统的存储,cuFile 提供了 C 库和 API,应用程序和框架可通过这些库和 API 访问 GDS。KvikIO 位于 cuFile 之上,提供更高级别的 Python 和 C++ 接口,以及对如何执行 I/ O 请求的控制。图 1 显示了这些层及其两个单独的路径选择点。为清楚起见,系统将省略初始化失败、不支持的配置和错误处理路径。
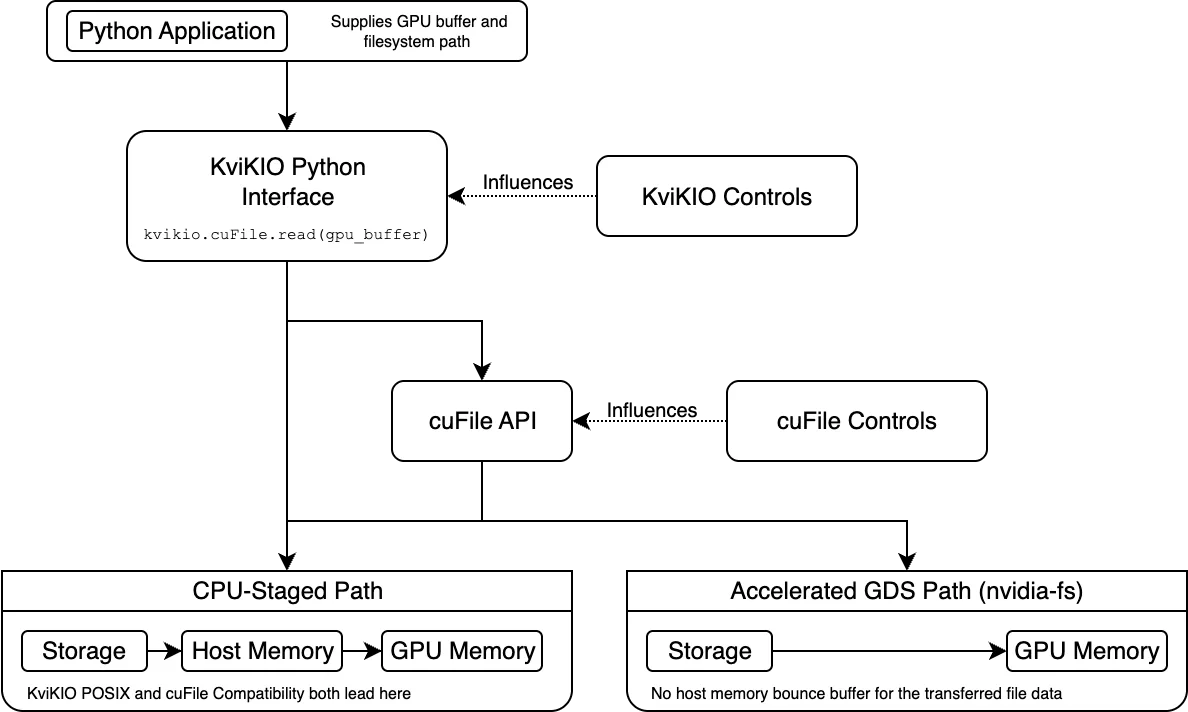
应用提供文件系统路径和 GPU 缓冲区,KvikIO 决定是通过 cuFile 发送请求,还是使用其 POSIX 兼容性路径,该路径通过主机内存暂存数据。选择 cuFile 后,KvikIO 会注册该文件,并使用目标 GPU 缓冲区发出 I/ O。
然后,cuFile 会根据系统支持、文件系统及其配置来确定实际传输路径。它可以使用加速的 GDS 路径或其 CPU 暂存兼容性路径。因此,访问 cuFile API 可确认 KvikIO 已选择 cuFile,但其本身并不能确认已激活加速的 GDS 路径。
以下各节将介绍如何配置系统、执行 KvikIO 读取以及验证生成的路径。
预备知识
在开始本教程之前,您需要:
- 已安装 NVIDIA GPU 和 GPUDirect Storage 的 Linux 系统。
- GDS 支持的存储和文件系统配置。
- 允许在存储端点创建、读取和写入文件,以及访问
gdscheck和gds_stats等 GDS 工具。
有关完整安装和平台要求,请参阅NVIDIA GPUDirect Storage 文档。
教程系统
本教程使用以下配置进行了测试:
- 配备 NVIDIA H100 GPU、CUDA 13.3 和 cuFile 1.18 的
x86_64系统。 - 使用
ext4格式化的本地 NVMe 设备。 - 所选 GPU 和 NVMe 设备之间的 PIX 连接,意味着路径最多通过一个 PCIe 桥接器。
- 禁用 IOMMU 和 ACS 以保留 PCIe 点对点传输。
- 加载
nvidia-fs内核模块以提供加速路径。
您可以使用以下命令检查 GPU 到存储的拓扑结构:
$ nvidia-smi topo -nvme
第 1 步:设置 NVIDIA KvikIO
首先,创建 Python 环境并安装 KvikIO 的 CUDA 13 版本。CuPy 将作为依赖项安装。
$ python3 -m venv kvikio-env
$ source kvikio-env/bin/activate
$ python -m pip install kvikio-cu13
您可以使用以下命令验证安装:
$ python -m pip show kvikio-cu13 cupy-cuda13x
第 2 步:检查配置
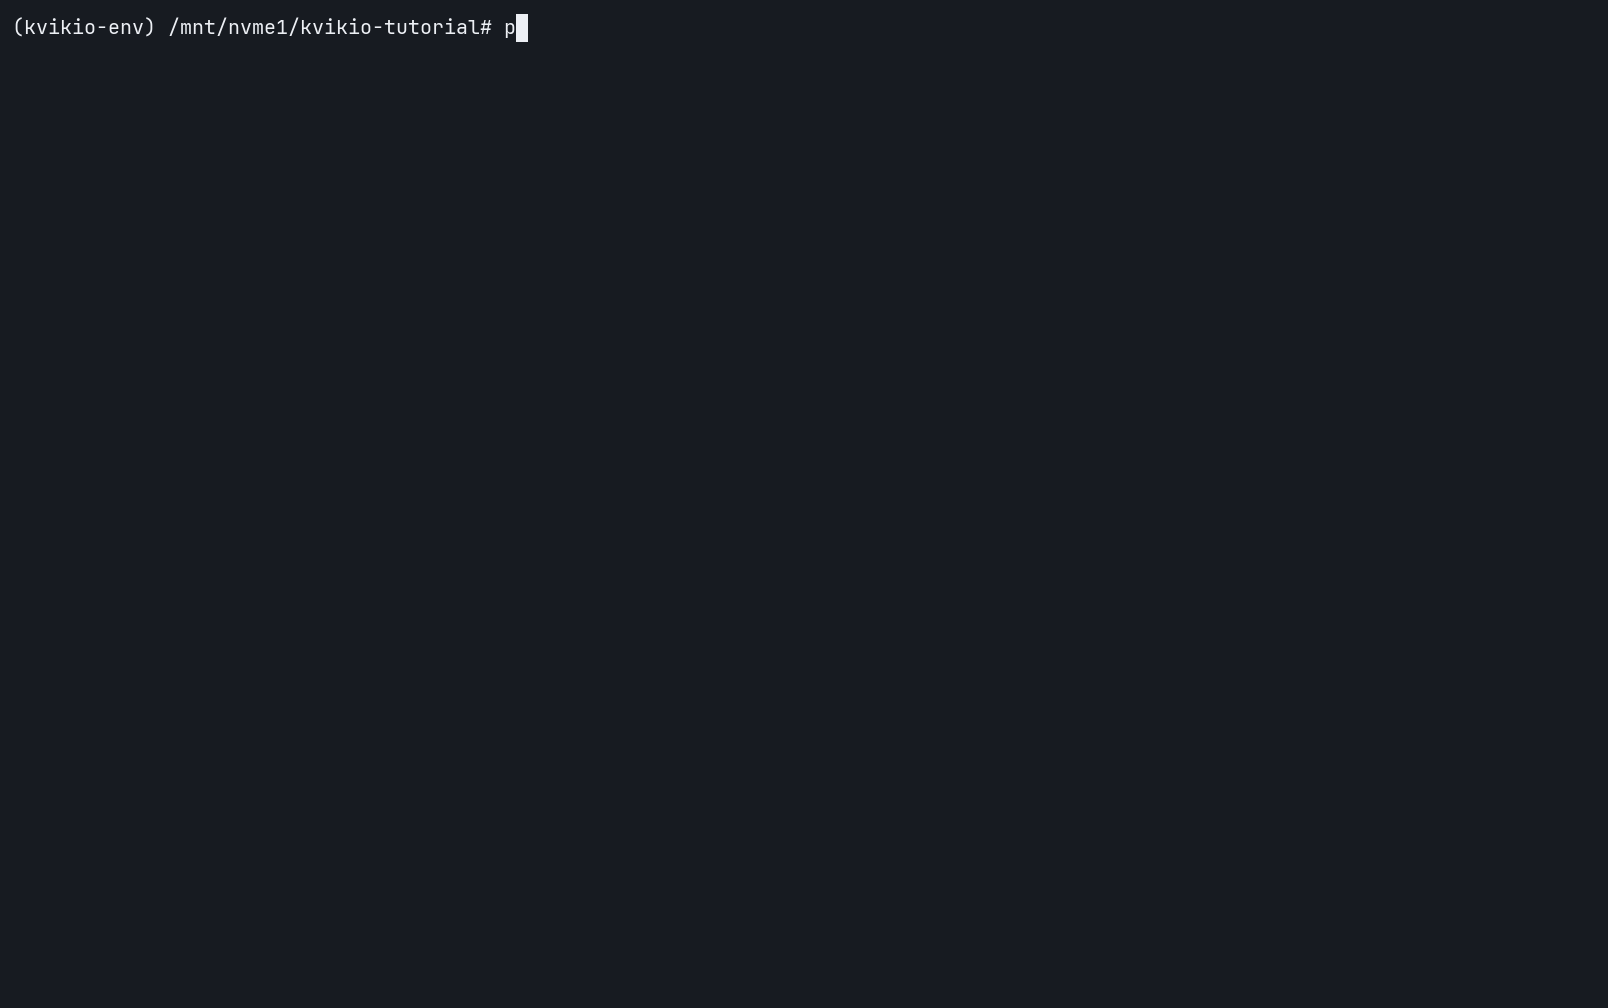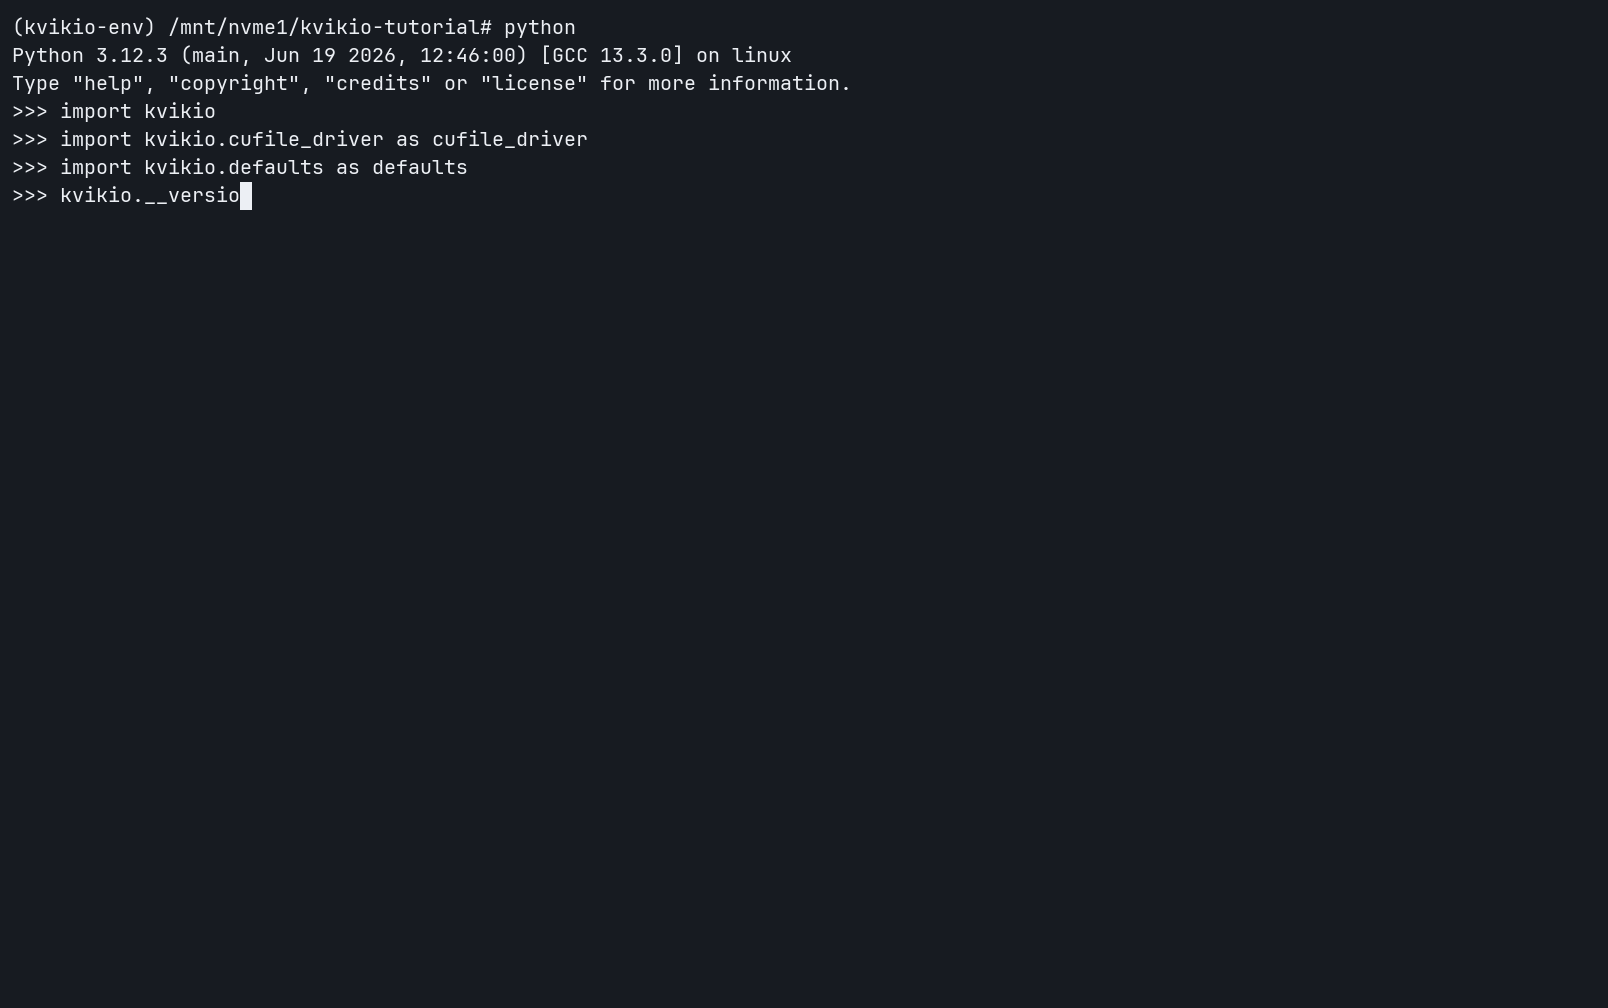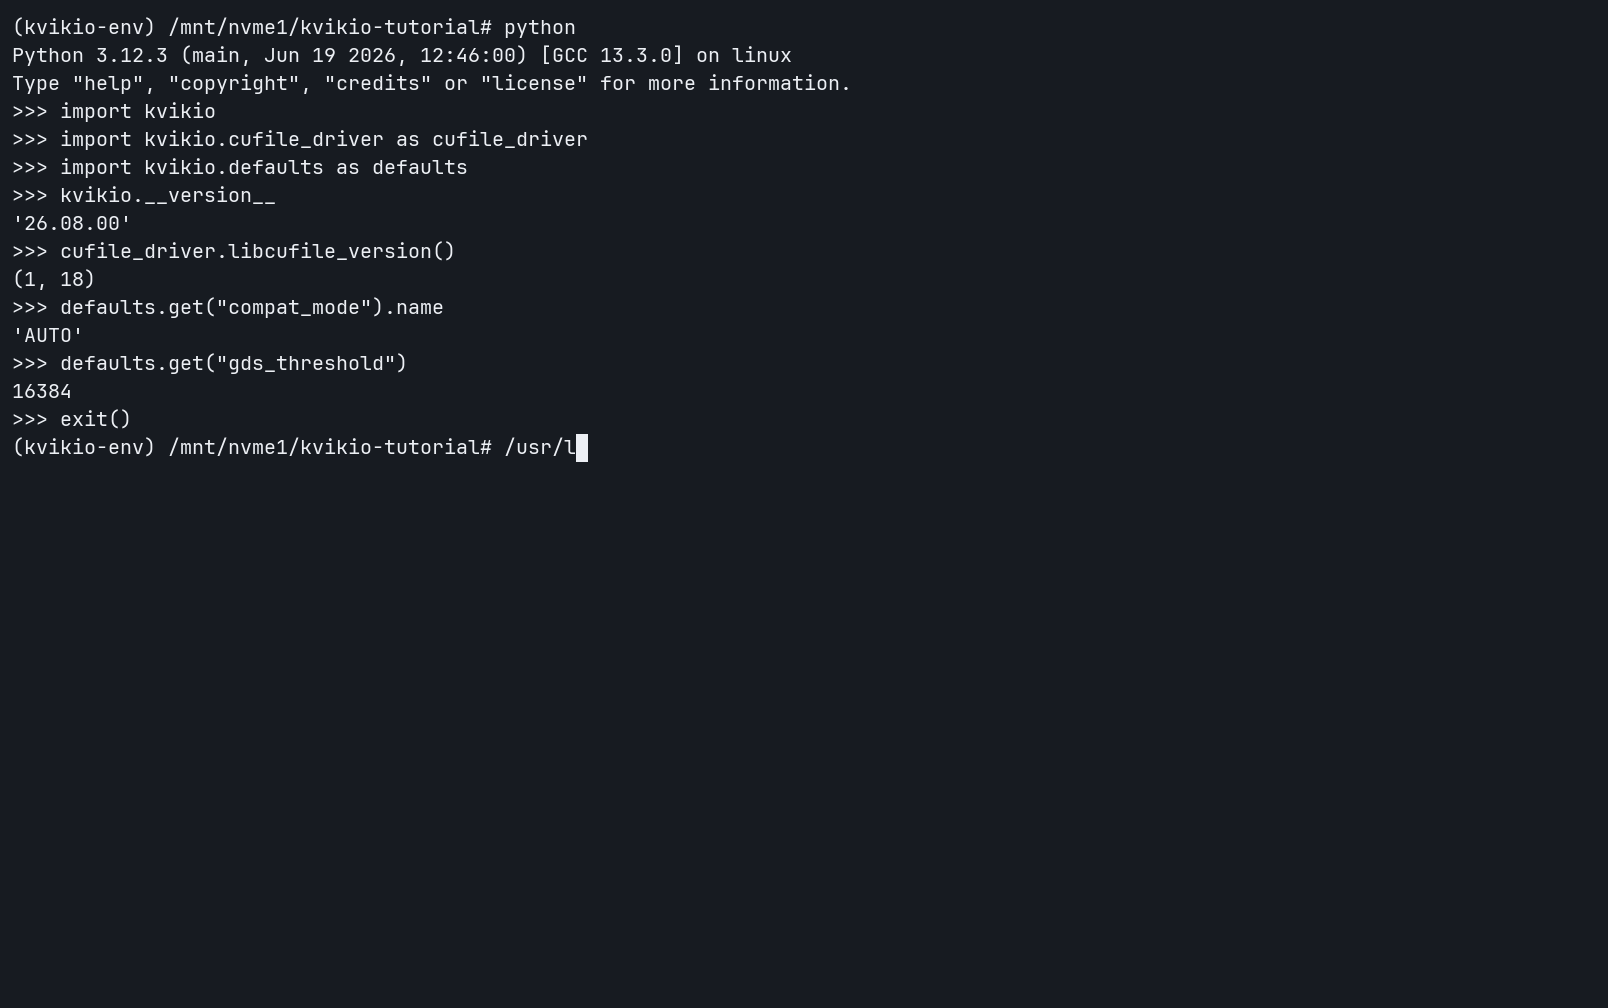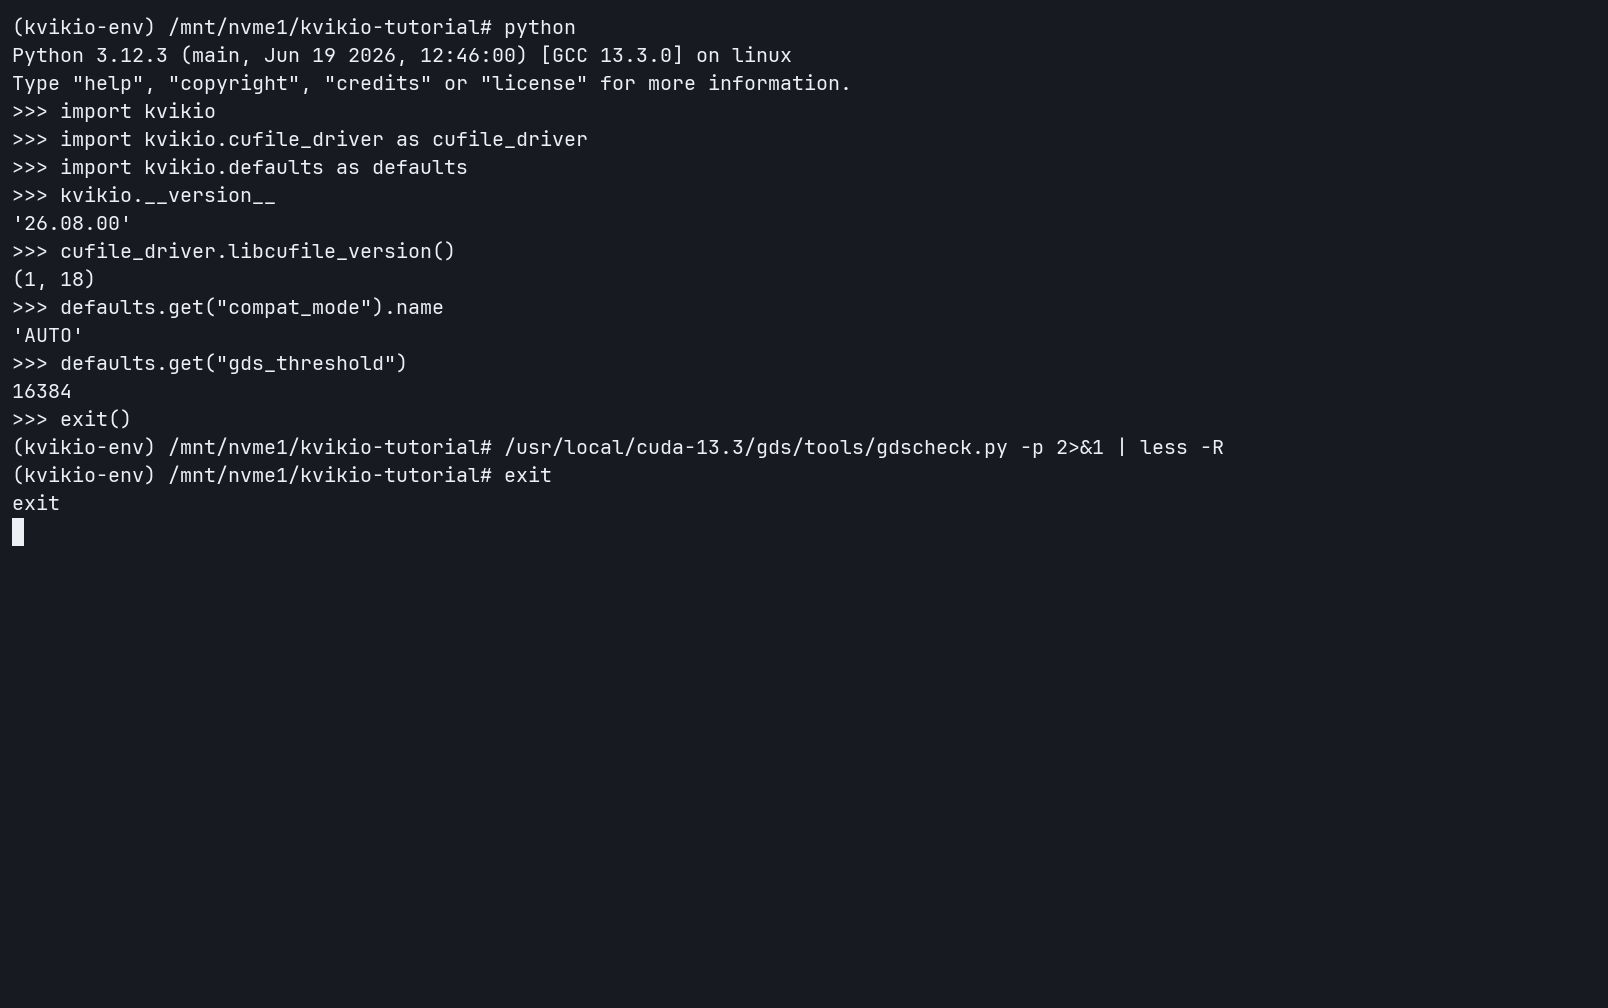
在执行任何 I/ O 之前,请检查活动的 KvikIO 设置,并确认系统可识别 GDS 组件。在 KvikIO defaults API 中,兼容性模式设置名为 compat_mode,其名称属性将活动模式报告为 AUTO、ON 或 OFF。以下命令会报告已加载的 KvikIO 和 cuFile 版本、活动兼容性模式以及 KvikIO 发送给 cuFile 的最小请求大小:
import kvikio
import kvikio.cufile_driver as cufile_driver
import kvikio.defaults as defaults

kvikio.__version__
cufile_driver.libcufile_version()
defaults.get("compat_mode").name
defaults.get("gds_threshold")
在教程系统中,KvikIO 将兼容性模式报告为 AUTO,GDS 值为 16 KiB。AUTO 指示 KvikIO 尝试 cuFile,如果 cuFile 不可用,则回退至其 POSIX 后端。小于值的读取直接使用 KvikIO POSIX 路径。这些设置也可以通过 KVIKIO_COMPAT_MODE 和 KVIKIO_GDS_THRESHOLD 进行控制。有关完整列表,请参阅 KvikIO 运行时设置。
接下来,检查 GDS 平台和 cuFile 配置:
$ /usr/local/cuda-13.3/gds/tools/gdscheck.py -p 2>&1 | less -R
输出列出了已安装的 GDS 组件、受支持的文件系统、已检测的 GPU 和活动的 cuFile 配置。图 2 显示了如何检查本教程中使用的 KvikIO 和 GDS 配置。
也可以在 Python 中更改 KvikIO 设置。例如,defaults.set 接受字典一次更改多个设置,或接受名称和值以更改一个设置:
defaults.set({"task_size": 1024**3, "num_threads": 8})
defaults.set("compat_mode", kvikio.CompatMode.OFF)
第 3 步:将文件读入 GPU 显存
接下来,在运行 Python 示例之前创建一次输入文件。以下命令使用直接 I/ O 写入包含随机数据的 1 GiB 文件,并将其刷新到存储中:
$ dd if=/dev/urandom \
    of=/mnt/nvme1/kvikio-tutorial/kvikio-example.bin \
    bs=1M count=1024 \
    oflag=direct conv=fsync \
    status=progress
以下程序会在 GPU 显存中分配 1 GiB CuPy 数组,并将其作为目标缓冲区提供给 KvikIO:
from pathlib import Path
import cupy as cp
import kvikio

file_path = Path(
    "/mnt/nvme1/kvikio-tutorial/kvikio-example.bin"
)

# Allocate a GPU buffer large enough to hold the file.
gpu_buffer = cp.empty(
    file_path.stat().st_size,
    dtype=cp.uint8,
)

# Read the file into the GPU buffer.
with kvikio.CuFile(file_path, "r") as file:
    bytes_read = file.read(gpu_buffer)

# Validate that 1 GiB was read.
assert bytes_read == gpu_buffer.nbytes
上下文管理器会打开文件并完成对 GPU 显存的读取。虽然返回值确认已读取完整文件,但无法识别底层数据路径。
第 4 步:确定数据路径
验证任何基于 cuFile 的应用程序使用的数据路径的方法之一是观察 cuFile 每个进程的运行时统计数据。可以通过设置 CUFILE_STATS_LEVEL=3 来启用这些统计数据,然后在进程保持活动状态时使用 gds_stats 进行检查。
在此 KvikIO 示例中,环境变量将设置范围保持为单次运行,但也可以在 cufile.json 中进行配置。
$ CUFILE_STATS_LEVEL=3 python3 -i read_with_kvikio.py
以交互方式运行 Python 可使进程在读取后保持活动状态,从而允许 gds_stats 检查其累积计数器。
图 3 演示了此工作流程。在每个 GPU 输出中,nvfs 会统计代表通过 nvidia-fs 内核模块所走路径的操作,而 posix 则会统计由 cuFile 兼容性路径处理的操作。
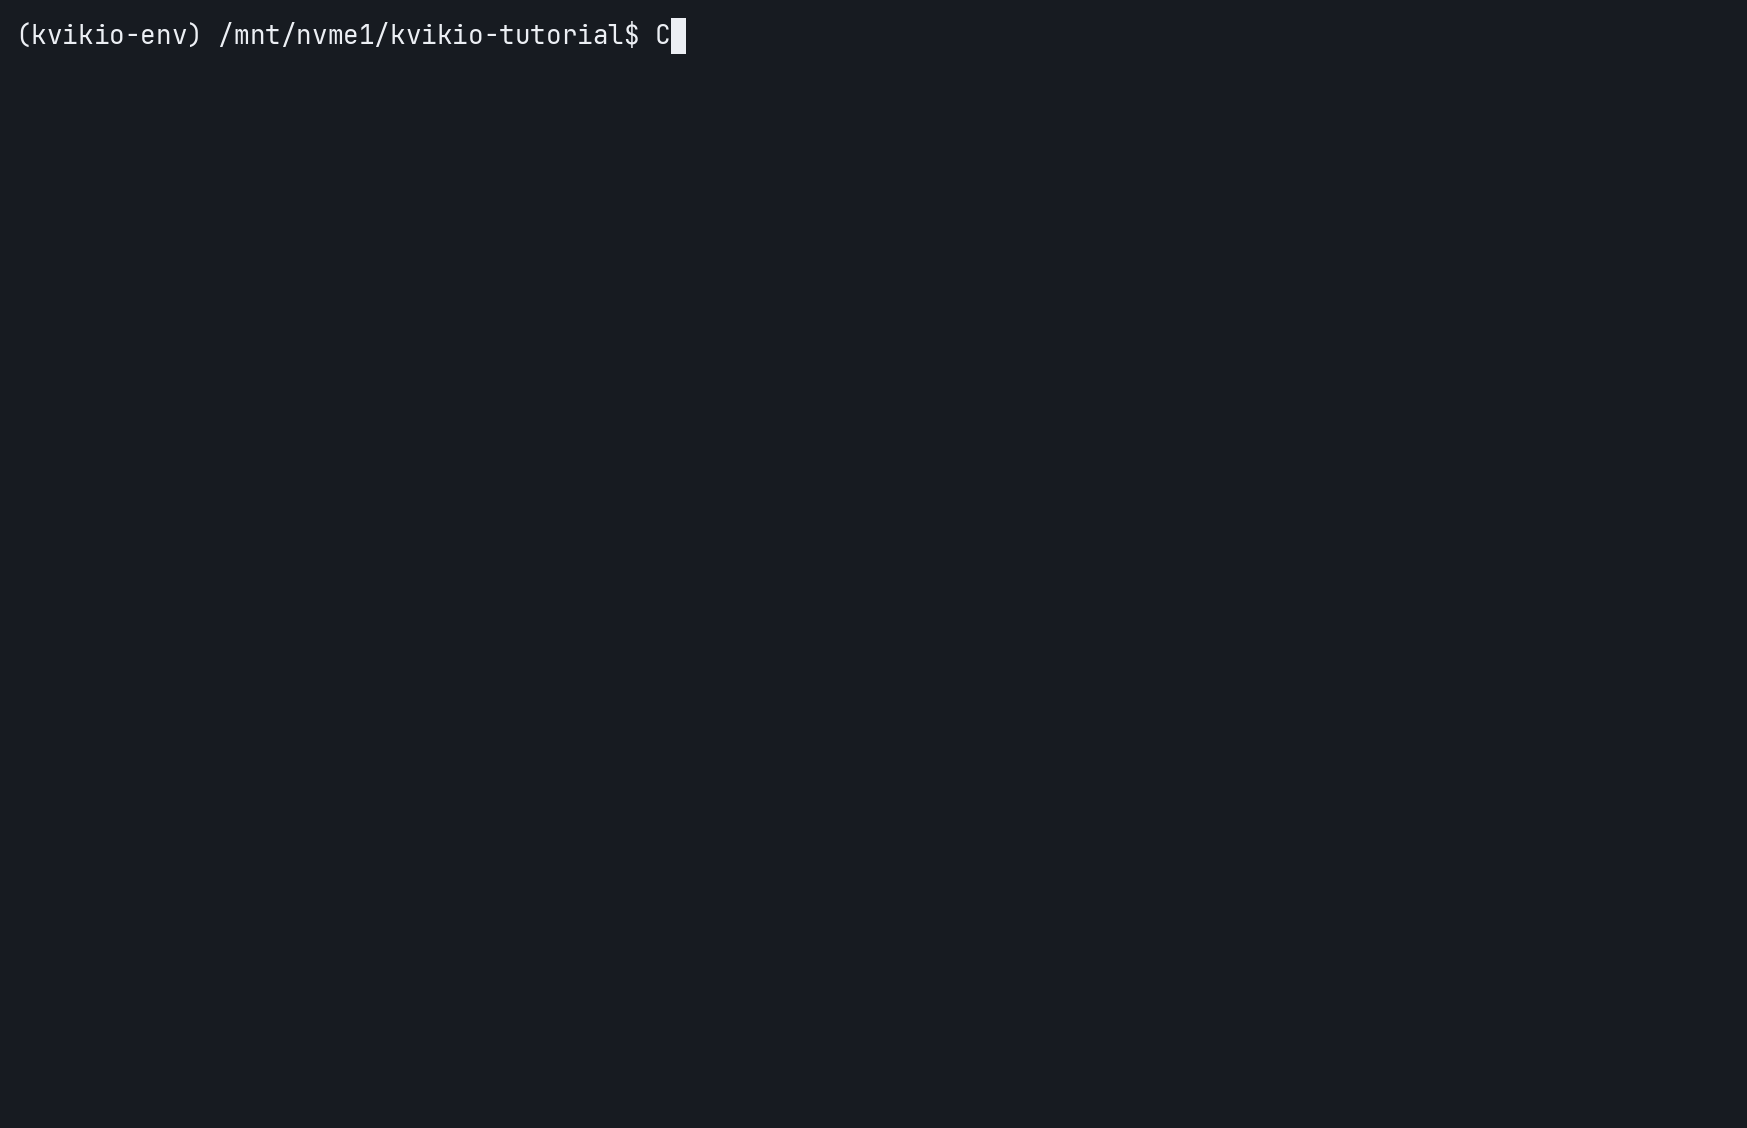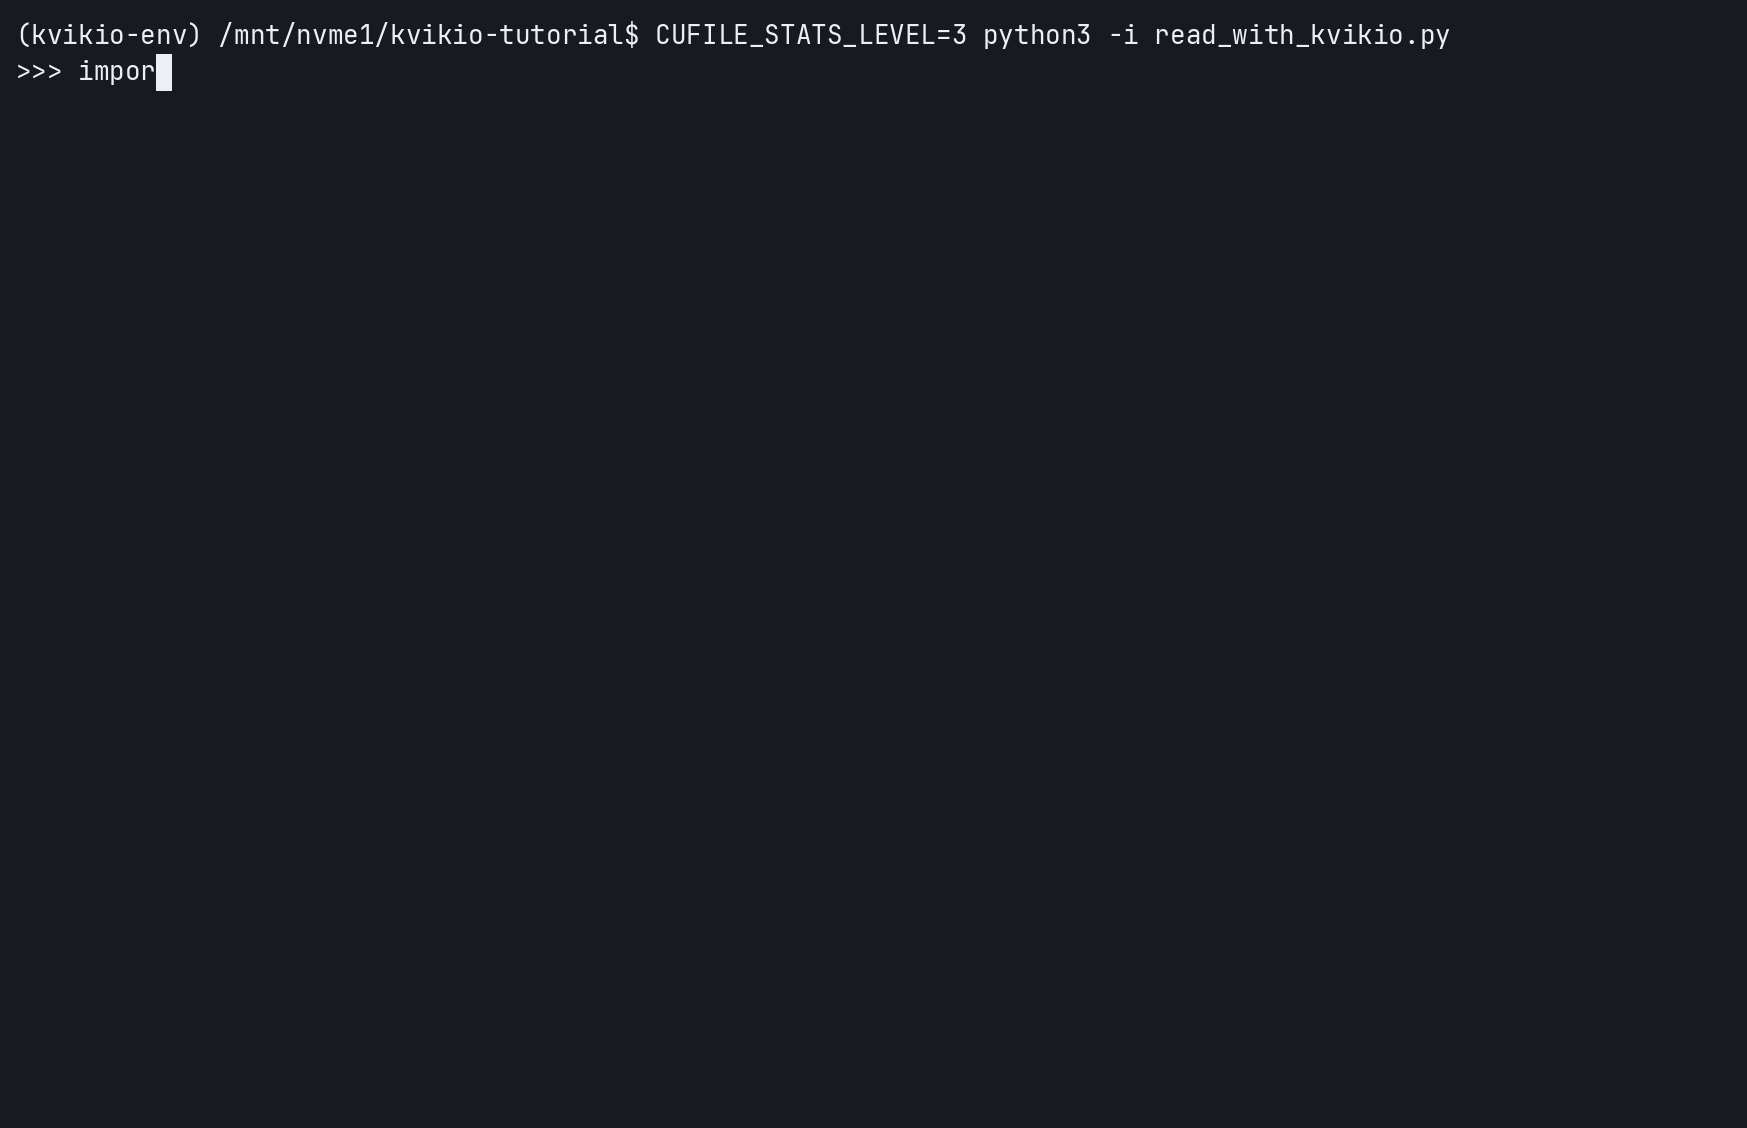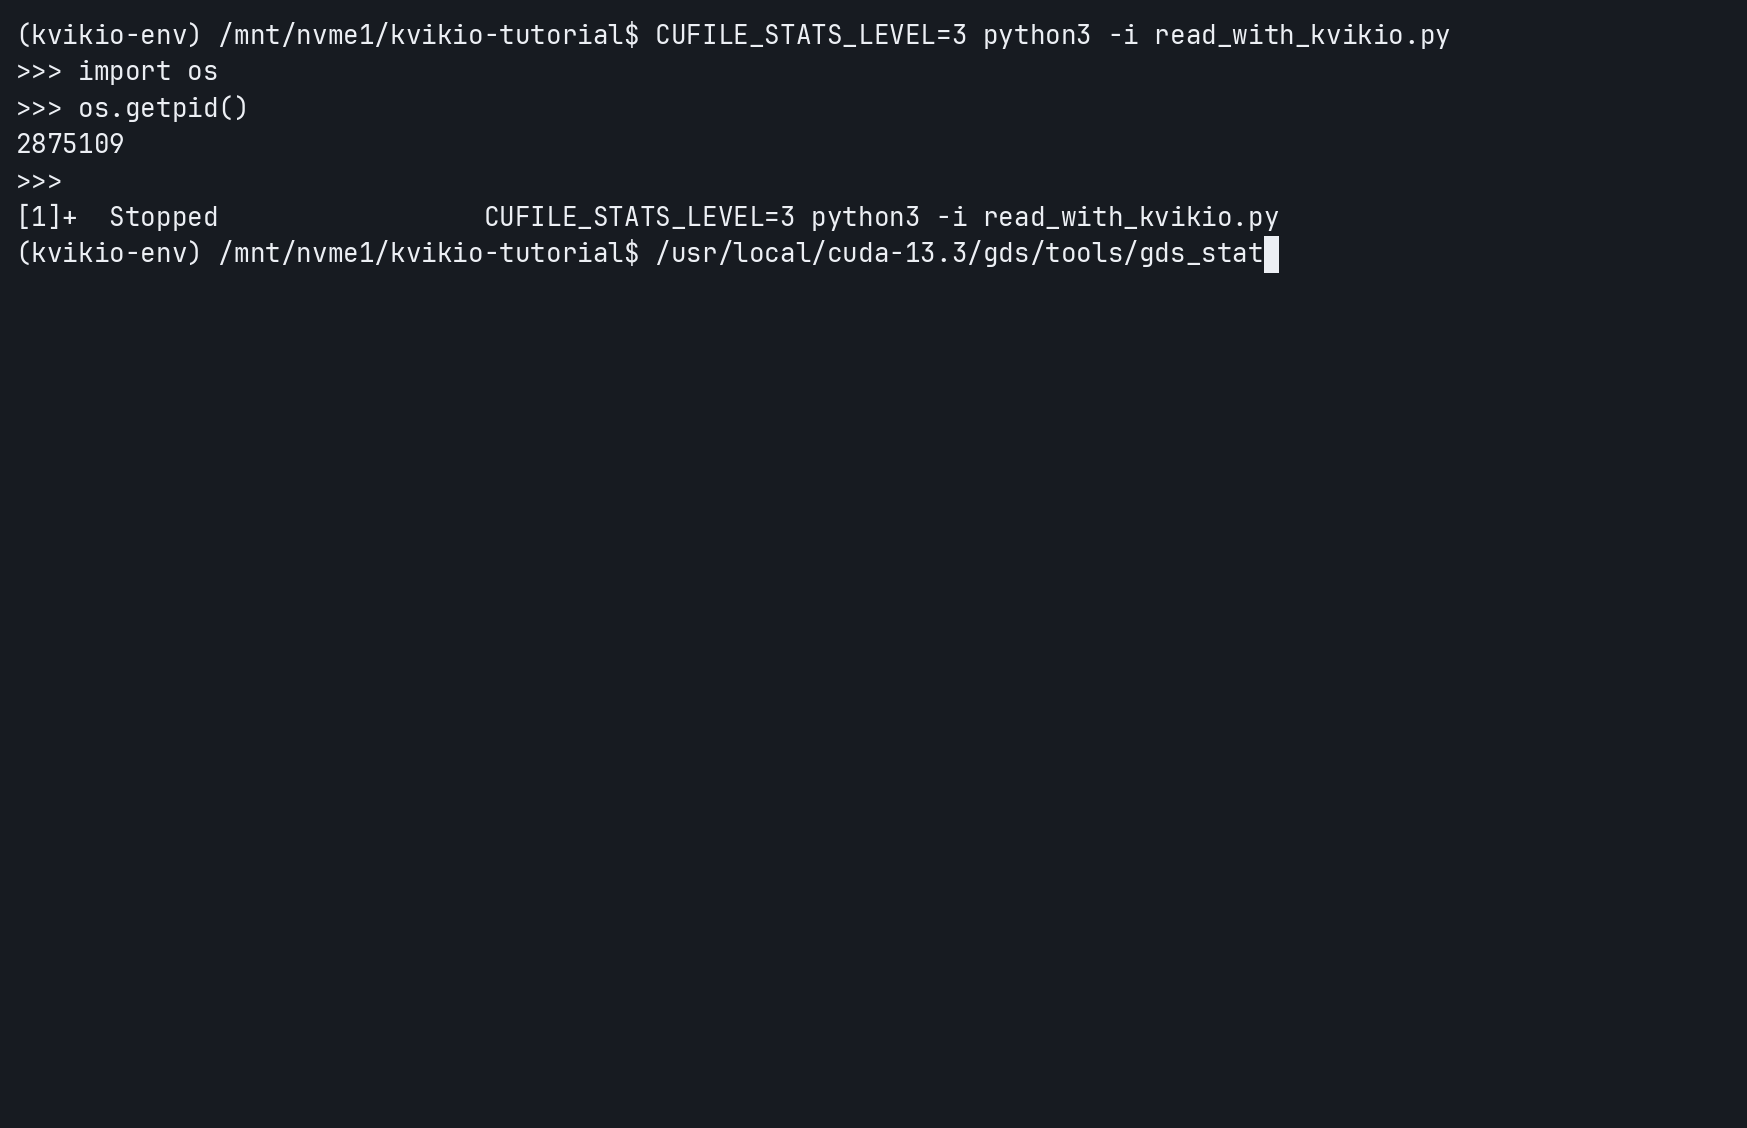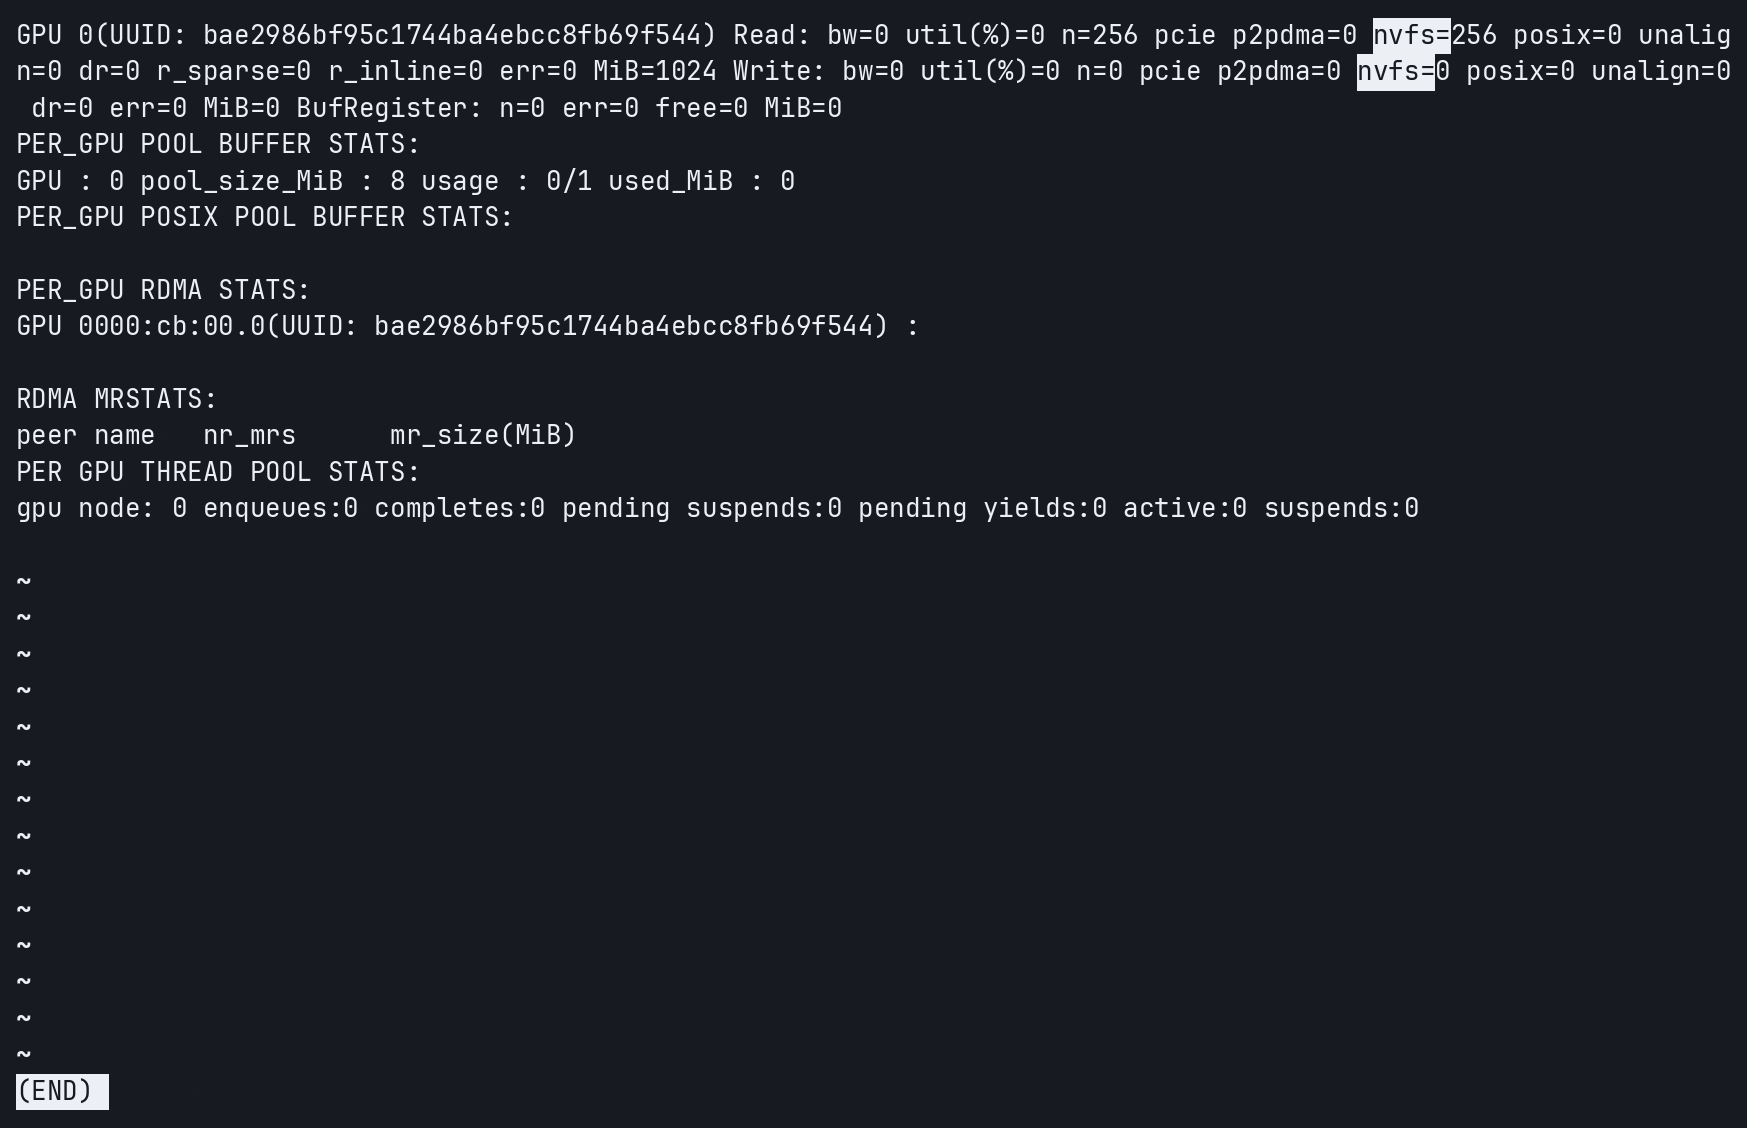
KvikIO 默认的 4 MiB 任务大小将 1 GiB 请求划分为 256 次读取操作。每个 GPU 的统计数据报告为 n=256、nvfs=256 和 posix=0,其中显示 256 项操作均使用 nvidia-fs 路径。
第 5 步:比较可用路径
可以使用不同的设置重复相同的读取,以演示两个控制层。首先,要求 KvikIO 使用 cuFile:
$ CUFILE_STATS_LEVEL=3 \
    KVIKIO_COMPAT_MODE=off \
    python3 -i read_with_kvikio.py
在教程系统上,gds_stats 报告 nvfs 运算,确认 cuFile 选择了加速路径。接下来,强制 cuFile 使用其兼容性路径:
$ CUFILE_STATS_LEVEL=3 \
    KVIKIO_COMPAT_MODE=off \
    CUFILE_FORCE_COMPAT_MODE=true \
    python3 -i read_with_kvikio.py
KvikIO 仍在调用 cuFile,但操作现在显示在 posix 而不是 nvfs 下。最后,KvikIO 兼容性模式完全绕过 cuFile:
$ KVIKIO_COMPAT_MODE=on \
    python3 read_with_kvikio.py
在这种情况下,KvikIO 通过 CPU 暂存的 POSIX 后端执行读取,因此 cuFile 不会记录操作。下一节将探讨控制请求执行的 cuFile 设置。
第 6 步:读取 KvikIO 的 cuFile 配置
在 KvikIO 选择其 cuFile 路径后,cuFile 会应用另一组控件来确定请求的执行方式。这些控件在 cufile.json 中定义,并且独立于 KvikIO 运行时设置运行。
请求分解和并行执行
KvikIO 和 cuFile 都可以将大型运算分割成较小的部分。KvikIO 首先应用 KVIKIO_TASK_SIZE,由 KVIKIO_NTHREADS 控制这些任务的调度方式。cuFile 路径上的每个任务都会成为单独的 cuFile 请求。cuFile 收到其中一个请求后,其执行设置将确定是否可以再次分割该请求,并使用 cuFile 内部线程池进行处理。以下 cuFile 设置可控制此行为:
| 设置 | 目的 |
|---|---|
execution.parallel_io |
启用 cuFile 内部并行处理。 |
execution.max_io_threads |
限制每个 GPU 队列中可用的 cuFile 工作线程数量。 |
execution.min_io_threshold_size_kb |
为内部调度组件设置目标最小尺寸;最后的剩余部分可能较小。 |
execution.max_request_parallelism |
限制 cuFile 为一个请求准备的并行性量。 |
execution.max_io_queue_depth |
限制内部队列中待处理工作项的数量。 |
1 GiB 读取,分步
此处使用的配置有四个 cuFile 工作线程,max_request_parallelism 设置为四个,min_io_threshold_size_kb 设置为 8192 (8 MiB) 。使用 KvikIO 默认的 4 MiB 任务大小,1 GiB 读取将成为 256 个 cuFile 请求。cuFile 会处理每个 4MiB 请求。这是在之前的统计数据中生成 nvfs=256 的运行。
如果将 KVIKIO_TASK_SIZE 设置为 1 GiB,KvikIO 会向 cuFile 发送一个大型读取请求。CuPy 目标未在 cuFile 中明确注册,因此 cuFile 使用其未注册的缓冲区调度路径。它将请求限制为最小 ( 4 个工作线程,4 个最大请求并行) = 4 个部分。
通过四种方式除以 1 GiB,每块即可得到 256MiB,已经超过了 8MiB 的 min_io_threshold_size_kb。由于队列中有空间,cuFile 会将三个部分分配给工作者,在调用线程上处理第四个部分,然后等待它们完成。
这些 256 MiB 部件是计划工作的单位,而非单个存储传输。由于目标缓冲区未注册用于存储 DMA,因此 cuFile 会读取已注册的 GPU 弹跳缓冲区,并将数据复制到目标缓冲区。从 GDS 1.17 开始,这些反弹缓冲区可配置为石板。此配置中的 nvidia-fs 路径使用不超过 16MiB 的板,因此每个 256MiB 块都通过较小的传输进行处理。8 MiB 调度目标未设置其传输大小。
8 MiB 拆分目标至关重要
在此配置中,execution.min_io_threshold_size_kb 设置为 8192 (8 MiB) 。该目标不会更改 1 GiB 拆分,但会影响 16 MiB cuFile 请求。四个相等的部分各 4MiB,因此 cuFile 会调度两个 8MiB 部分。KvikIO 必须为 cuFile 使用至少 16 MiB 的任务大小,才能完整地接收该请求。
适用于数据科学的 NVIDIA CUDA-X 中的 KvikIO
KvikIO 是 NVIDIA CUDA-X 数据科学库 (以前称为 RAPIDS) 的一部分。其开发与最初为 NVIDIA cuDF GPU DataFrame 库构建的 GDS 集成密切相关,其中并行 cuFile 读取加速的 Parquet 和 ORC 摄取。该设计后来被整合到 KvikIO 中,基于 cuDF 最初的 GDS 数据提取工作。
此后,KvikIO 一直与 GDS 在cuCIM 数字病理学工作流程一起使用,并在cuPhoton xDataReader中用于科学图像分析,而相关的GPU 加速的 Presto 工作则显示了 GDS 在数据分析工作负载中的优势。这些示例共同展示了 KvikIO 作为面向应用程序的 I/ O 层在 GDS 提供的存储加速方面的更广泛作用。
开始使用 NVIDIA KvikIO
本教程演示了如何将数据读入 GPU 显存,并使用三级 GDS cuFile 统计信息来区分加速 nvidia-fs 路径和 CPU 暂存兼容性路径。这些路径决策对于使用 KvikIO 进行许多 I/ O 操作的 cuDF 等热门库非常重要。
要点在于,KvikIO 和 cuFile 会做出单独的决策。KvikIO 选择是否调用 cuFile,而 cuFile 则决定最终传输路径和执行策略。通过了解这些层,应用能够了解 I/ O 的路径,并调整对其工作负载至关重要的设置。
准备好开始了吗?在支持 GDS 的系统上运行本文中介绍的 KvikIO Python 示例。如需了解更多示例,请在 MagnumIO GDS 示例目录中探索 C++ 和 Python KvikIO 代码。使用 gds_stats 检查读取是否显示在 nvfs 或 posix 下,然后对您自己的 KvikIO 工作负载应用相同的验证。
