

边缘 AI 应用通常需要在有限的计算和功耗预算内运行多个神经网络。NVIDIA 深度学习加速器 (DLA) 平台提供用于深度学习推理的专用硬件。在 NVIDIA Jetson AGX Orin 上,DLA 可执行受支持的神经网络运算,从而允许应用从 GPU 中卸载推理工作。这可以提高能效,并为其他应用程序任务保留 GPU 容量。
NVIDIA cuDLA 是用于管理此加速器执行的运行时 API。应用程序使用它来创建 DLA 设备、加载编译的网络、注册内存缓冲区以及提交推理任务。cuda.bindings.cudla 模块将这些 API 直接公开给 Python,因此开发者可以将 DLA 执行集成到其应用中,而无需编写 C++ 代码来管理运行时。
本文使用图像分类示例介绍 Jetson AGX Orin 上的推理生命周期。它简要介绍了安装模型并将其编译为可加载的 DLA,然后遵循从创建设备和加载网络到管理缓冲区、同步执行和读取输出的执行过程。该示例还展示了 GPU 和 DLA 阶段如何在单个 Python 应用程序中协同工作。
cuDLA 如何适应 Python 应用
DLA 是固定功能加速器。这意味着它可以高效执行现代神经网络架构中常见的固定运算,例如卷积和池化。其支持的层数不如 GPU 多,但它仍然支持许多热门神经网络架构中使用的各种层。如需详细了解何时以及为何使用 DLA,请参阅 NVIDIA Jetson Orin 上的深度学习加速器入门。
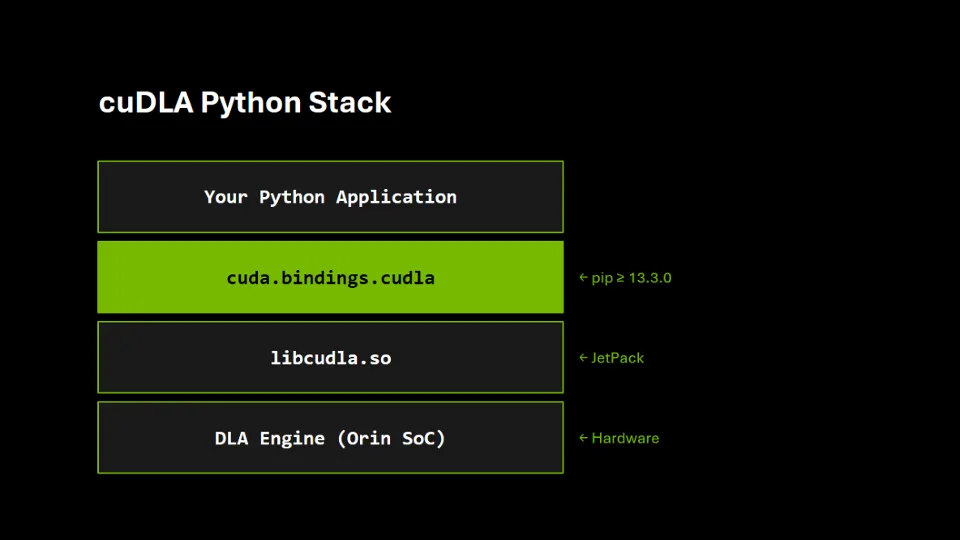
cuda.bindings.cudla 是在 cuDLA C++ API 上由 Cython 生成的纤薄 Python 层,是 CUDA Python 项目的一部分,已在 cuda-bindings 13.3.0 中引入,可用于混合模式工作流。它为混合模式工作流提供了 13 种函数、9 种数据类型和 8 种枚举,其中 CUDA 流负责协调 DLA 执行与 GPU 工作。在 Jetson Orin 上, NVIDIA JetPack 提供底层 libcudla.so 运行时。
Python 绑定将该运行时直接显示给您的应用,而推理则在 DLA 硬件上执行。这通过允许运行时管理和推理编排保留在 Python 中,对现有的 C++ 工作流进行了补充。图 1 显示了 cuda.bindings.cudla 在堆栈中的合适位置。虽然本文重点介绍 Jetson,但 NVIDIA RTX Spark 首次将 DLA 推理引入主流 Windows AI 开发者笔记本电脑,将 cuDLA 扩展到了嵌入式和机器人领域之外。cuda.bindings.cudla API 在两个平台上完全相同,因此本文中与 cuDLA API 相关的所有内容也直接适用于 RTX Spark。
cuda.bindings.cudla预备知识和安装
如果您使用的是运行 JetPack 的 NVIDIA Jetson Orin,libcudla.so 随附 JetPack 安装,并可通过绑定自动发现。DLA 运行时本身无需额外安装,既无需单独的 cuDLA SDK,也无需额外的运行时库。
安装 cuDLA Python 绑定:
pip install "cuda-bindings>=13.3.0"
JetPack 默认 Python 版本可能低于 3.10,这是最低要求版本。如有需要,请安装 Python 3.12,使用“死蛇 ( deadsnakes) ”中的 PPA:
sudo apt update && sudo apt install -y software-properties-common
sudo add-apt-repository -y ppa:deadsnakes/ppa
sudo apt update && sudo apt install -y python3.12 python3.12-venv python3.12-dev
python3.12 -m venv ~/dla-env
~/dla-env/bin/pip install "cuda-bindings>=13.3.0"
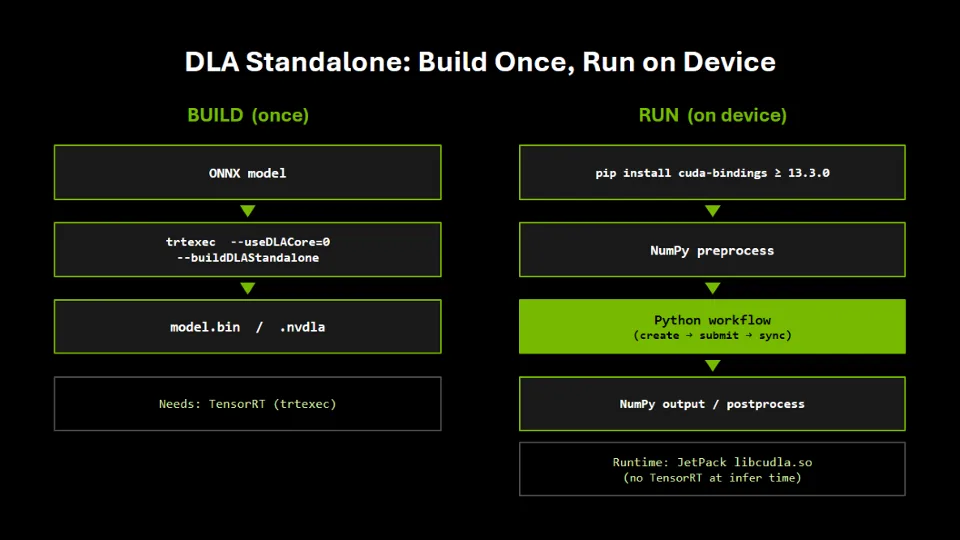
您只需使用 TensorRT ,即可将经过训练的模型编译为可加载的 DLA 。要运行现有的可加载组件,您只需要附带 JetPack 的 libcudla.so。
编译可加载的 DLA
可加载的 DLA 是 TensorRT trtexec 工具生成的二进制构件。它以 DLA 硬件可以直接执行的格式对经过训练的网络进行编码。此编译示例面向 TensorRT 11.4.1 和 CUDA 13.4 Update 1 (在 Jetson AGX Orin 上运行 JetPack 7.2.2 或更高版本) 。对于可加载的 FP16 CHW16,使用具有固定输入维度的 FP16 类型的 ONNX 模型,请使用以下内容:
trtexec \
    --onnx=your_model_fp16.onnx \
    --useDLACore=0 \
    --inputIOFormats=chw16 \
    --outputIOFormats=chw16 \
    --memPoolSize=dlaSRAM:1 \
    --saveEngine=model.bin \
    --buildDLAStandalone
关键标志如下:
--useDLACore=0针对 Orin 上的首个 DLA 引擎--buildDLAStandalone生成可加载的原始 DLA,在推理时不需要 TensorRT- I/ O 格式选项选择 CHW16 布局
TensorRT 11 的精度来自模型的张量类型;不再支持 --fp16 和 --int8 。本示例假设输入维度固定,因此省略 --shapes。
这反映了示例当前的 FP16 路径和 TensorRT 11 标志更改。
并非每个网络层都与 DLA 兼容,因此通常需要对 ONNX 图进行预处理,以修剪与 DLA 不兼容的头层和尾层。下一节中的 Python 工作流适用于您生成的任何 .bin 或 .nvdla 文件。图 2 显示了一次性构建步骤与设备端运行时之间的分割。
Python 工作流程
对于 CUDA 和 cuDLA 调用,三种导入涵盖所有内容:
import numpy as np
from cuda.bindings import cudla
from cuda.bindings import driver, runtime
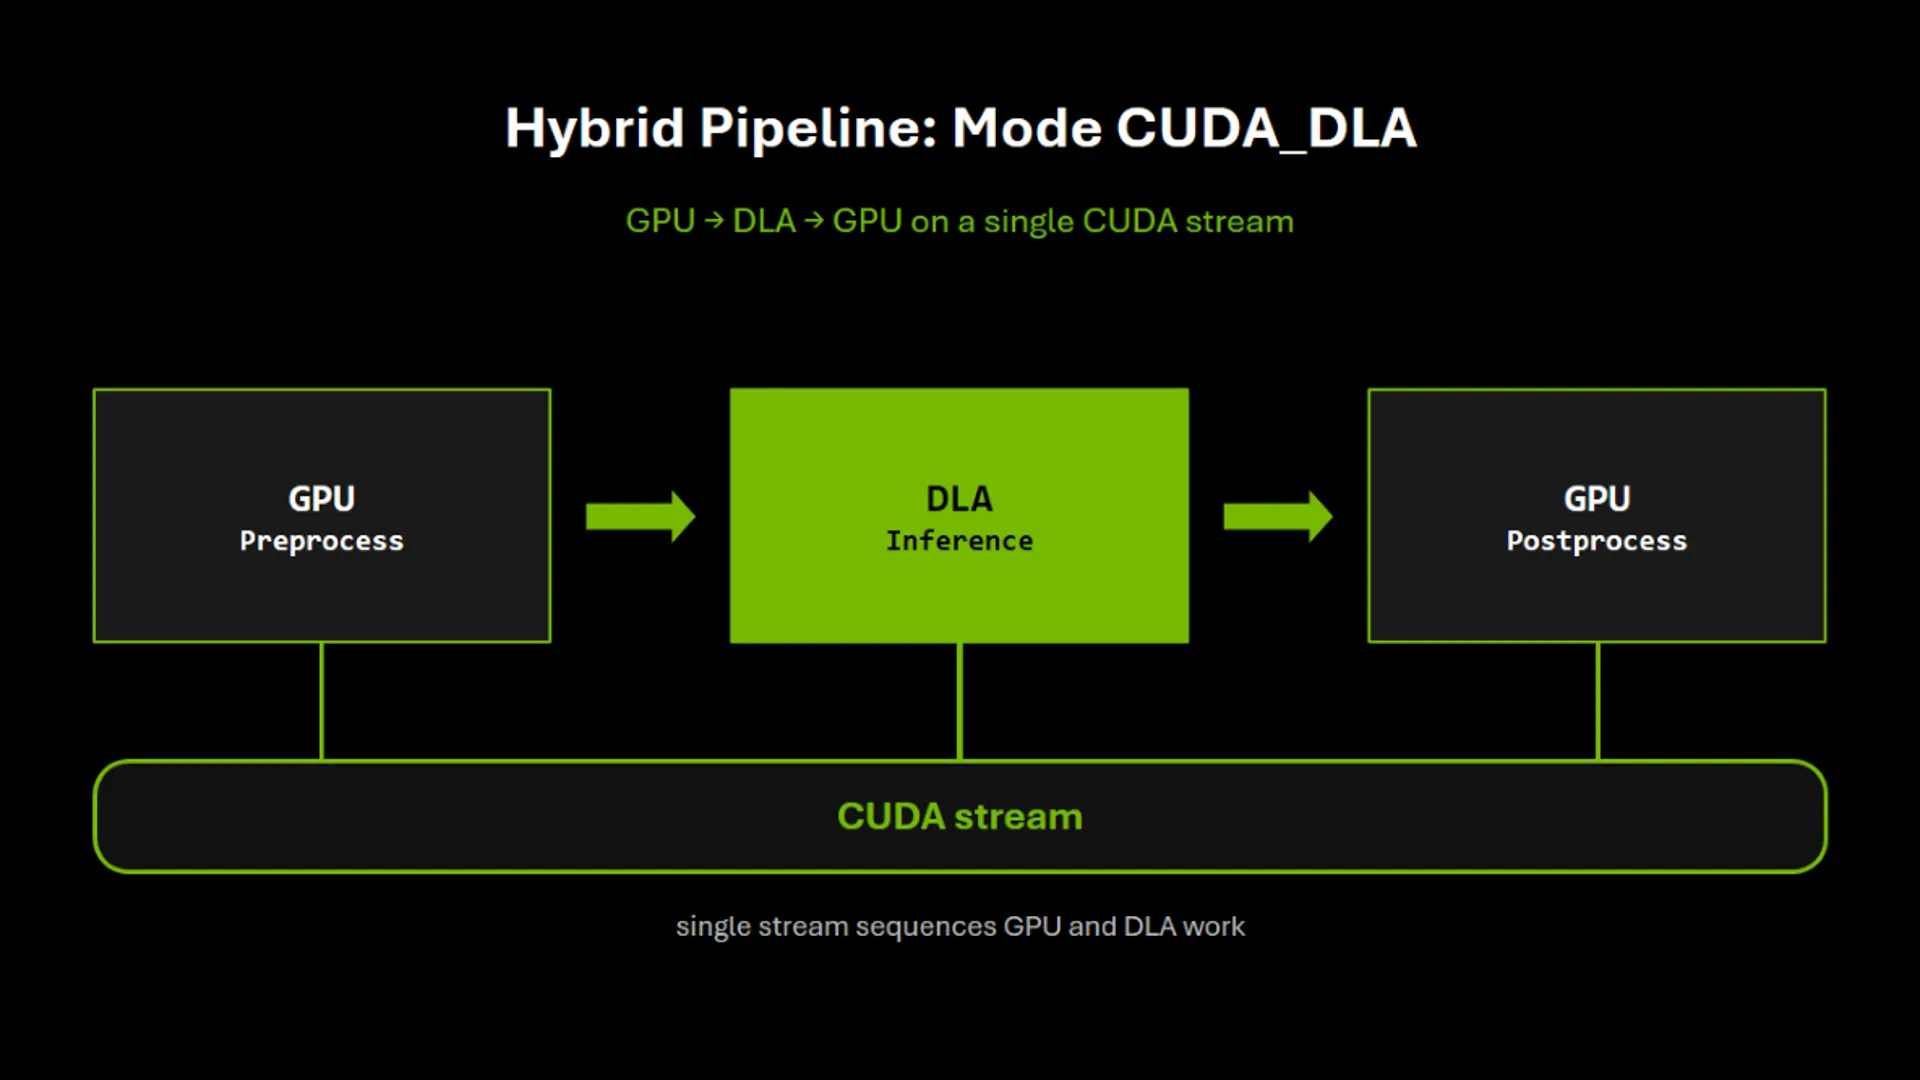
cudla 是新模块。 driver 和 runtime 是 CUDA 驱动程序和运行时 API 的现有 cuda-python 绑定,此处用于流管理、内存分配和数据传输。一切都通过单个 CUDA 流运行,而 CUDA 流是混合模式下 DLA 和 GPU 工作的协调点。
第 1 步:初始化 CUDA 并创建 DLA 设备
cudla.Mode.CUDA_DLA 选择混合模式,即通过 CUDA 流提交 DLA 任务。这将启用 GPU-DLA 工作流:预处理核函数、DLA 推理和后处理核函数均可在同一流上排队并按顺序执行。
driver.cuInit(0)
runtime.cudaSetDevice(0)

cudla_device = cudla.create_device(0, int(cudla.Mode.CUDA_DLA))
此版本不支持独立模式 (需要 NvSci 缓冲区和同步基元) 。如果您提出要求, create_device 会引发 CudlaError(ErrorUnsupportedOperation)。
第 2 步:加载可加载内容
将可加载的 Python bytes 对象直接传递给 module_load_from_memory 。没有文件路径或文件系统句柄,只有原始字节,同样易于从内存映射文件、嵌入式资源或网络流中加载。
with open("model.bin", "rb") as f:
    loadable_data = f.read()

module_handle = cudla.module_load_from_memory(
    cudla_device, loadable_data, len(loadable_data), 0
)
第 3 步:内省加载的模块
在分配内存之前,请查询该模块,以确切了解其期望的张量:
num_inputs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.NUM_INPUT_TENSORS)
)
num_outputs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.NUM_OUTPUT_TENSORS)
)
input_descs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.INPUT_TENSOR_DESCRIPTORS)
)
output_descs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.OUTPUT_TENSOR_DESCRIPTORS)
)
每个描述符都是一个 cudla.ModuleTensorDescriptor ,具有缓冲区大小 ( size_ ) 、张量形状 ( n, c, h, w ) 、名称、数据格式和步长的属性。所有后续分配调用均由 desc.size_ 驱动,且应用程序中的任何位置都没有硬编码大小。此自检步骤使工作流程与模型无关:无论网络架构如何,相同的代码路径均可处理任何可加载的内容。
第 4 步:分配 GPU 显存
input_gpu  = runtime.cudaMalloc(input_descs[0].size_)[1]
output_gpu = runtime.cudaMalloc(output_descs[0].size_)[1]
CUDA 驱动程序和运行时调用会返回状态代码,将其作为元组的第一个元素。完整示例会将每个此类调用封装在一个辅助程序中,该辅助程序会检查返回的状态并在发生故障时进行提升。为实现可读性,此处删除了这些代码片段,但错误检查在产品级代码中至关重要。对于具有多个输入或输出的模型,请对 input_descs 和 output_descs 进行迭代,并为每个张量分配一个缓冲区。每个描述符上的 size_ 字段提供确切的字节数量。
第 5 步:使用 cuDLA 注册 GPU 缓冲区
这是 cuDLA 独有的步骤。GPU 缓冲区必须先在 DLA 设备中注册,然后才能显示在任务中。注册会返回硬件用于访问缓冲区的 DLA 侧句柄:
input_registered  = cudla.mem_register(
    cudla_device, int(input_gpu), input_descs[0].size_, 0
)
output_registered = cudla.mem_register(
    cudla_device, int(output_gpu), output_descs[0].size_, 0
)
int() 类型转换会从 CUDA 内存对象中提取原始指针。 cuda.bindings 返回不透明的句柄对象,而 int() 则是将其传递给需要指针的 C 级 API 的方式。
第 6 步:准备输入数据并复制到 GPU
预处理 (对值进行归一化、匹配预期的张量步长和数据格式) 是脚本中唯一特定于模型的代码。张量描述符 stride、data_format 和 data_type 字段确切地告诉您如何布局数据。对于多输入模型,为每个输入缓冲区重复复制。无论可加载块内部是什么网络,此块之前和之后的所有内容都相同。
stream = driver.cuStreamCreate(driver.CUstream_flags.CU_STREAM_NON_BLOCKING)[1]

# Preprocess your input into a numpy array `input_cpu`
# matching the tensor layout described by input_descs[0] ...

runtime.cudaMemcpyAsync(
    input_gpu, input_cpu, input_descs[0].size_,
    runtime.cudaMemcpyKind.cudaMemcpyHostToDevice, stream
)
runtime.cudaMemsetAsync(output_gpu, 0, output_descs[0].size_, stream)
第 7 步:构建任务并提交
cudla.Task 包装了 cudlaTask C 结构体。将 Python 列表分配给 task.input_tensor 或 task.output_tensor 会自动更新相应的计数字段。 submit_task 会将推理工作排队到 CUDA 流上,并使用同一流上其前后的任何 GPU 核函数对其进行排序。
task = cudla.Task()
task.module_handle = module_handle
task.input_tensor  = [int(input_registered)]
task.output_tensor = [int(output_registered)]
task.wait_events   = 0
task.signal_events = 0

cudla.submit_task(cudla_device, int(task), 1, int(stream), 0)
第 8 步:同步并读取
首次同步将等待 DLA 任务完成。将 output_cpu 分配为描述符字节大小的 Numpy 数组,可为 D2H 复制提供目标缓冲区;第二次同步可确保在读取之前完成传输。
runtime.cudaStreamSynchronize(stream)

output_cpu = np.empty(output_descs[0].size_, dtype=np.uint8)
runtime.cudaMemcpyAsync(
    output_cpu, output_gpu, output_descs[0].size_,
    runtime.cudaMemcpyKind.cudaMemcpyDeviceToHost, stream
)
runtime.cudaStreamSynchronize(stream)
第 9 步:清理
创建的每个句柄都有匹配的销毁调用,包括 DLA 设备、模块、注册内存句柄、GPU 分配和流。
cudla.mem_unregister(cudla_device, input_registered)
cudla.mem_unregister(cudla_device, output_registered)
cudla.module_unload(module_handle, 0)
cudla.destroy_device(cudla_device)
runtime.cudaFree(input_gpu)
runtime.cudaFree(output_gpu)
driver.cuStreamDestroy(stream)
错误处理是 Python 的原生功能
所有 cuDLA API 调用都会在发生故障时提高 cudla.CudlaError ,而不是返回错误代码。异常同时带有数字状态及其人类可读名称:
try:
    device = cudla.create_device(0, int(cudla.Mode.CUDA_DLA))
except cudla.CudlaError as e:
    print(e)  # e.g. "ErrorInvalidDevice (8)"
DLA 工作流自然适合标准 Python 异常处理。我推荐使用 try/finally 进行清理。DLA 设备句柄是不透明的 C 语言资源,不会在垃圾收集时自行释放。在 e.status 上与 cudla.Status 枚举值进行分支,以处理从参数错误 ( ErrorInvalidParam ) 到硬件级故障 ( ErrorDlaErrEngineTimeout ) 的特定故障模式。
结果输出是什么?
cudaStreamSynchronize 返回后, output_cpu 将网络的原始 DLA 输出作为 Numpy 数组保存,可用于任何标准 Python 后处理。如何使用它完全取决于模型,包括分类分数、特征图、边界框坐标。cuDLA Python 层负责处理字节。解释它们的方式与您在任何 Python 推理工作流中编写的方式相同,您可以直接使用 NumPy、PyTorch 或 OpenCV 将其关联起来,而无需离开 Python 进程。
具体而言:对于编译为可加载 DLA 的 ResNet-50 主干,示例输出如下所示:
cuDLA device created: 0x55a1b2c30000
Module loaded: 0x55a5b6c70000
numInputTensors = 1
numOutputTensors = 1
Input 0:  size=..., shape=(1,64,56,56), name=resnetv17_pool0_fwd
Output 0: size=..., shape=(1,2048,7,7), name=resnetv17_stage4_activation2
SUBMIT IS DONE (task queued; completion pending)
Output tensor written to host
示例输出会告诉您可加载对象期望的确切缓冲区大小和张量名称,您的预处理和后处理代码可以直接读取这些大小和张量,而无需对其进行硬编码。同步后, output_cpu 是平面 Numpy 数组;使用 data_type、data_format、stride 解释或重塑该数组,并对 output_descs[0] 中的字段进行调整,然后将其传递到工作流所需的任何下游阶段。
无论采用何种网络架构,从 create_device 到 cudaStreamSynchronize 的工作流程都是相同的。只有张量名称、大小和后处理会发生变化。
最后步骤
cuda.bindings.cudla 模块在 cuda-bindings 13.3.0 中提供。安装它,使用 trtexec 编译一个可加载的文件,然后上述九个步骤可将您从 .bin 文件直接转换为同一板上 Python 中的 DLA 推理结果。
pip install "cuda-bindings>=13.3.0"
枚举、POD 类型和 API surface 的单元测试在 NVIDIA/cuda-python GitHub 存储库中发布,并且完全在没有 DLA 硬件的情况下运行,无需 libcudla.so:
pytest cuda_bindings/tests/cudla/ -v
开始在 Python 中使用 cuDLA
如需了解完整的端到端推理示例、示例输入以及用于准备模型和编译可在本地加载的 DLA 的脚本,请参阅深度学习加速器示例。
如需了解详情,请访问 NVIDIA/cuda-python GitHub 存储库。
