

AI 智能体正在改变软件的构建方式。开发者已经从手动编写每一行代码转变为指导代理编写大部分代码。因此,当前的工作流分为笔记本电脑、云模型 API 和云 VM。
NVIDIA RTX Spark 专为 AI 开发而打造。得益于 NVIDIA GB10 系统级芯片和大容量统一内存,开发者可以在单个 PC 上运行本地编码代理、访问 AI 框架以及编码、测试和部署。
一台计算机进行编码、测试和部署
RTX Spark 笔记本电脑和紧凑型台式机使开发者能够在单台机器上完成所有工作流程。
开发者可以选择在 Windows 中工作,包括与 Microsoft 合作开发的新 Windows 开发者配置,该配置可安装顶级开发框架、将通知静音、增强终端功能,并且可以将任务栏移到一边。或者,他们可以在适用于 Linux 的 Windows 子系统中工作,在那里他们可以访问部署到云时将使用的相同环境和依赖项。这使开发者能够在目标操作系统中完成所有工作,而无需迁移代码。由于 RTX Spark 配备 NVIDIA GPU,开发者可以对 1.5 亿台 RTX PC 以及全球几乎所有基于 NVIDIA GPU 运行的云进行测试并将其部署到最大的本地 AI 用户群。
凭借高达 128GB 的统一显存和 1 petaflop 的 FP4 AI 计算能力,开发者可以在本地运行编码模型,包括 Qwen 3.8 Flash Next,从而减少云编码代理 token 的消耗。
AI 开发所需的性能
开发已从受限于 CPU 的工作负载 (性能主要由 CPU 决定) 转变为受限于 GPU 的工作负载。如今的 AI 开发者需要运行推理来运行其编码智能体并测试其应用;微调和训练模型;是的,仍然需要进行一些编译。
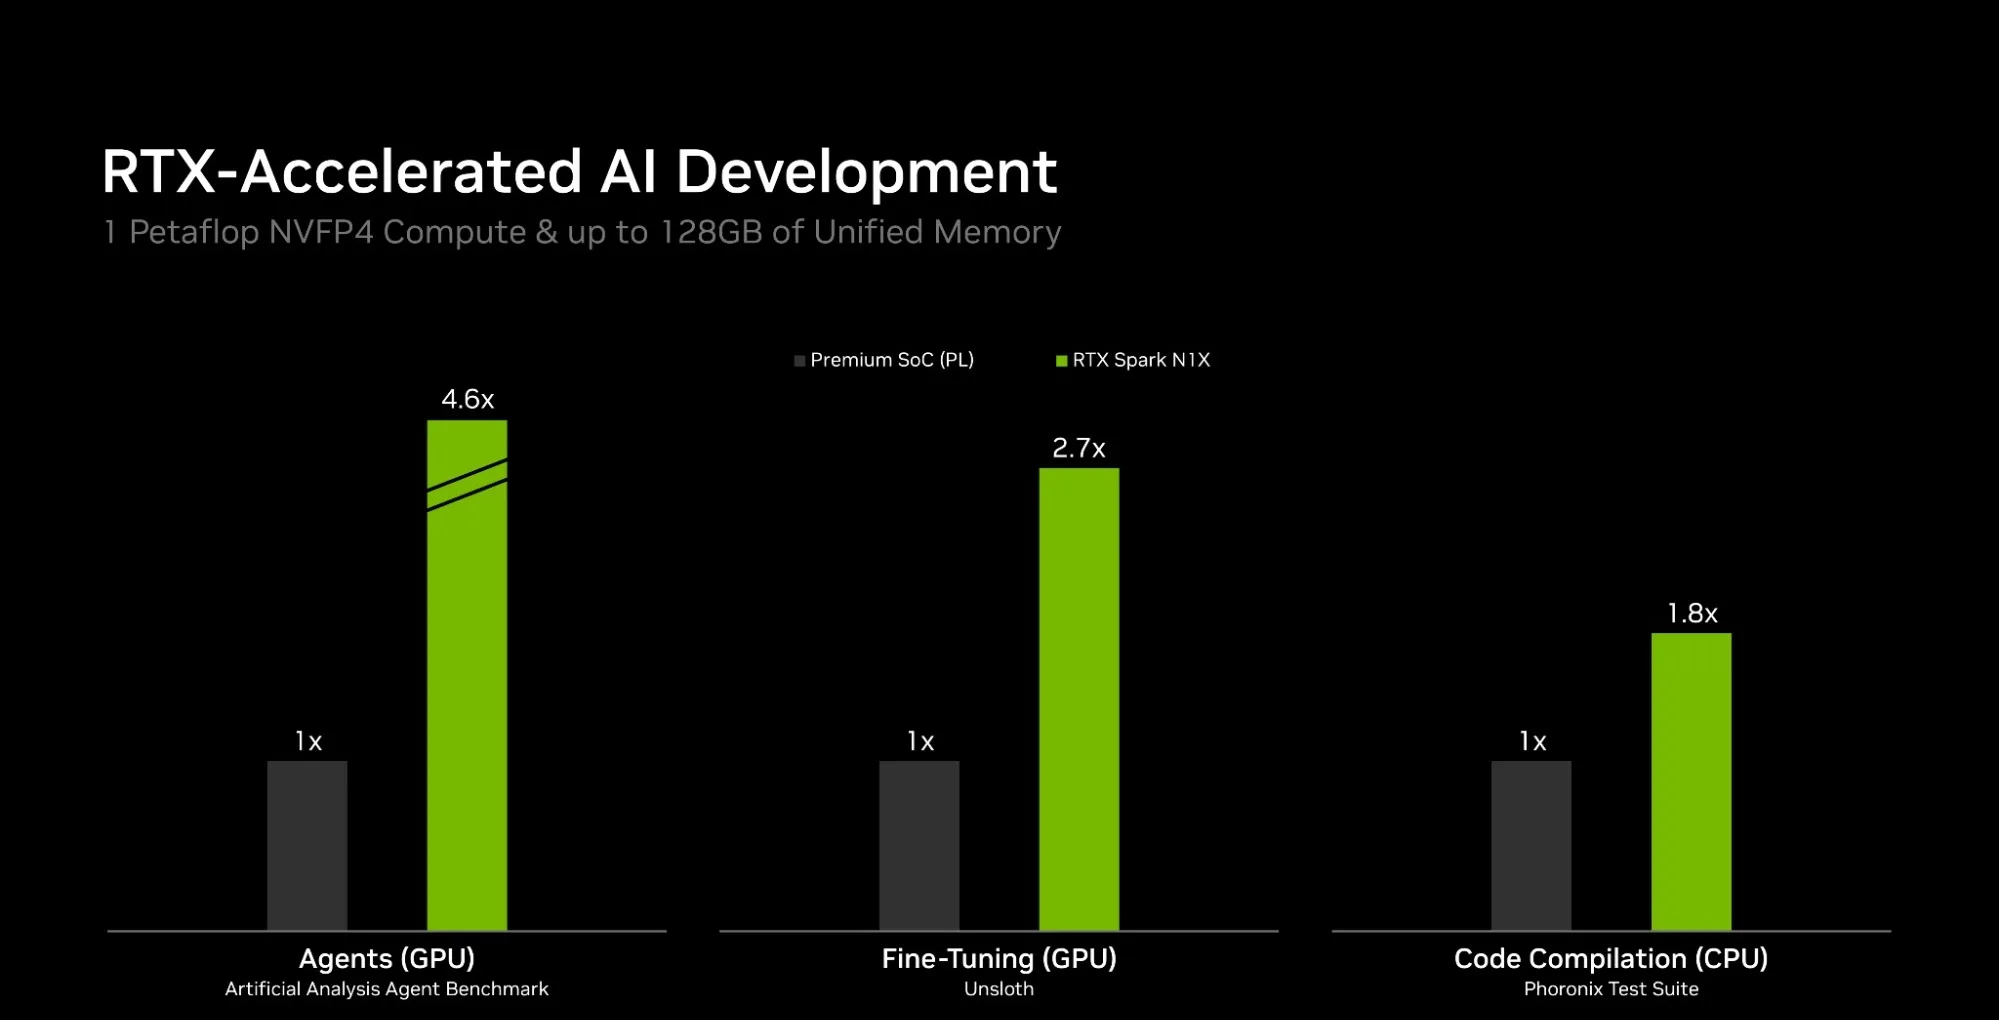
得益于 RTX Spark 中的 NVIDIA Grace CPU 和 Blackwell GPU,这些笔记本电脑和台式机配备了推理、微调和编译所需的所有计算能力。与 Intel 的 Panther Lake 12Xe 相比,RTX Spark 在编码智能体方面的性能提高了 4.6 倍,在微调方面的性能提高了 2.7 倍,在代码编译方面的性能提高了 1.8 倍。
熟悉的软件堆栈,可针对 Windows 进行扩展
NVIDIA 与微软合作,推动 Windows on Arm 开发者格局的发展。社区将与 RTX Spark 一起发布多个新工具,包括首个 PyTorch-CUDA 版本、首个默认情况下原生使用 Python 3.15 的 Python 版本、2000 多个即用型 Conda 软件包,以及适用于超过 97% 的热门 15000 个 Python 软件包的 Arm 兼容版本。
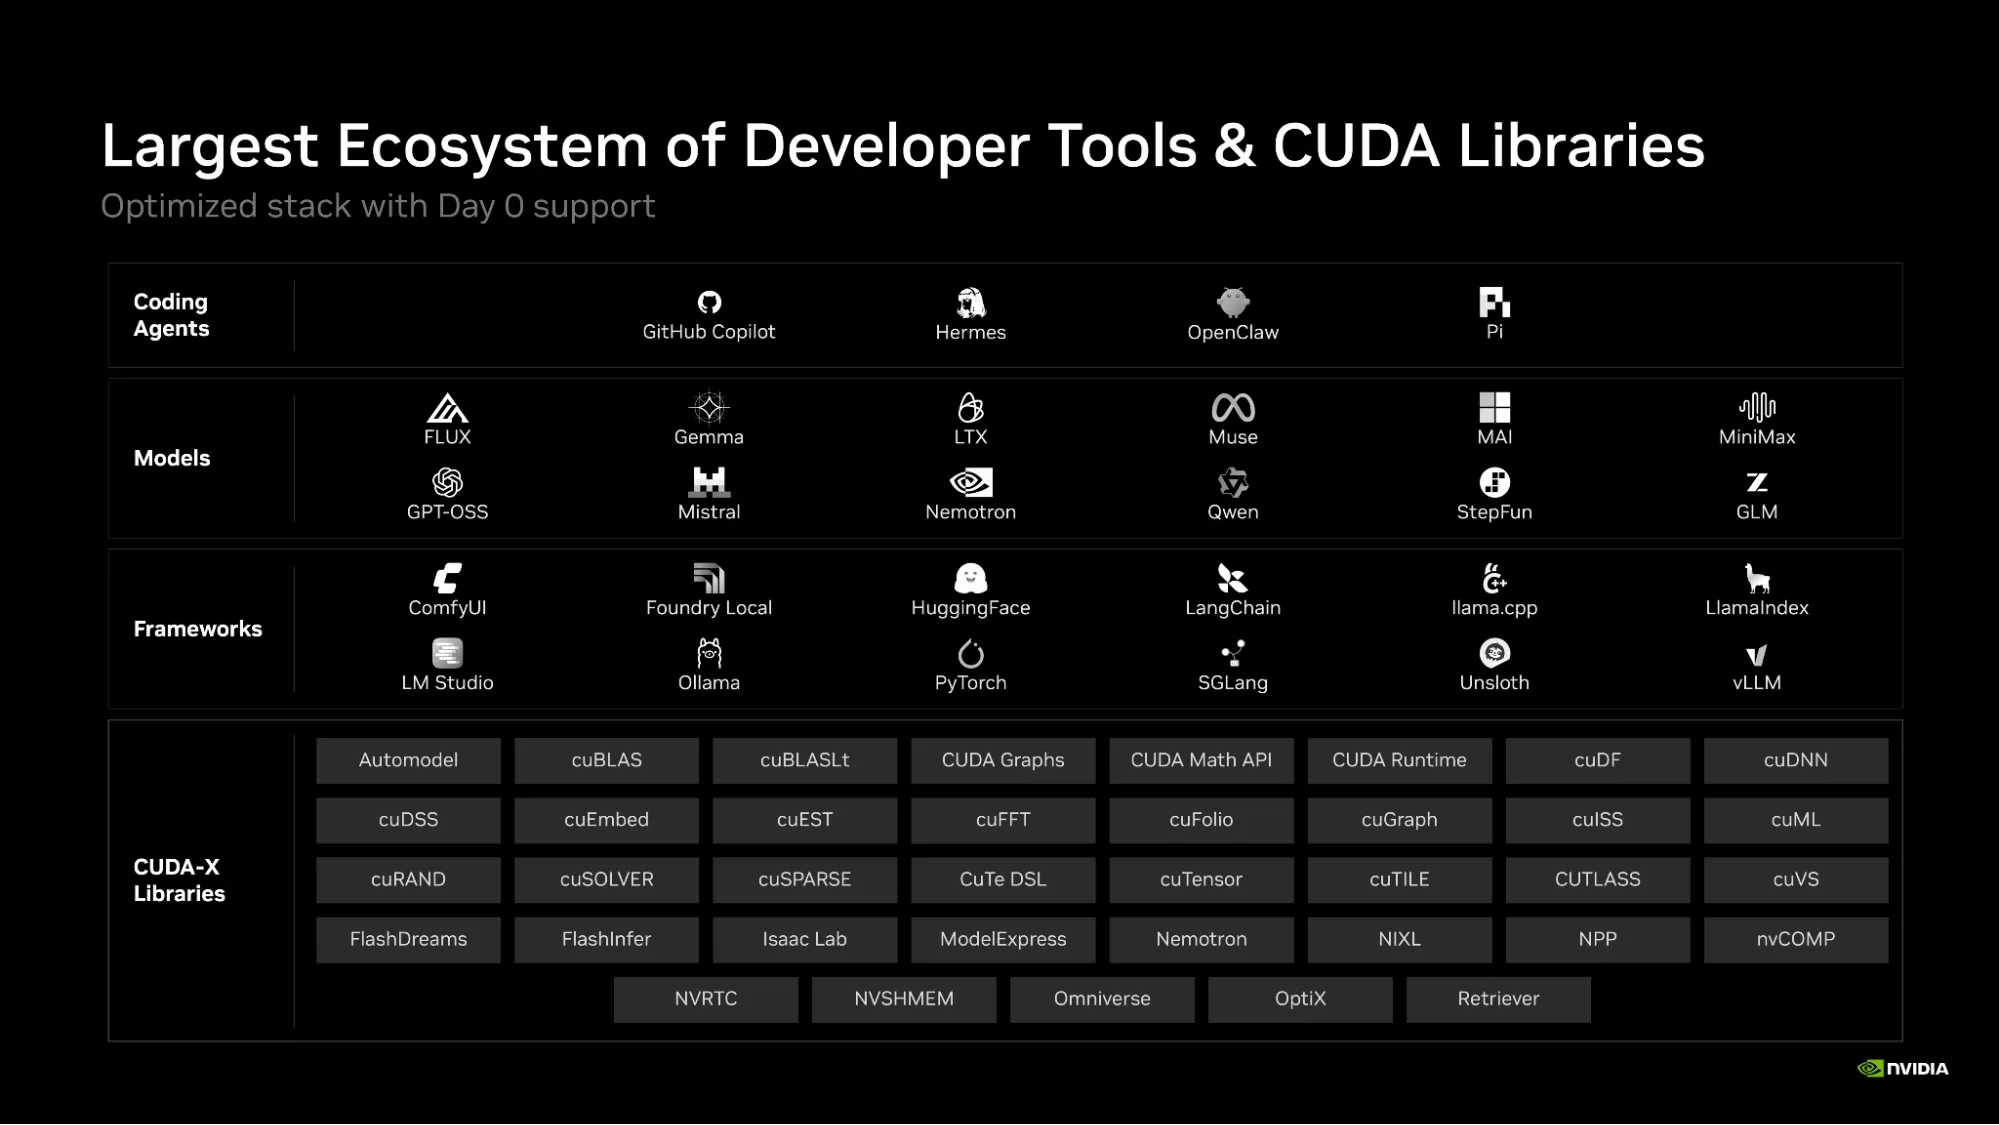
在 NVIDIA 硬件上进行开发的一个关键优势是可以访问庞大的开发者工具生态系统,包括编码智能体、AI 模型和框架。
由于 NVIDIA GPU 是应用最广泛的 AI 开发平台,因此新工具和框架通常从一开始就在 NVIDIA 上运行,而对其他硬件的支持则会在几周后推出。用户还可以使用 NVIDIA CUDA-X 库,包括用于 LLM 加速的 FlashInfer 和用于 AI 模型开发的 NVIDIA NeMo 库工具。
NVIDIA 还提供了一个 NVIDIA 技能库,用于指导智能体如何使用 CUDA-X 库,使开发者能够构建 GPU 加速的应用,而无需非常熟悉 CUDA。
本地编码代理加入 RTX Spark
RTX Spark 设备是本地编码代理的理想之选。NVIDIA 已与包括 GitHub Copilot、Pi、Hermes 和 OpenClaw 在内的顶尖智能体密切合作,对其进行改进并使其更易于使用。
改进包括:
- 使用优化方案无缝部署本地模型
- 借助 NVIDIA OpenShell 和/ 或 Microsoft Execution Containers 增强安全性,实现操作系统级沙盒
- 本地模型和云模型之间的混合提示路由器,这样,如果提示足够好,就会发送给本地模型,或者如果需要,就可以升级到云,从而减少 token 消耗
Microsoft GitHub CoPilot 现在通过 Windows ML 实现无缝的本地 AI,llama.cpp 作为后端支持该功能。提示路由器 HydraFusion 已经升级,也支持本地模型。新的 MAI 1.1 Coding Flash 模型可以在 RTX Spark 上本地运行。
Pi 是一款开源编码代理,具有轻量级终端接口,支持本地和云模型,还针对 RTX Spark 进行了优化。借助其扩展程序、技能和提示模板,开发者可以控制智能体如何融入其工作流程 (从模型选择到可使用的工具) 。
JetBrains 已在 RTX Spark 上为 Junie Local 提供原生支持。编码代理读取代码、编辑文件并运行测试,模型和代码仍保留在机器上。Junie Local 将其上下文窗口调整为 GPU 可用内存,因此 RTX Spark 统一内存 可让其在上下文中保留更多代码、工具输出和对话历史记录。
新的 Nemotron 模型为本地智能体提供了更多选择
Nemotron 3.5 螺栓 74B-A9B 24GB 是专为在 RTX Spark 上运行本地代理而打造的全新 LLM。
此模型是一个 74B 参数、9B 主动参数混合专家 (MoE) 模型,通过 2 位量化和先进的量化感知训练技术将其打包成 24GB,以保持质量。它旨在实现速度和智能之间的最佳平衡,比大多数热门密集模型更快,同时比具有类似内存占用的大多数热门 MoE 模型更智能。
在发布时,用户将能够通过 llama.cpp、vLLM、Ollama、Unsloth 和 LM Studio 运行 Nemotron 3.5 Bolt 74B。它还可以通过 Hermes 和 OpenClaw 等智能体直接访问。
与其他 Nemotron 模型一样,Bolt 74B 是完全开源的模型,包含训练数据、权重和方法,因此开发者可以微调和自定义自己的智能体。
顶级框架现已支持决策模型
决策模型是 AI 开发领域的新突破。它们为 AI 智能体提供了近乎即时的决策方式,而无需漫长的推理循环。从请求分类到选择下一个行动,他们可以选择下一步行动,速度比传统智能体快 200 倍。RTX Spark 和 GeForce RTX GPU 上的 llama.cpp 和 Unsloth 现已支持决策模型。
适用于媒体 SDK 的 AI
适用于媒体的 NVIDIA AI SDK 现已可用于 RTX Spark,包括支持视频超分辨率、帧生成和 TrueHDR 的 Python wheel。此 Wheel 可在 PyPI 上使用,NGC 上也提供适用于 RTX Spark 和 Arm 上的 Windows 的 C++ SDK。
将您的 Windows 应用引入 RTX Spark
要将现有应用引入 RTX Spark,请先评估 Arm 上 Windows 的依赖项。选择原生 Arm64 版本或使用 Arm64EC 逐步迁移组件。测试应用使用的安装、功能、性能以及 NVIDIA 和 CUDA 路径。
NVIDIA 的应用移植资源解释了迁移选项和工具,包括如何开始在现有的 Windows on Arm 开发系统上进行准备。
找到您的 RTX Spark 并开始构建
RTX Spark 现已在笔记本电脑中推出,并将于 11 月登陆小型台式机,非常适合全天候运行的代理。
探索 RTX Spark 系统,找到您喜欢的系统,并查看可用的购买选项。
获取自己的智能体后,即可开始使用 AI 开发手册配置 Windows、设置智能体并连接 NVIDIA 技能。了解如何开始为 NVIDIA GPU 开发本地 AI 应用。
