

天文台和望远镜、激光和 X 射线光源以及其他高吞吐量仪器生成图像数据的速度比受 CPU 限制的工作流处理图像数据以支持及时决策的速度更快。计算瓶颈很少是一个缓慢的内核。这是从传感器数据到决策的完整路径:读取原始数据、匹配点扩展函数或检测器响应、减去或减少、拟合、分类和警报。
现代设施通常会在单个调查或实验活动中积累 PB 级的多维数据。采用 CPU 优先的实施方案,可能需要数小时到数月 (有时需要一年甚至更长时间) ,才能从仪器在数秒内生成的数据中获得科学上有用的结果。这些延迟使得科学家和工程师更难获得见解和推进研究。缺少的是涵盖从传感器到决策每个阶段的 GPU 原生路径,而不是任何一步的更快版本。
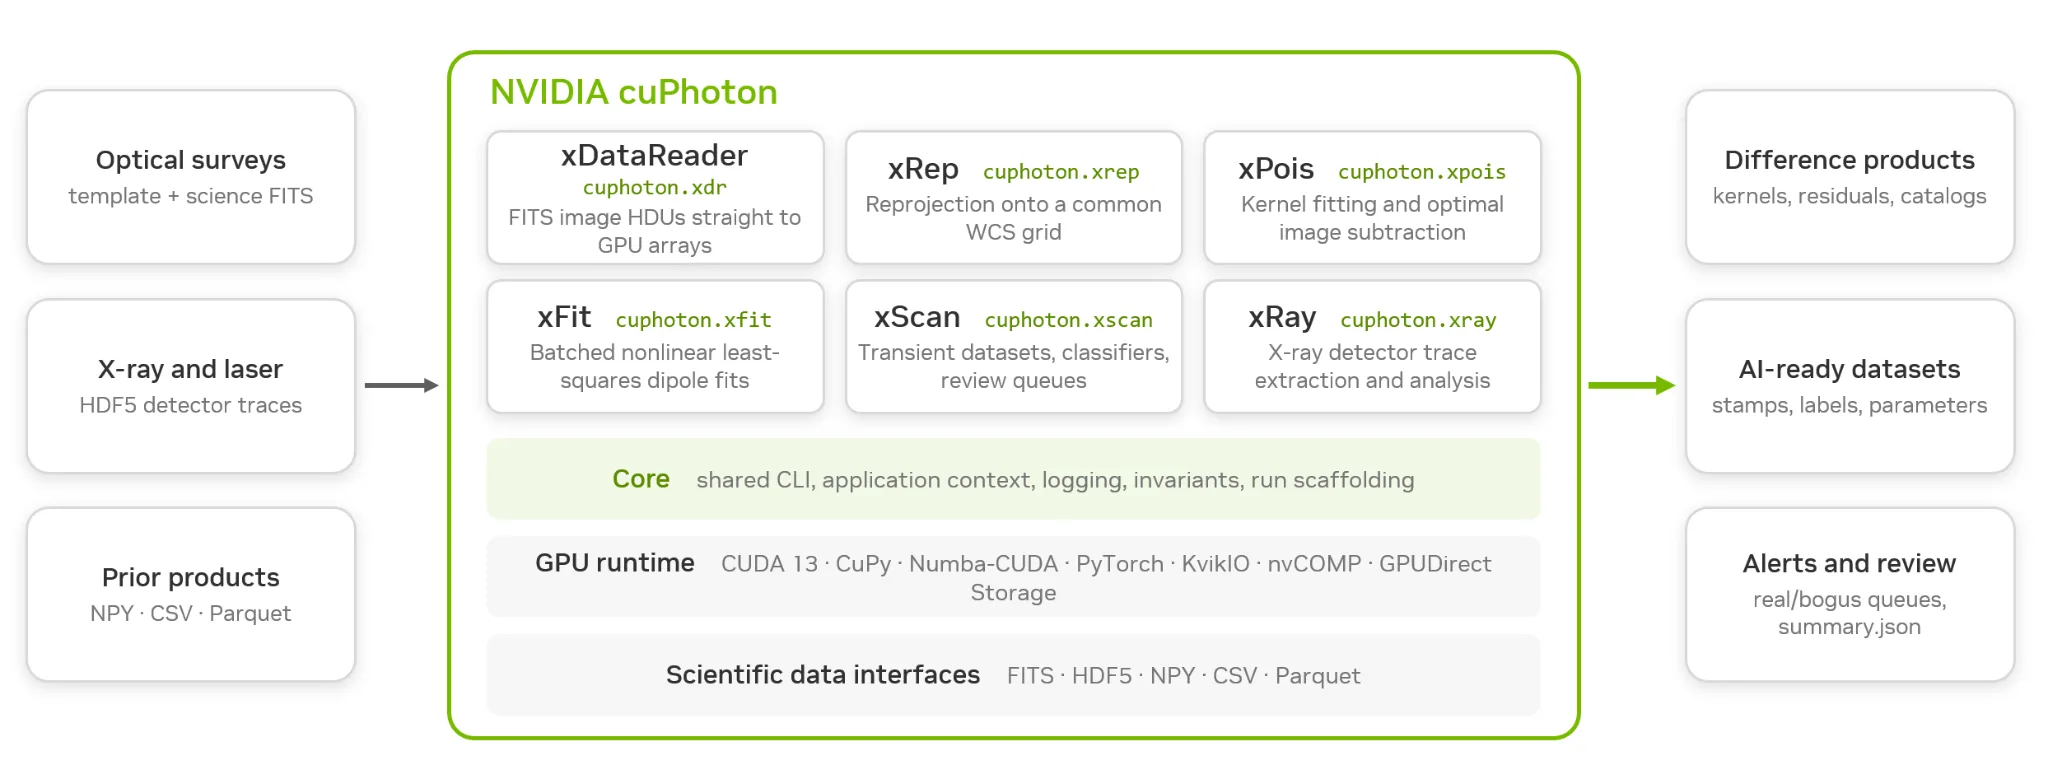
NVIDIA cuPhoton 是一个开源 NVIDIA CUDA-X 工具包,包含该路径的 GPU 加速基础模组,涵盖从光谱和光学天文学到时域激光/ X 射线分析的用例。通过分类,cuPhoton 将 GPU 上来自传感器的图像数据保持在读取状态,将等待时间缩短到几秒钟,从而使研究人员能够以交互方式运行一个紧密的循环,从而缩短获得见解的时间,并使设施能够跟上仪器生成数据的速度。
借助 cuPhoton 将科学见解的分析时间从几个月缩短到几分钟
在天文学、X 射线科学和其他高吞吐量领域,NVIDIA cuPhoton 提供了用于加载、处理和分析大量多维数据集的工具。以下示例将 cuPhoton 模组整合到一个端到端工作流中。
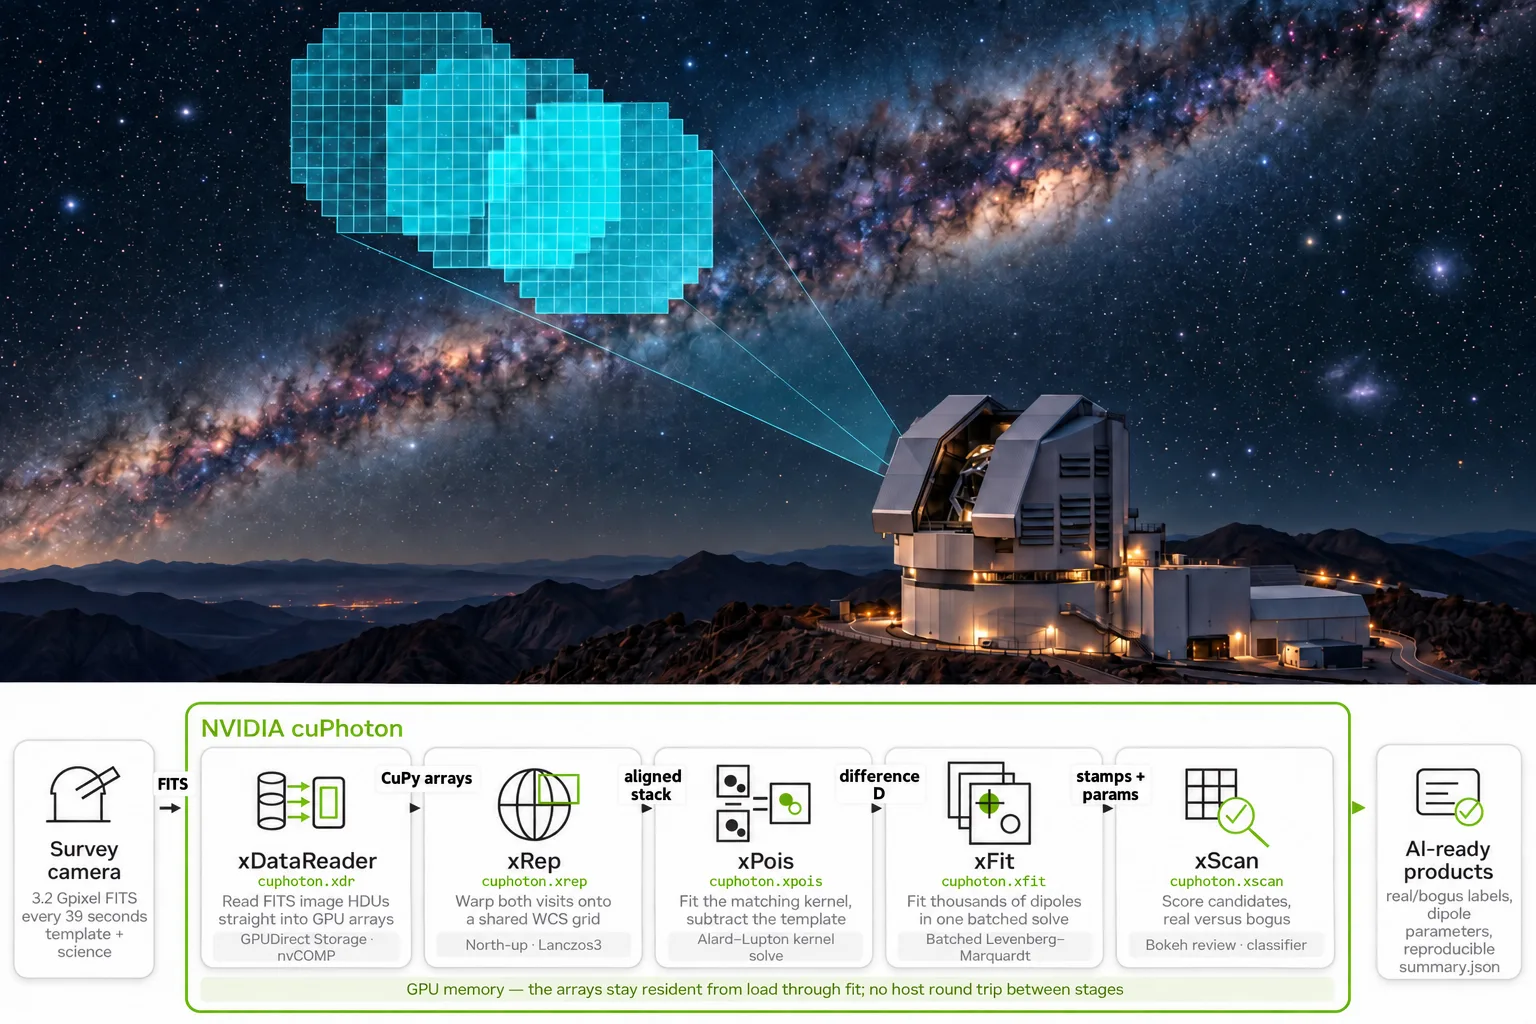
NSF-DOE Vera C. Rubin Observatory 是现代科学设施的一个突出例子,对快速提取科学见解的需求很高。天黑以后,每隔 39 秒,Vera C. Rubin Observatory 的 LSSTCam 就会记录一次新的 3.2 亿像素的南方天空曝光。提示处理流程会将每帧与同一天空区域的参考模板进行比较。在大约 60 到 120 秒内,它必须将大约 1 万个检测结果分类为天体物理瞬变或伪影,例如宇宙射线、卫星轨迹和处理错误。整个晚上,这相当于高达 20 TB 的图像和 1000 万个候选对象。
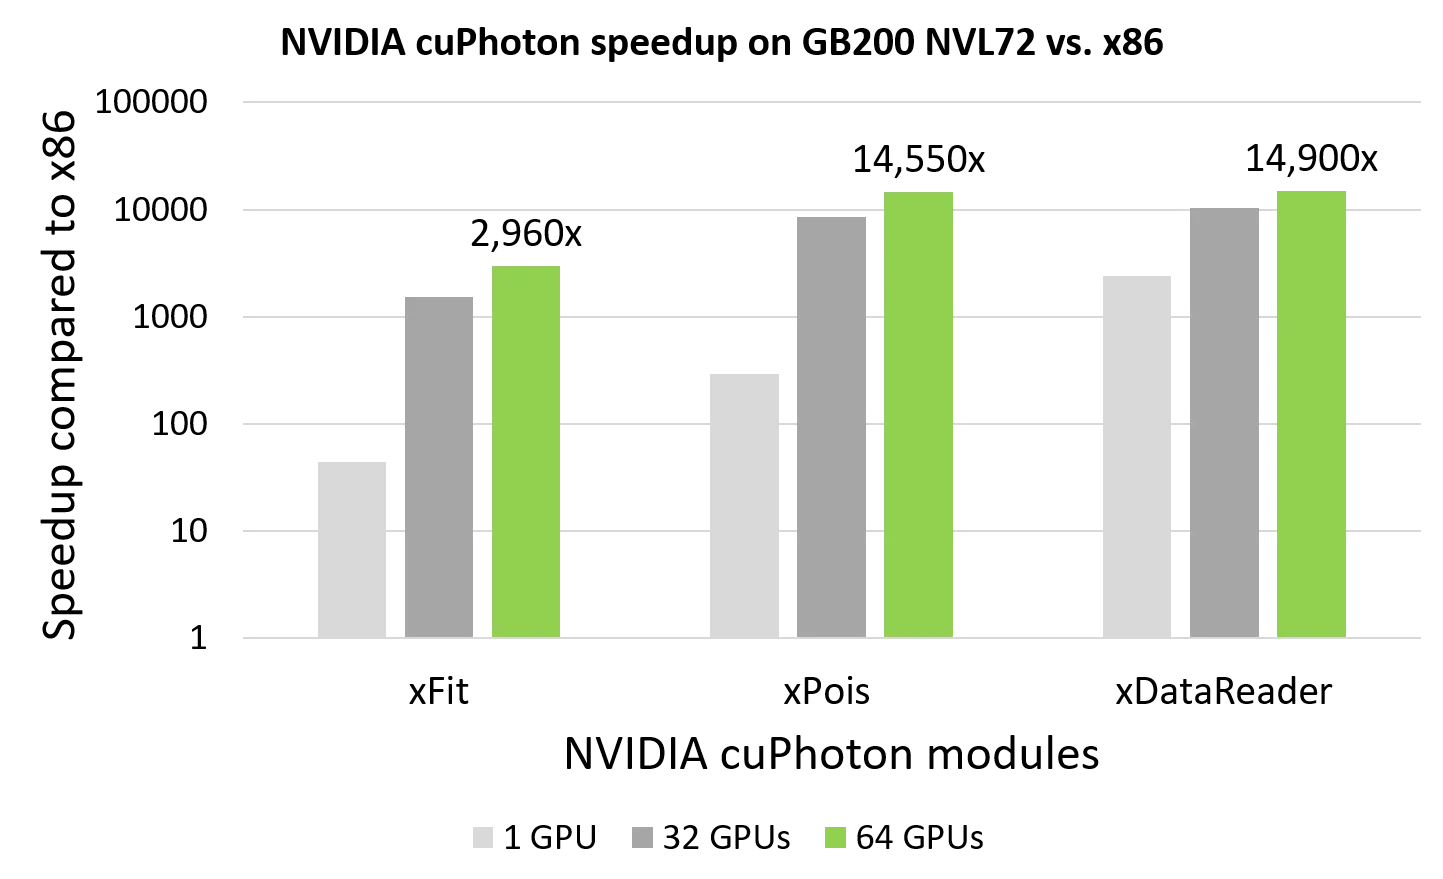
NVIDIA cuPhoton 可跨多 GPU、多节点 NVIDIA Grace Blackwell 和 NVIDIA Vera Rubin 系统进行扩展。在涉及使用多个 GPU 的数百 TB 数据的代表性工作负载中,cuPhoton 将图像加载和读取速度提高了 14900 倍,将信号处理速度提高了 14550 倍,将数月的计算时间缩短为几分钟。以前需要 9 个月才能完成的数据分析在 4 个小时内通过 GPU 加速的 Python 进行演示。对于 KB 数量级较小的数据集,整个 cuPhoton 工作流在毫秒甚至微秒的时间尺度上执行。图 3 将单个 cuPhoton 操作的加速与 x86 CPU 基准进行了比较;这些结果并不是端到端工作流加速。
示例科学工作流程演练
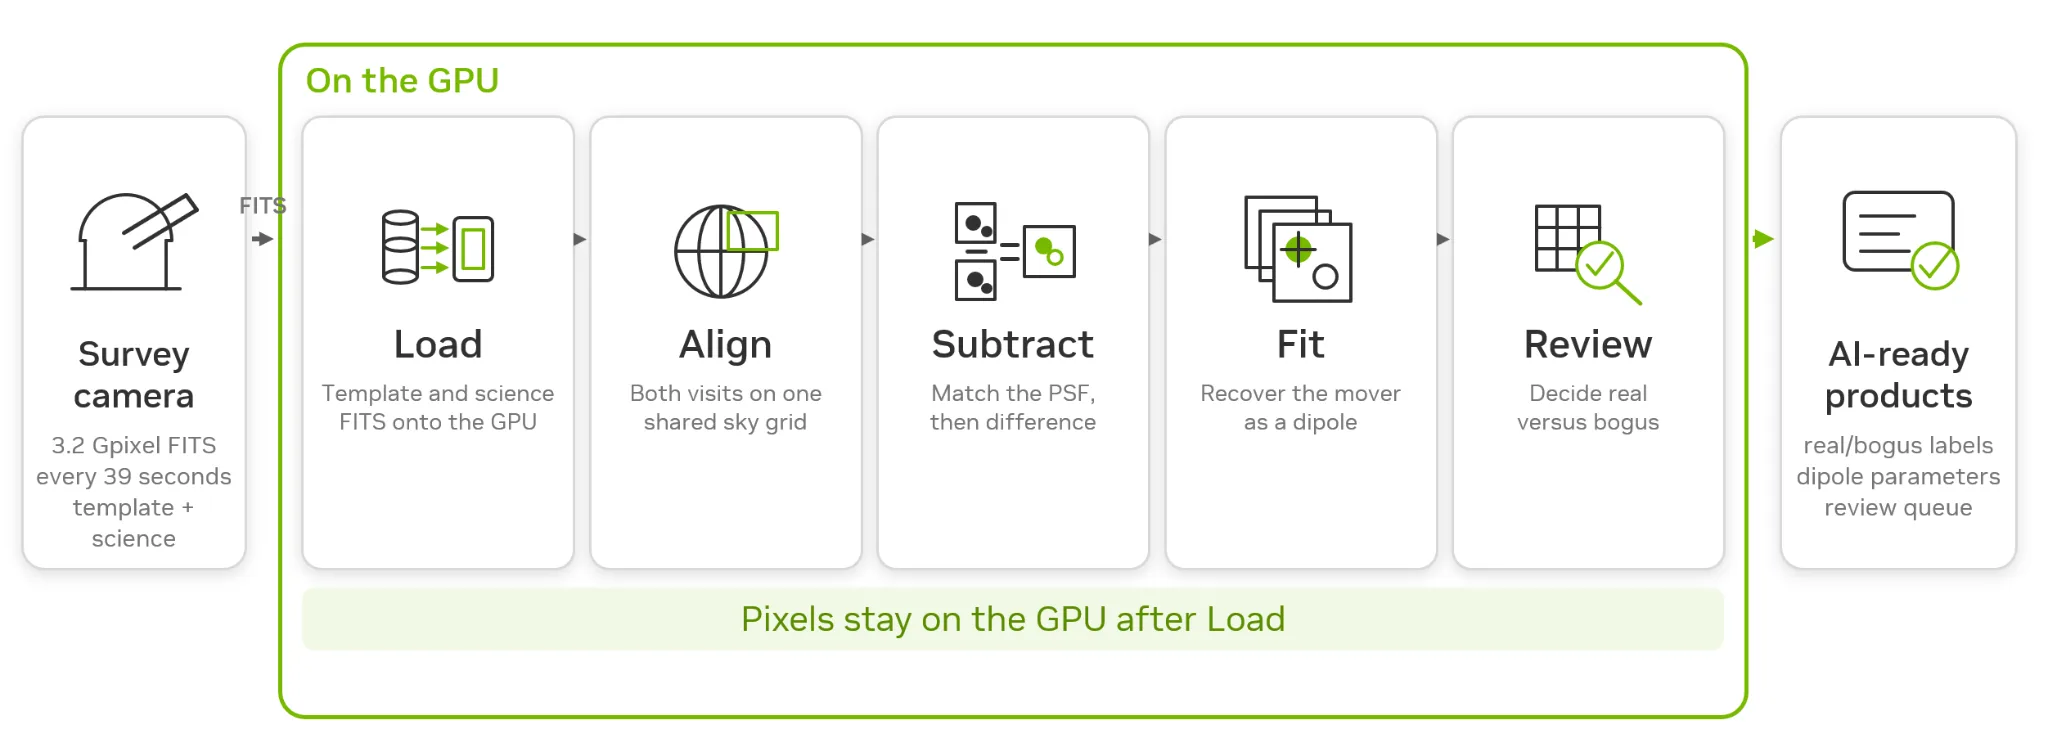
本文将介绍一个逼真的科学工作流程,使用一对物理性质的合成天文图像。以下示例保持简短,以便在 NVIDIA DGX Spark 或单 GPU 工作站上运行。相同的工作流可跨多 GPU 工作站和集群扩展;本文稍后将介绍启动过程。图 4 显示了以下部分中涵盖的工作流程阶段。
- 将当前曝光和参考数据加载到 GPU 显存中。
- 对齐:将两次访问放置在共享的天空网格上,使同一颗星落在同一像素上。
- PSF 匹配和消减:在当前曝光和同一区域的早期参考中,匹配点扩展函数 (PSF) ,即描述光线在像素之间如何分布的模式。然后减去引用。移动的物体会留下正像素和负像素配对的图案,称为“偶极子”。
- 将双 PSF 模型拟合到偶极子上,以估计移动物体的位置。
- 可视化结果:显示 PSF 匹配核函数、消减残差和恢复的偶极子.
执行工作流程
以下示例使用小型合成数据集,因此您可以在机器上进行测试。前面提到的峰值性能数据因工作负载、数据集、实现和硬件而异。最大的加速是单个操作,不应视为端到端工作流因素。
本演示涵盖五个 cuPhoton 组件:xDataReader、xRep、xPois、xFit 和 xScan。该工具包还包括用于时域 X 射线检测器分析的 xRay。
首先,克隆存储库,然后按照 README 设置工作流进行操作。设置命令 (uv sync --locked --extra dev --extra gpu --extra viz) 提供一个支持 NVIDIA CUDA 13 生态系统的锁定 Linux 环境:CuPy、PyTorch、Numba-CUDA、KvikIO 和 NVIDIA nvCOMP,以及可视化库 ( Bokeh 和 Pillow) 。此检查项包括 cuPhoton CLI (此演示中使用的模块) 和 examples/run_quickstarts.py (生成合成输入并将运行伪影写入 quickstart-output/) 。
设置工作目录
按照自述文件创建锁定的 CUDA 13 GPU 环境。此外,xDataReader 的 FITS 路径还需要其原生扩展程序;请查看结账运行 bash src/cuphoton/xdr/src/build.sh ( xDataReader 指南) 。cuPhoton 0.1.3 在 Linux 上支持 Python 3.12 – 3.14 和 CUDA 13。
从源代码构建 xDataReader 需要 C++ 17 编译器、CUDA 和 cuFile 开发头文件,以及重新导入的 CFITSIO 开发安装。有关设置说明,请参阅 xDataReader 指南。
git clone --branch v0.1.3 --depth 1 https://github.com/NVIDIA/cuPhoton.git
cd cuPhoton
export WORK_DIR="$PWD/blog-run"
mkdir -p "$WORK_DIR"/{fits,npz,figs}
从根目录开始,在单个交互式会话 (例如 Jupyter、IPython 或集成脚本) 中依次执行每个 Python 代码段。后续部分会重复使用内存中保留的变量:images、aligned、reference、target、fit、 stamp、model 和 result。Ensure WORK_DIR 在整个执行过程中始终保持定义。如果未构建原生 xDataReader 组件,请暂停并执行 bash src/cuphoton/xdr/src/build.sh。
cuPhoton 资源库中提供了完整的工作流程脚本。要从全新终端自动运行,请通过 uv run python 调用 run_imaging_pipeline.py。对于交互式 Notebook,请在 Jupyter 中打开 run_imaging_pipeline.ipynb。
将 FITS 直接加载到 GPU 上
灵活图像传输系统 (FITS) 是天文学和天体物理学领域的标准数据格式。通常,您使用 Astropy 在 CPU 上读取数据,然后调用 cupy.asarray 将生成的数组传输到 GPU 显存。在主机上执行解析和解压缩,然后在任何科学内核运行之前进行 PCIe 传输。(以每小时 TB 的数据速率计算,此序列会产生大量数据移动用度,是警报延迟预算的首要消耗因素。)
为解决这一瓶颈,xDataReader 可加速解压缩、读取和将 FITS 直接加载到 GPU。具体而言,xDataReader 将工作负载分割如下:CFITSIO 在 CPU 上规划字节范围,KvikIO 读取它们 ( NVIDIA GPUDirect Storage 可用) ,nvCOMP 解压缩 GPU 上的 GZIP 图块,CuPy 保存结果。它支持未压缩的 2 – 16 轴图像 HDU 和使用 GZIP_1 或 GZIP_2 平铺压缩的二维图像。不支持稻米压缩和抖动浮点量化。
GPUDirect Storage 提供兼容的驱动和文件系统。在其他 CUDA 13 计算机上,KvikIO 可能采用其 PCIe 兼容性路径。Python API 保持不变。batch_to_device 仍会返回 CuPy 数组;cuphoton.xdr.is_gds_active() 会报告当前路径。
公共 API 为 batch_to_device。默认为 HDU 索引 1,这是第一个扩展,必须包含受支持的图像。对于主 HDU 中的图像,请传入 hdu_indices=(0,)。该函数为每个请求的 HDU 返回一个堆叠的 CuPy 数组。分组到一次调用中的文件必须在形状和类型上与每个选定的 HDU 相匹配。
示例:
以下代码编写了两个合成的 256 × 256 帧,这些帧可模拟参考模板和后续的科学曝光:三颗静态恒星和一个较暗的光源,光源移动了几个像素。单个移动源是您应该在减法后恢复的偶极子。科学框架也有点模糊,就像看到的更糟糕一样。然后,该示例会将科学图像转变为模拟指向偏移量,并更新标题,使两个帧仍能描述同一天空。这两个文件不共享检测器像素网格,但其标头中的世界坐标系统 (WCS) 会将两者映射到同一天空坐标。
第一个 Python 块是“Scaffolding” (框架) 。将其粘贴一次并保持会话打开。它会导入后续部分所需的所有内容,并设置 WORK 以及这两个 FITS 文件所使用的场景常量。可下载脚本 (run_imaging_pipeline.py) 会编写标头中带有天空坐标的文件,并定义最后使用的 PNG 辅助工具。
import os
from pathlib import Path

import numpy as np
from astropy.io import fits
from PIL import Image
from scipy.ndimage import gaussian_filter
from scipy.ndimage import shift as ndshift

from cuphoton.xdr import batch_to_device
from cuphoton.xfit import GaussianDipoleModel, fit_dipoles
from cuphoton.xpois import GaussianBasisComponent, solve_constant_kernel
from cuphoton.xrep import (
    BBox,
    Grid,
    build_stack_spec_from_fits,
    make_north_up_wcs,
    reproject_stack,
)

SHAPE = (256, 256)
STARS = (
    (70.0, 80.0, 45.0, 2.10),
    (175.0, 190.0, 32.0, 2.40),
    (40.0, 200.0, 22.0, 2.00),
)
MOVER_OLD = (120.0, 108.0, 14.0, 2.10)  # y, x, amp, sigma
MOVER_NEW = (126.5, 116.0, 14.0, 2.10)
CRVAL = (150.0, 2.0)
PIXEL_SCALE = 0.2  # arcsec / pixel
SCIENCE_SHIFT = (20.0, -32.0)  # dy, dx; large enough to see by eye
SEEING_SIGMA = 0.65  # extra Gaussian blur applied to the science frame
这些支架还在内存中。产品调用是 batch_to_device:它会将两个图像 HDU 读取到 GPU 上,并返回堆叠的 CuPy 数组。
(images,) = batch_to_device(
    [WORK / "fits" / "template.fits", WORK / "fits" / "science.fits"],
    hdu_indices=(1,),
)
一次成功运行会打印数组形状 (2, 256, 256)、其 dtype 以及所登陆的 GPU 设备,从而确认该设备上的两个帧。这些数组仍然位于每个文件的原生像素网格中。静态星号不应对齐;这是植入的不匹配,而不是加载程序的故障。
插值和对齐:在同一天空网格上对齐两次访问
对同一色块的两次访问通常不会共享像素网格。在模板和科学帧中,抖动、旋转和板块刻度会将同一颗星置于不同的 (x,y) 上。FITS 报文头中的 WCS 是从这些像素到天空的映射。xPois 在已注册的数组上匹配点扩展函数。先减去,每个静态星变成残差;推动者不再是一个干净的偶极子。
xRep 将二维图像重新采样到一个共享的北上天体网格上。build_stack_spec_from_fits 可读取 WCS 解决方案并构建一个目标占用空间。reproject_stack 将每个成员扭曲到该网格上。backend="auto" 首选 CuPy,然后选择 CUDA PyTorch,然后选择 CPU (如果没有 GPU 可用) 。默认情况下,插值是 Lanczos-3。
下一个块保留上面写入的 FITS (原生检测器像素加上植入的 CRPIX 偏移量) ,并将这两个访问放在一个网格上。线程束结束后,静态星形应位于模板上。移动者应该是唯一改变天空位置的光源。
native, spec = build_stack_spec_from_fits(
    [WORK / "fits" / "template.fits", WORK / "fits" / "science.fits"],
    hdu=1,
    grid=Grid.from_wcs(wcs_t),
    output_bbox=BBox(0, 0, SHAPE[1], SHAPE[0]),
    interpolation="lanczos3",
    mapping_grid_step=16,
)
aligned = reproject_stack(native, spec, backend="auto")
Print aligned.images.shape 和 aligned.backend。CUDA 13 上预计会有两帧的堆栈和一个 GPU 后端。如果静态恒星仍然相距几个像素,WCS 无法描述您放置的偏移,或者目标网格无法同时覆盖两个像素。
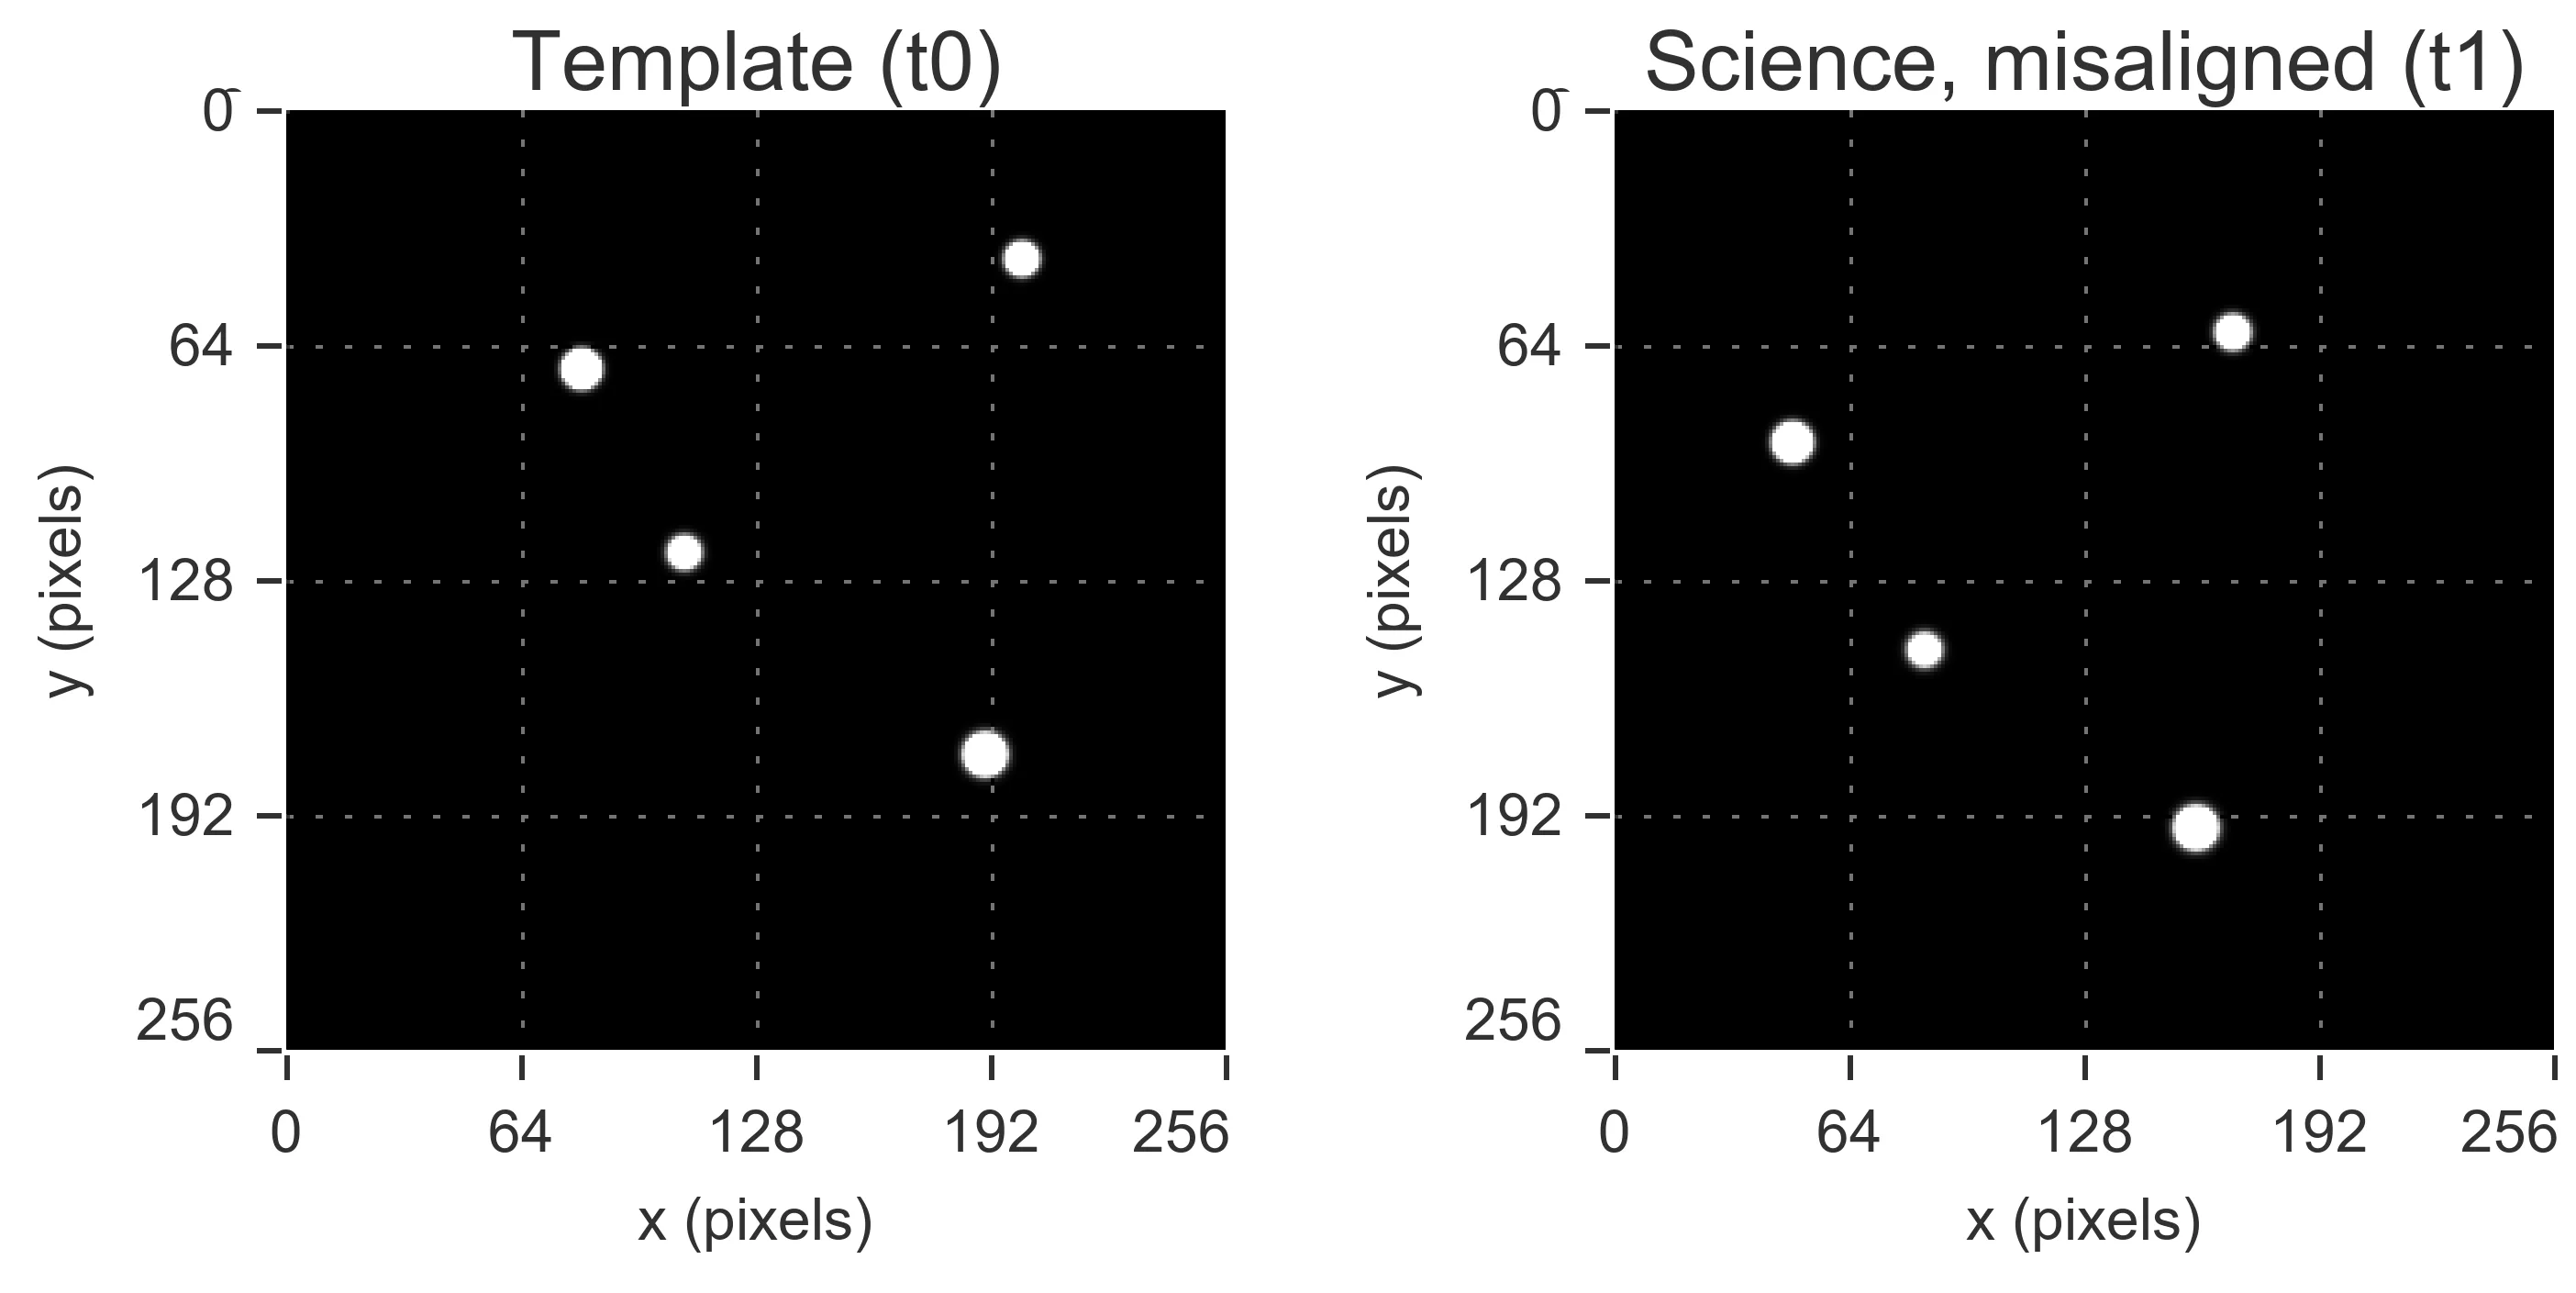
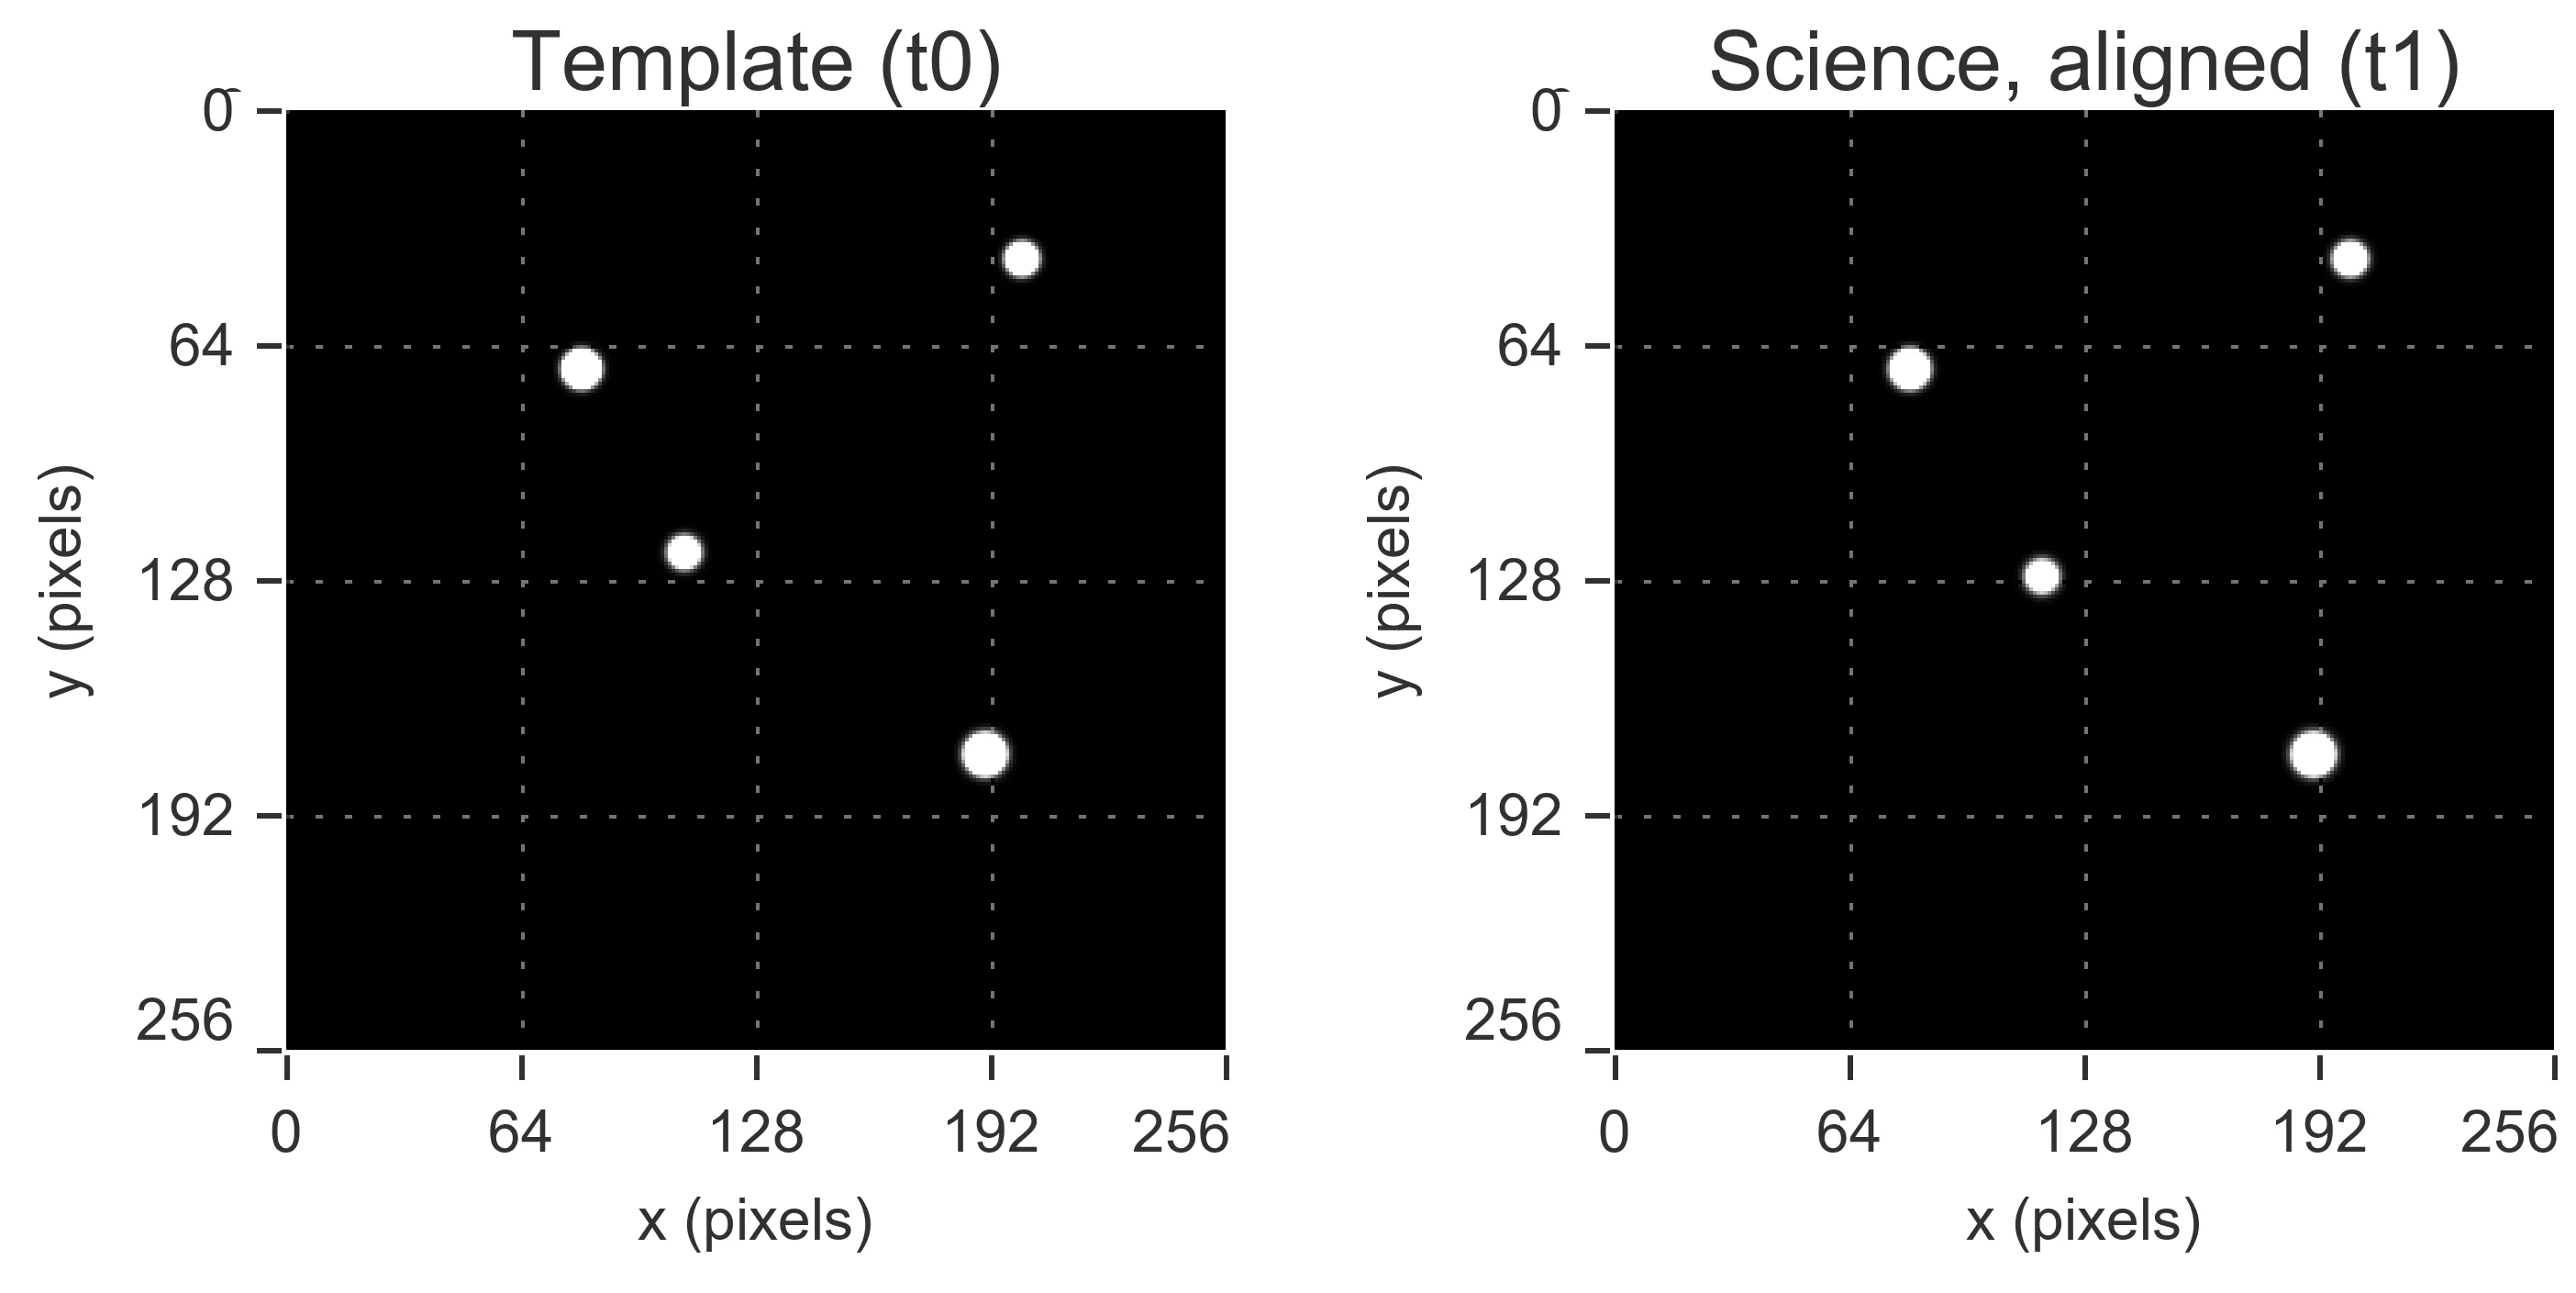
reproject_stack 之后。静态星注册,而种植的移动源仍处于位移状态匹配 PSF 和消减
原始的科学 – 模板差异主要由大气模糊 (视觉) 差异引起的每颗明亮的恒星周围的残差决定。遵循 Alard 和 Lupton 的最佳图像消减效果可求解紧凑卷积核 K 和微分背景 B,因此参考模板 R 获取科学 PSF 并与科学曝光相匹配,T:
T R K B,
其中“+”表示卷积。然后,从曝光 T 中减去生成的模型,以生成差值 D:
D T ( R K B) 。
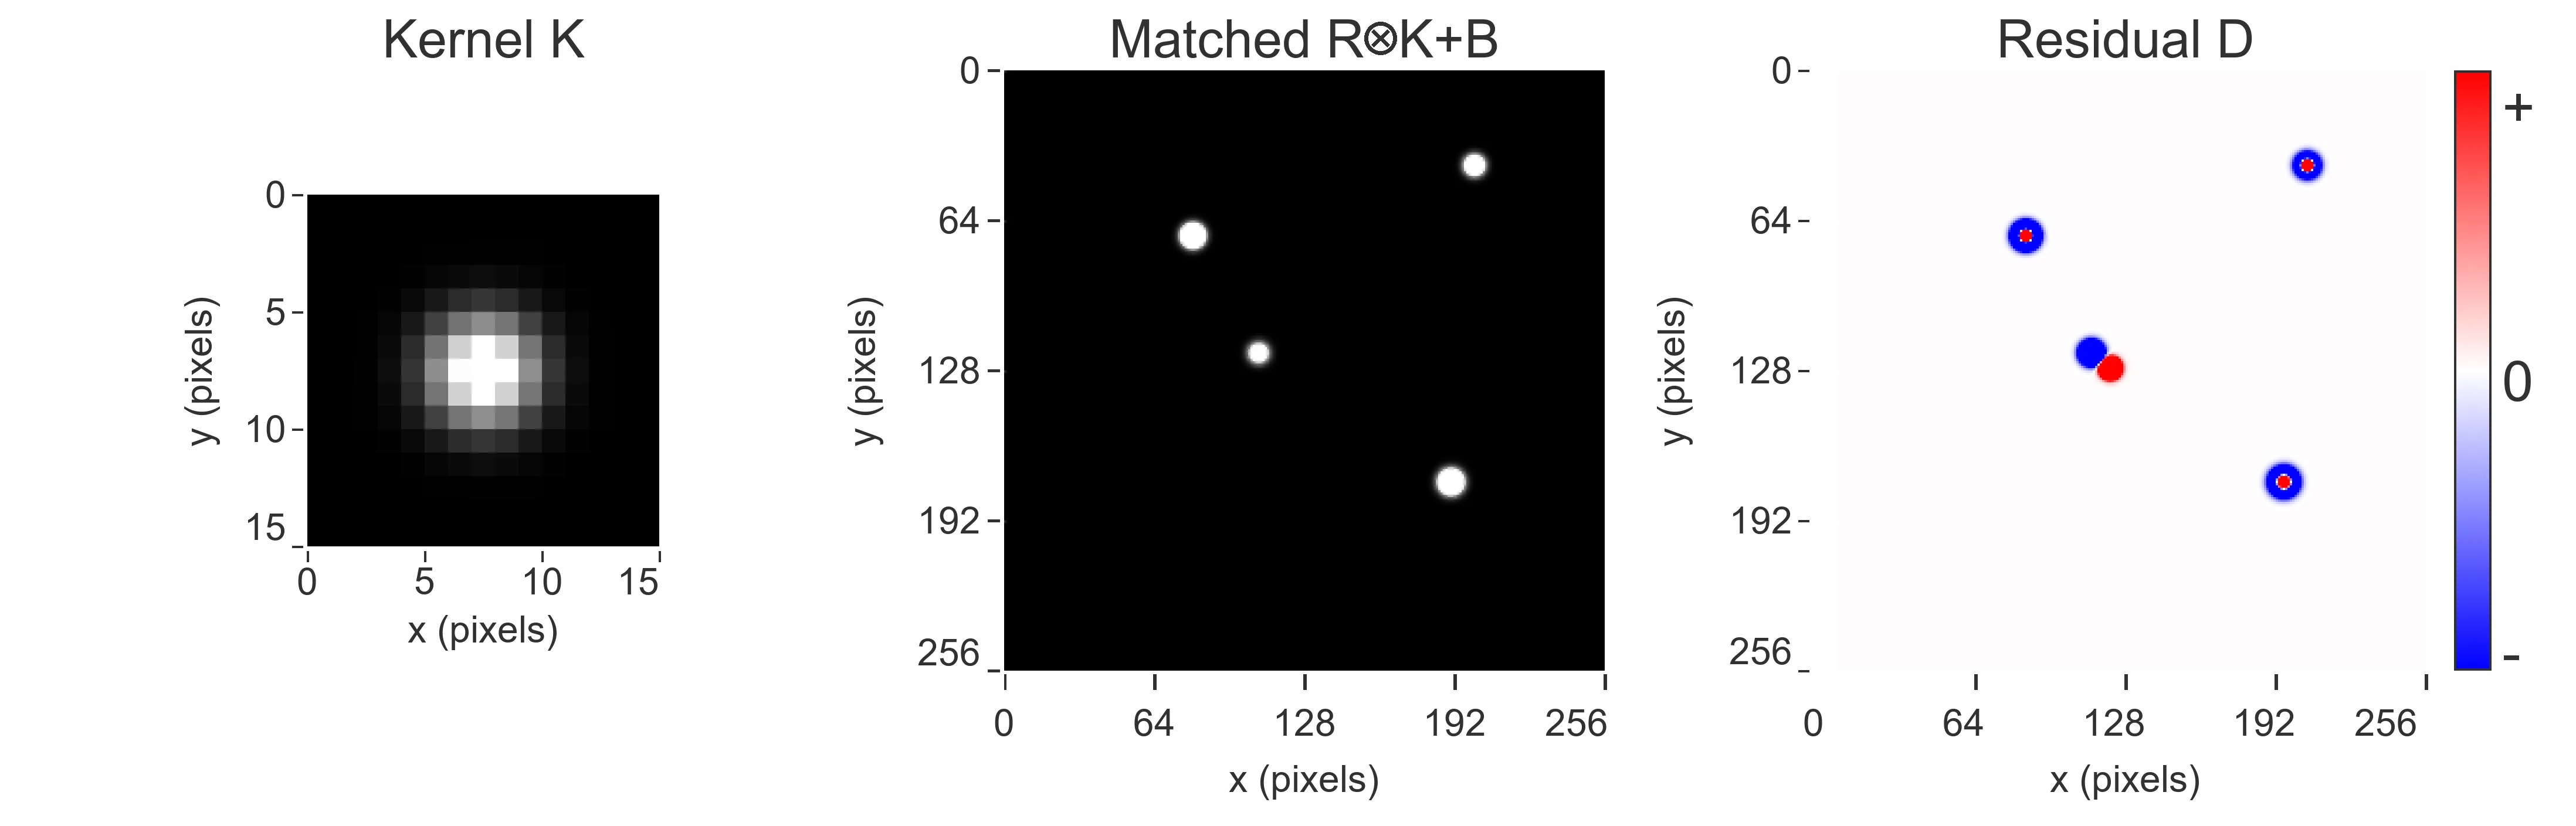
xPois 使用高斯多项式核函数基础来计算优化图像消减所需的卷积核。对于此处使用的常量核求解,backend="auto" 按此顺序选择第一个可用后端:CuPy、Numba-CUDA、CPU。较小的系数求解会停留在主机上,而像素则不会。节省通量的基础重写使核和接近 1。在评估通量守恒时,请查看此总和。行为良好的内核是紧凑且大致对称的。明亮的环或较大的负碗表示基点无法表示视物不匹配,或者表示未遮罩的饱和星进入拟合。
下一个块使 reference 和 target 远离对齐的堆栈,并适合 15 × 15 的内核。由于 xRep 将访问放在一个 WCS 上,因此紧凑型内核应吸收视觉不匹配。应取消三个静态星号。移动器在 t1 处应保持为正瓣,在 t0 处应保持为负瓣。
fit_mask = np.ones(SHAPE, dtype=bool)
fit_mask[105:142, 93:132] = False
fit = solve_constant_kernel(
    reference,
    target,
    [GaussianBasisComponent(sigma=SEEING_SIGMA, degree=0)],
    kernel_shape=(15, 15),
    background_degree=0,
    flux_conserve=True,
    fit_mask=fit_mask,
    backend="auto",
)
Print fit.backend、kernel.sum()、chi2 和 fit_pixel_count。接近 1.0 的核和以及明亮星环已折叠的残差意味着匹配成功。如果星形仍然在 D 中占据主导地位,则要么图像未被注册 (使用 cuphoton.xrep 将其放置在共享 WCS 上) ,要么内核基础太窄,无法产生视觉差异。在 CUDA 13 GPU 上,fit.backend 应为 cupy,残差 RMS 应远低于此场景中 45 左右的星形峰值振幅。
拟合偶极子
移动物体 (如小行星) 和图像配准错误可能会产生偶极子模式。这些是差异图像中配对的正通量和负通量区域。单独处理每个候选项可能会成为瓶颈。工作流可能需要针对每次曝光的小图像解决数千个最小二乘优化问题。
在本示例中,xFit 的 GaussianDipoleModel 对每个进行建模,作为两个旋转的椭圆高斯分量之间的差值。这两个组件在相同的像素坐标 ( x、y) 上进行评估,并共享幅度、宽度和方向。两个中心 ( x,y) 和 ( x-,y-) 分别变化:
m ( x,y) = G ( x,y;x,y) = G ( x,y;x,y)
xFit 还支持基于通过 StampDipoleModel 提供的采样 PSF 的模型。
xFit 的 Levenberg – Marquardt 求解器可在 CuPy 上同时处理许多正则化的 Gauss – Newton 系统。融合拟合可停止参与求解器的后续迭代,从而减少不必要的工作。在剩余拟合完成后,同步调用将返回批量结果。宽度在对数空间中进行优化,并作为正像素标准差返回;解析 Jacobian 是 Gaussian 模型的默认设置。返回的数组是可移植的 NumPy 参数、协方差和标准误差,因此分类器永远不会导入 CuPy 求解器。
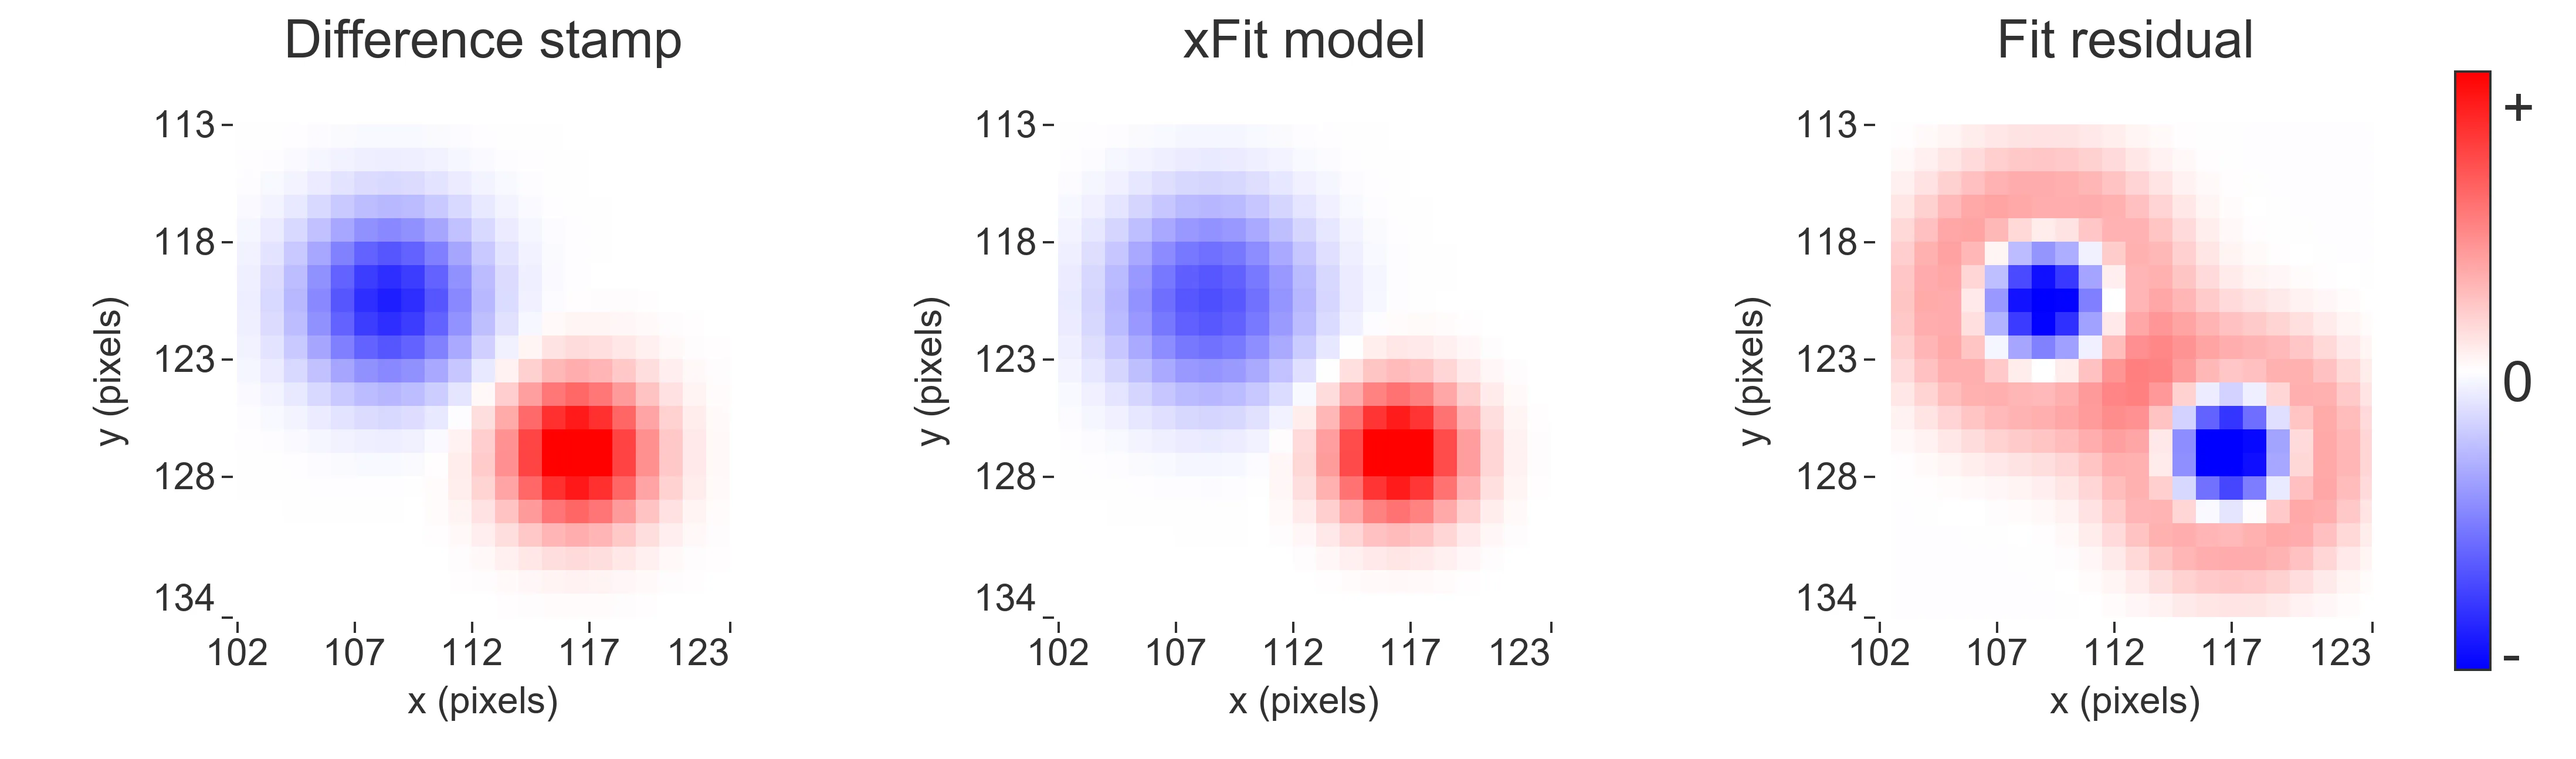
以下代码在 xPois 残差中围绕放置的移动点切割了一个 21 × 21 的,并从初始猜测稍有错误开始拟合。打印已恢复的中心以及已知的输入位置。将恢复的中心点与已知的输入位置进行比较,以检查拟合精度。
STAMP = 21
half = STAMP // 2
cy, cx = 123, 112  # midpoint of the planted mover
stamp = fit.residual[cy - half : cy + half + 1, cx - half : cx + half + 1]

# Seed the fit from the observed stamp extrema, in centered x/y coordinates.
y_pos, x_pos = np.unravel_index(np.argmax(stamp), stamp.shape)
y_neg, x_neg = np.unravel_index(np.argmin(stamp), stamp.shape)
initial = np.array(
    [
        [
            stamp.max(),
            2.0,
            2.0,
            0.0,
            x_pos - half,
            y_pos - half,
            x_neg - half,
            y_neg - half,
        ]
    ]
)

model = GaussianDipoleModel((STAMP, STAMP), dtype=np.float64)
result = fit_dipoles(
    stamp[None], model=model, initial=initial, backend="auto"
)
期望 converged: True 处理这些合成数据。已恢复的 (x_pos, y_pos) 和 (x_neg, y_neg) 应位于种植偏移量像素的一小部分范围内。拟合残差中的结构化残差通常意味着仍包含静态星形,或者初始中心位于错误的叶。
查看印章
上述示例验证了受控合成场景中的工作流程,其中包含一个放置的移动物体和已知的真值。真实的观察结果既无法提供这种简单性,也无法提供这种确定性。一台望远镜指向 (访问) 最多可以生成 10000 个候选项,而一个完整的夜晚则会生成数百万个候选项,这使得单独检查变得不切实际。下一步是优先考虑候选项进行人工评审。
cuphoton xscan review-queue 根据模型不确定性、已知错误或直接数据集审核对候选项进行排序,并限制人工审核的候选项数量。使用 cuphoton xscan review-bokeh 检查搜索曝光 (当前观察结果) 、参考模板、原始差异和 xPois 残差,并为每个候选项添加 Real/bogus/ Unsure 标签。
图 9 展示了具有噪声伪影示例的审查接口,因此您可以先检查布局,然后再将其与观察结果结合使用。观测 FITS 数据不在 git 存储库中。复制 README 和 xScan 指南 下的示例,设置本地路径,然后按照 README 和 xScan 指南 构建审核队列并启动应用。
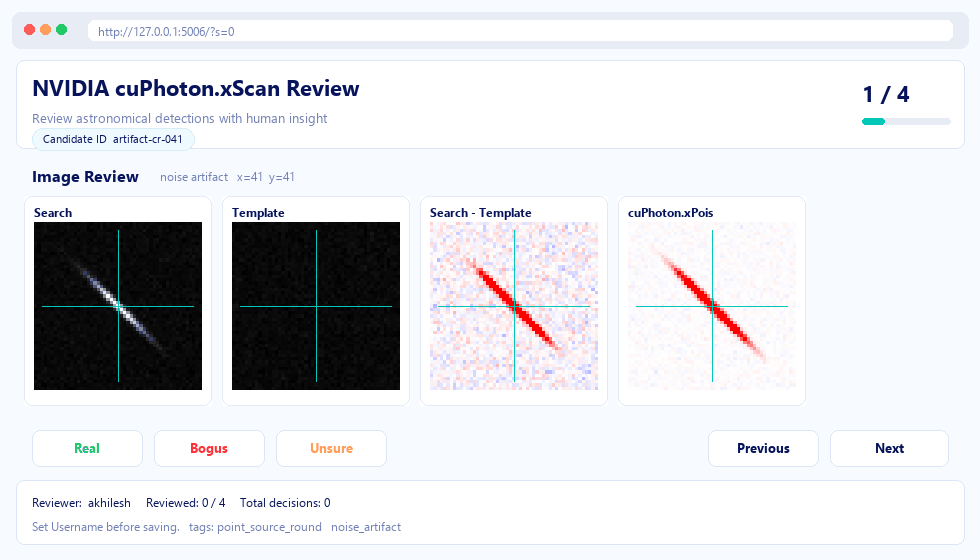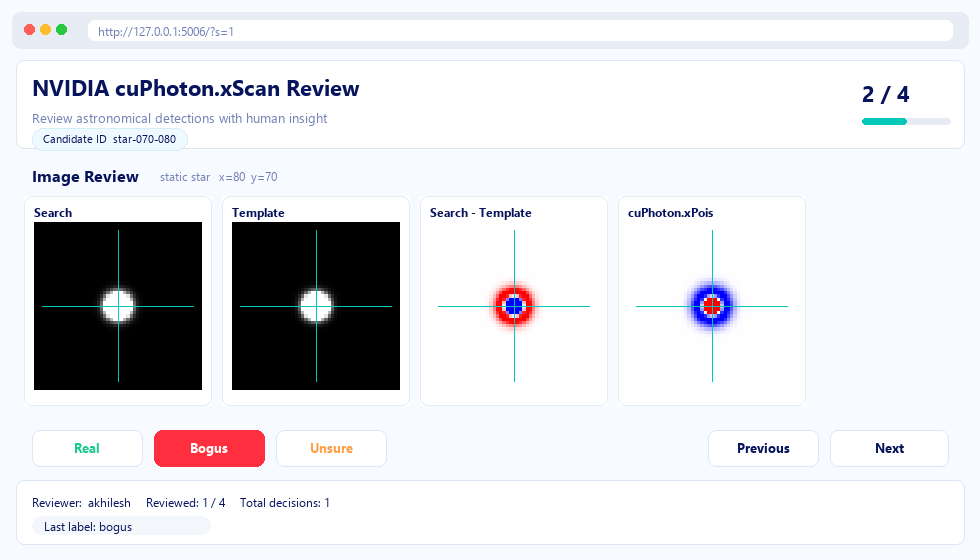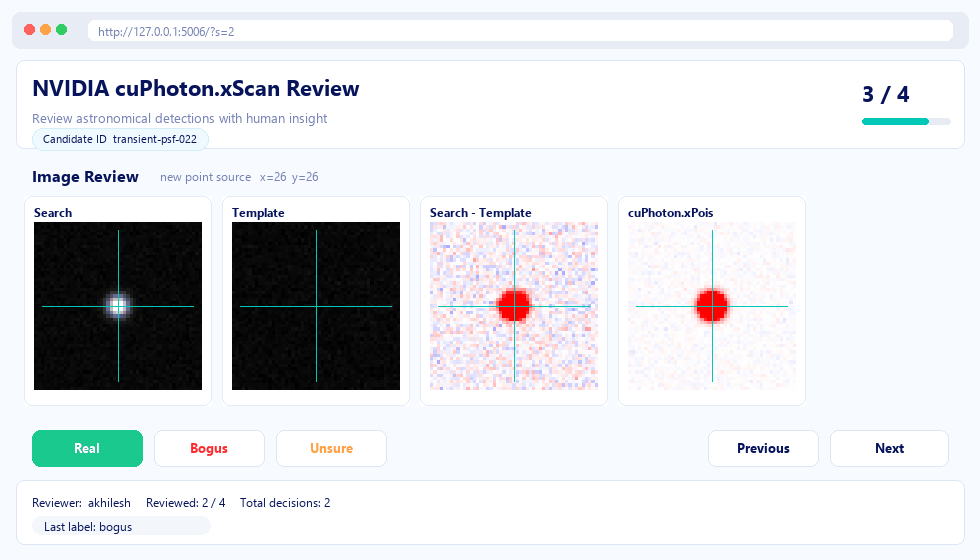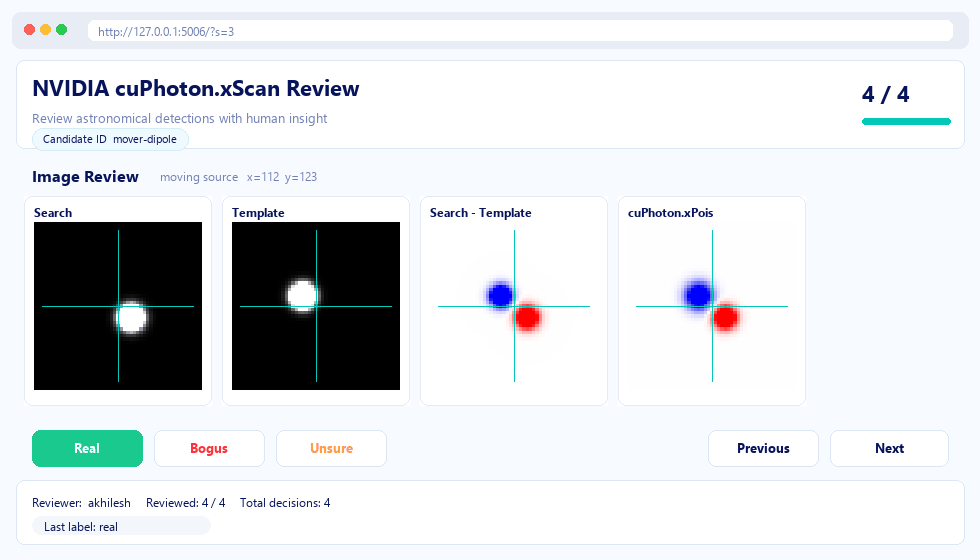
cuphoton xscan review-bokeh) 显示搜索、模板、差异和 xPois 面板,以及 Real、虚假和不确定标签控件。在 LSSTComCam 或 HSC 产品上运行相同的命令;git tree 不会传输这些像素跨多个 GPU 扩展相同的工作流程
以上演示是一个 GPU 上的一对图像,小到足以容纳 NVIDIA DGX Spark 或工作站。NVIDIA cuPhoton 在多 GPU、多节点系统中运行相同的加载和处理路径。注册后,cuPhoton 会在 GPU 工作节点之间分配完整的图像对及其候选坐标,通过消减、偶极子拟合和分类在设备上保留图像数组。此示例使用合成输入和未经训练的模型来验证多 GPU 启动。扩展该路径是工具包处理 Vera C. Rubin Observatory 曝光等测量大小的数据流的方式。要运行多个数据对,请使用以下命令。分布式执行指南中提供了环境设置、Slurm 和 SSH 启动以及 Dragon 替代方案。
python examples/distributed-pipeline/prepare_example.py \
  --output "$CUPHOTON_RUN_ROOT/input" --images 8

export CUDA_VISIBLE_DEVICES="${CUDA_VISIBLE_DEVICES-0,1,2,3}"
mpiexec -n 8 --map-by ppr:4:node --bind-to none \
  -x CUDA_VISIBLE_DEVICES \
  cuphoton-openmpi-rank-exec -- \
  cuphoton xscan run-pipeline --executor mpi \
  --manifest "$CUPHOTON_RUN_ROOT/input/pipeline.json" \
  --output-dir "$CUPHOTON_RUN_ROOT/runs" --name blog-mpi \
  --warmup-rounds 1 --measure-rounds 1
--images 8 创建 8 个图像对,-n 8 启动 8 个 MPI 工作进程,每个 GPU 映射一个。这些对必须已经共享像素网格,这是上述 xRep 步骤。在每节点有一个 GPU 的机器上,将这两个数字设置为节点数量,并使用 --map-by ppr:1:node。这些命令来自 分布式管线示例,其中还包括主机文件模板。生成的模型仅检查工作节点是否开始和完成。
开始使用
这些示例是在 cuPhoton README 上开发的,目标 Linux 系统配备兼容的 NVIDIA GPU 和驱动。按照 cuPhoton README 克隆资源库,查看受支持的 Python 和 CUDA 版本,并设置环境。
- 为 FITS 输入构建原生 xDataReader 扩展程序: xDataReader 指南。
- 跨多个 GPU 和节点运行数据加载和处理:分布式执行指南。
- 创建审核队列并启动候选审核界面:xScan 指南。
- 探索组件 API 并输出构件规格:cuPhoton 文档。
有关相关示例,请参阅《纳米级成像的加速 X 射线分析》 (XANI) 和《使用加速计算在大型研究机构中进行实时科学研究》。
观看 NVIDIA cuPhoton 产品概述,了解该工具包的简介。

