

自动语音识别不仅要处理主导预训练数据的语言和风格,还必须处理人们的实际讲话方式。区域方言和本地录音条件通常代表性不足,因此在广泛基准测试中表现良好的多语言模型可能仍然无法部署。
沙特阿拉伯语使这一点具体化。模型可能会识别现代标准阿拉伯语或英语,但难以识别 Najdi 和 Hijazi 的语音或当地的录音条件。仅对目标方言进行微调可以改善该方言,同时削弱其他语言。
NVIDIA Nemotron 3.5 ASR 支持跨 40 种语言区域的多语种流式转录,包括可转录的阿拉伯语,但针对特定部署的方言和录制条件仍然受益于微调。
本文将介绍如何使用 NVIDIA NeMo 框架 和 ASR 微调方法 对其进行调整:整理低资源语料库、构建加权回放混合、使用高效批处理进行微调,以及评估独立集上的转录质量。
何时使用此工作流程
当您有足够的已标记语音来专门化 ASR 模型,但不足以从头开始训练模型时,此工作流非常有用:方言适应、特定领域的转录、必须保留现有语言的部署。
其技术可以解决不同的问题:
- 尽可能减少管护可消除无法使用的标签和明显的对齐失败,在不丢弃稀缺、难以处理的语音的情况下。
- 回放混合会将少量先前学习的数据交织在一起,以减少灾难性的遗忘。
- 部分编码器解冻限制了参数变化的数量 – 比完全微调更便宜和更快,但对准确性有一定的影响。
- 长度分组可减少填充,并使训练适用于流编码器。
- 光束搜索和更大的注意力上下文可以提高离线准确性,而无需重新训练,但代价是延迟和计算。
这些不是通用默认值。回放仅保护其数据所代表的内容;当混音发生变化时,部分解冻需要重新调整。而且,此工作流无法泛化为适用于每种阿拉伯语方言或部署环境的证据。
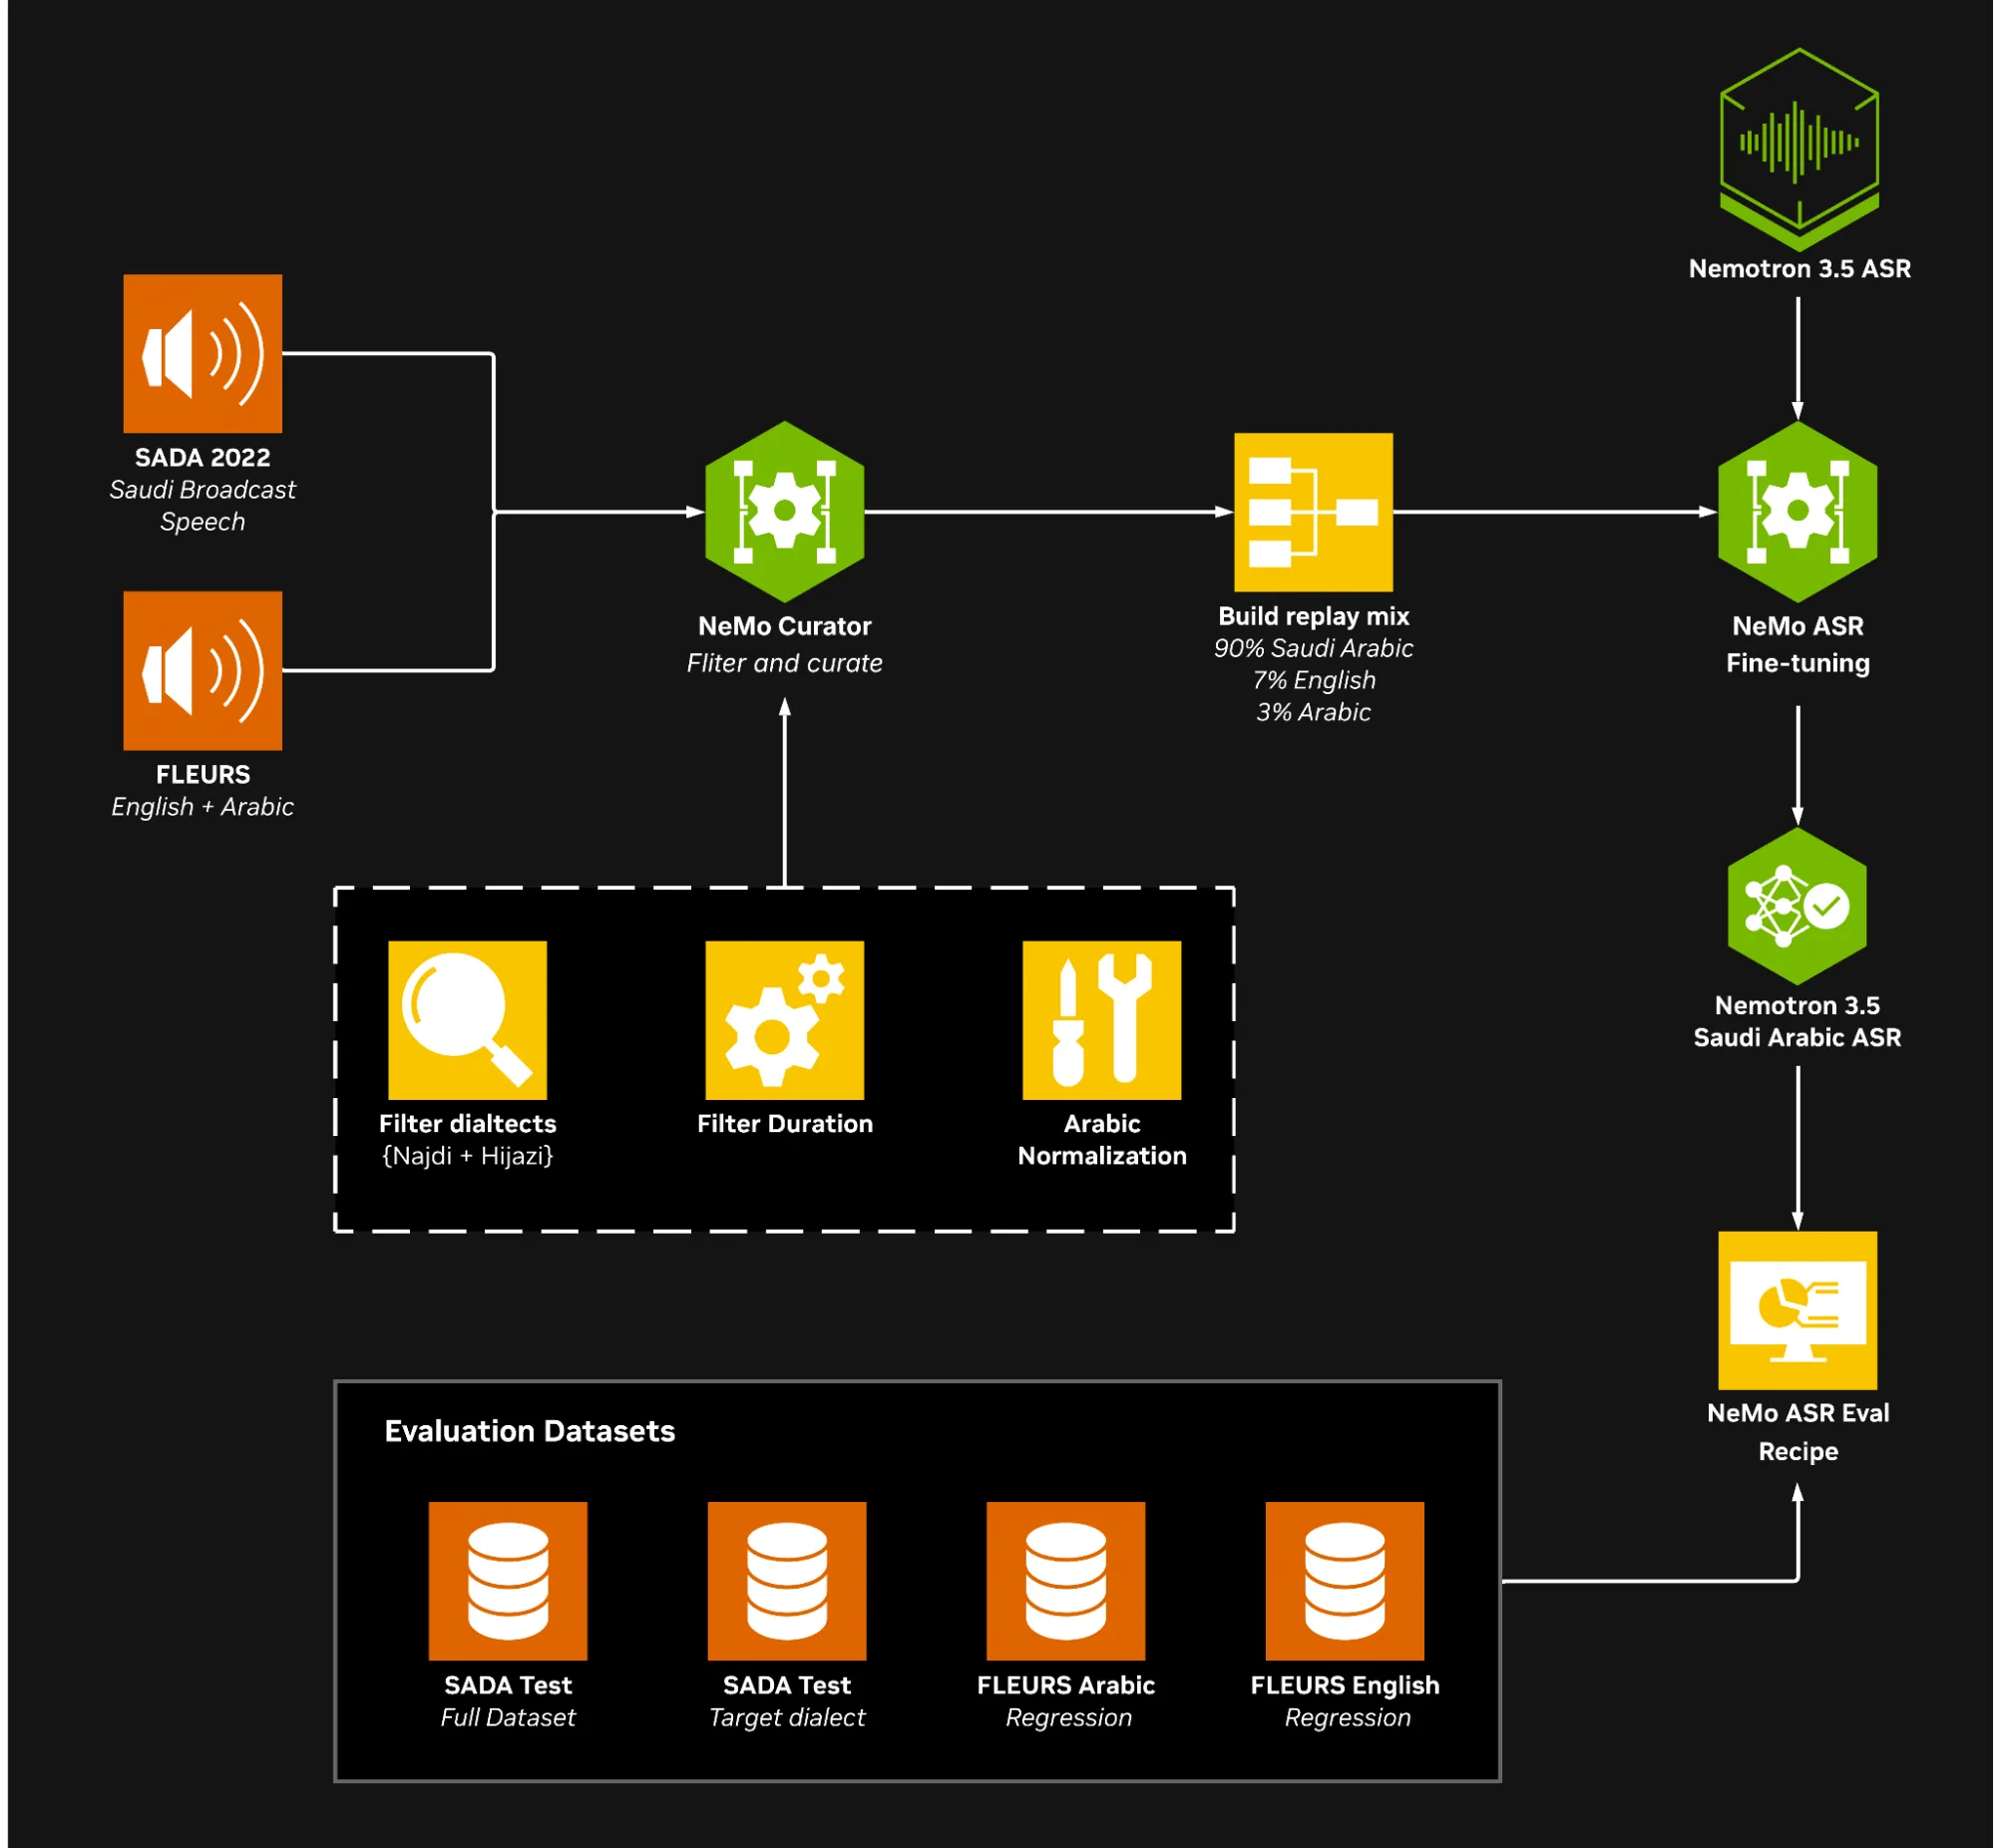
微调演练
预备知识
- NVIDIA NeMo、PyTorch、Python、OmegaConf
- 本教程使用 SADA 2022 和 FLEURS
- 具备 Python、模型微调、WER 和 CER 方面的工作知识
- 12000 步基准实验使用了两个 GPU;确切的 GPU 模型和显存:NVIDIA RTX PRO 6000 Blackwell Workstation Edition GPU
1. 在不过滤问题的情况下整理目标语料库
首先,选择要部署的方言。在最初的 SADA 实验中,这意味着 Najdi 和 Hijazi:
SAUDI_DIALECTS = {"najdi", "hijazi"}
seen = set()

for item in manifest:
    dialect = str(item.get("speaker_dialect", "")).lower().strip()
    seen.add(dialect)
    if dialect not in SAUDI_DIALECTS:
        continue
    keep(item)

missing = SAUDI_DIALECTS - seen
assert not missing, f"never matched: {missing}; observed {sorted(seen)}"
接下来,删除模型无法学习的引用和可能未对齐的剪辑。
SADA marks inaudible speech with غيرواضح; because the model cannot emit that annotation, every occurrence creates an unavoidable error.
在以下代码中,这些标记显示为 Unicode 转义,因此会从左到右渲染,拼写为غيرواضح和غير واضح。该代码还应用了其他一些检查。
MIN_DURATION, MAX_DURATION   = 0.5, 30.0     # drop clips too short or too long
MIN_CHAR_RATE, MAX_CHAR_RATE = 1.5, 35.0     # drop misaligned transcripts

ANNOTATION_MARKERS = ['\u063a\u064a\u0631\u0648\u0627\u0636\u062d',
                      '\u063a\u064a\u0631 \u0648\u0627\u0636\u062d']

for row in manifest:
    txt  = normalize_arabic(row['text'])
    rate = len(txt) / row['duration']

    if not txt or txt.lower() == 'nan':                      continue  # stringified NaN
    if any(m in row['text'] for m in ANNOTATION_MARKERS):    continue  # annotation, not speech
    if not (MIN_DURATION  <= row['duration'] <= MAX_DURATION):   continue
    if not (MIN_CHAR_RATE <= rate <= MAX_CHAR_RATE):             continue

    keep(row)
def normalize_arabic(t):                    # target dialect + FLEURS Arabic
    t = re.sub(r'[\u064b-\u0670]', '', t)                        # diacritics
    t = re.sub(r'[\u0623\u0625\u0622\u0627]', '\u0627', t)       # alef variants
    t = t.replace('\u0649', '\u064a').replace('\u0629', '\u0647') # alef maqsura, taa marbuta
    t = re.sub(r'[^\u0600-\u06ff\w\s]', '', t)                   # punctuation
    return ' '.join(t.split())
这些检查保留了 103559 个 (共 125490 个) 单词:共 133.7 小时,占初始测试时间的 82.5%。目标是删除结构上不好的示例,而不是仅因基础模型表现不佳而删除硬口音或杂的语音。如果您使用自动质量评分,请首先检查其分布;SADA 运行发现,默认的 UTMOS 值 3.0 几乎会拒绝所有内容。
作为二次传递,更广泛的 SADA 管护工作流使用 NVIDIA NeMo Curator 来标准化音频并删除严重降级的视频片段。MonoConversionStage 将输入转换为单声道,而 UTMOSFilterStage 和 SIGMOSFilterStage 则获得了感知质量和背景噪音。我们没有应用其默认值,而是首先在仅评分模式下运行阶段,检查分数分布,然后设置语料库特定的截止值:UTMOS ≥ 1.25,SIGMOS 噪声 ≥ 1.5,SIGMOS 整体 ≥ 1.5。他们通过了约 85% 的持续时间有效样本。这保留了具有挑战性但可用的方言语音,而通用值会被淘汰。
2. 从一个数据集开始,监控模型行为
对于新语言或领域,从您可以解释的最简单的实验开始:一个具有代表性的目标数据集、一个常规的完整微调和一个固定的评估集。其目标是观察模型的响应情况,验证训练管线是否正常工作,并创建一个基准,以便根据该基准测量后续的更改。
在我们的例子中,SADA 是第一个数据集。该模型是缓存感知型 FastConformer-RNNT,具有提示多语种流 (strip_lang_tags,target_lang: ar-AR) ,其行为不同于简单的英语流模型,需要在清单中进行明确的语言条件。
您的起始语料库、训练时长和硬件设置将有所不同。下面的配置更改记录了在我们遇到优化、内存和分布式训练问题时,此特定实验是如何发展的;它们是故障排除示例,不推荐默认设置。未列出的超参数 (包括权重衰减、梯度裁剪、混合精度和语音中的有效批量大小) 保留在 NeMo 框架默认值下,并且在本实验中未进行调整。
| 面积 | 配置更改 |
|---|---|
| 优化 | 学习率:default → 1e-4 → 2e-5; 预热: 10,000 → 100 → 50 步; optimizer: AdamW (NeMo default); scheduler: Noam; d_model=1024 |
| 数据加载 | 批量持续时间:400 → 300 → 200 秒,以防止显存不足错误;is_tarred=false;工作者:4 次训练和 2 次验证;存储桶和 shuffle 缓冲区:1000 |
| 验证 | 批量大小为 8;每次迭代验证 |
| 检查点和解码 | 保留三个最佳检查点;使用贪婪解码 |
在最初的仅使用 SADA 的实验中,我们使用验证拆分来监控微调进度。预训练模型在验证拆分时产生 49.5% 的 WER,在整个训练语料库中产生 59% 的 WER。这种差距反映了音频噪声的增加和训练数据中更大的方言差异。
自始至终,验证基准 (49.5%) 一直是我们的主要指标。在前 10 次训练后,WER 提升至 47.8%,在后 10 次训练后,WER 保持在 47.8%,在更长的 v4 继续训练期间,WER 达到 46.7%。在第 45 次迭代之后,验证 WER 停止改进。这种有限的收益和稳定的稳定表明,继续使用相同的完整微调设置不太可能带来实质性改进。
3. 有效方法:缩小目标范围、回放流和桶式批量
更窄的目标,更小的管理
我们没有要求模型一次性改进 11 种方言,而是仅在打算使用的 Najdi 和 Hijazi 这两种方言上进行训练,并且我们使用了最少的管护 (请参阅上文第 1 节) ,从而保留了 125490 个单词中的 103559 个,即 82.5%:
回放流
仅对沙特阿拉伯语音进行微调就会覆盖模型在预训练中学到的内容。防御方法是回放:将之前学习的少量数据流混合回,以便在模型学习新工作的同时,不断要求模型完成旧工作。
我们使用了 10% 的 FLEURS,分割 7% 的英语和 3% 的阿拉伯语,而 90% 的沙特阿拉伯语音。声明这些比例而不是连接文件,因为滑动窗口 shuffle 可能要到训练后期才能到达附加到大型清单文件末尾的行,因此在运行的大部分时间里,连接的回放集实际上并不存在。
from omegaconf import OmegaConf

mix = OmegaConf.create([
    {"type": "nemo", "manifest_filepath": "sada_train.jsonl", "weight": 0.90},
    {"type": "nemo", "manifest_filepath": "fleurs_en.jsonl",  "weight": 0.07},
    {"type": "nemo", "manifest_filepath": "fleurs_ar.jsonl",  "weight": 0.03},
])
OmegaConf.save(mix, "input_cfg.yaml")
cfg.train_ds.manifest_filepath = None
cfg.train_ds.input_cfg = "input_cfg.yaml"
7% 的英语水平就足够了。FLEURS 的英语掌握率略有提高,从 11.04% 提高到 10.42% (见下文表 2) ,而该模型专门研究阿拉伯语方言。
桶式批量
第二个变化不太明显,也同样重要。
基于持续时间的分桶法将长度相似的语句分组到同一批量中:
cfg.train_ds.use_bucketing        = True
cfg.train_ds.num_buckets          = 30
cfg.train_ds.batch_size           = None
cfg.train_ds.batch_duration       = 400.0
cfg.train_ds.quadratic_duration   = 15.0
请注意,仅 num_buckets 不起作用;use_bucketing 默认为 False,因此在无标志的情况下设置存储桶数量是无提示的无操作操作,看起来是已配置的。
结果
以上三种变化加在一起,在两个 GPU 上实现了 12000 多个步长和大约 4.5 小时:
| 测试拆分 | 之前 | 之后 |
|---|---|---|
| SADA Najdi Hijazi WER | 55.05% | 29.96% |
| SADA Najdi Hijazi CER | 31.63% | 12.18% |
| 完整的 SADA WER | 58.84% | 35.61% |
| 完整的 SADA CER | 35.40% | 15.97% |
| FLEURS 英语 WER | 11.04% | 10.42% |
| FLEURS 英语 CER | 6.47% | 4.53% |
| FLEURS 阿拉伯语 WER | 12.67% | 11.41% |
| FLEURS 阿拉伯语 CER | 5.55% | 3.97% |
专业化并没有让我们放弃所放弃的方言。在我们瞄准目标的地方,该模型提高了 25 分,各方面改进了 23 分,同时英语也得到了改进。看起来是最终结果。所有数字均使用 NeMo 评估脚本测量。
4. 自适应深度:要更新的编码器数量
该模型有 24 个编码器层。完全微调会更新所有内容;冻结编码器可以保留它,但限制声音适应。在这中间,您可以解冻最上面的 N 层,留下其余层,同时始终训练解码器、连接网络和提示嵌入。
for parameter in model.parameters():
    parameter.requires_grad = False

for name, parameter in model.named_parameters():
    if any(part in name for part in ("decoder", "joint", "prompt")):
        parameter.requires_grad = True

for layer in model.encoder.layers[-8:]:
    for parameter in layer.parameters():
        parameter.requires_grad = True

trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
total = sum(p.numel() for p in model.parameters())
print(f"trainable: {trainable/1e6:.1f}M / {total/1e6:.1f}M")
在记录的 Top – 8 Recipe 中,2.304 亿个参数可训练,4.076 亿个参数可冻结。我们对两个深度进行了对比测试,但并没有改变其他任何深度:
| 编码器层已更新 | SADA WER | SADA CER |
|---|---|---|
| 预训练基准 | 55.05% | 31.63% |
| 前 6 名 | 33.42% | 14.10% |
| 前 8 名 | 32.32% | 13.53% |
| 共 24 个 | 29.96% | 12.18% |
训练能力越强大,每一步的表现就越出色。凭借 134 小时的目标语音,数据支持更新整个编码器,而部分冻结会在全微调时损失 2.4 个点。
这是关于此数据量的发现,而不是一般规则。冻结是一种减少支出的方法,因此当你的语料库比我们的更薄或者内存是绑定限制时,它就成为了正确的选择。
5. 无需重新训练即可改进:更大的上下文和束搜索解码
训练只是整个系统的一半。在为另一次训练付费之前,请检查推理时可以获得的结果。
此检查点显示了多个注意力上下文大小,无需重新训练即可进行选择。第二个数字是编码器在提交输出之前可以处理的未来帧数:[56, 3] 是串流默认值,[56, 13] 支持的最宽帧数。在不重新训练的情况下,切换到最高展望上下文可将 WER 降低 1.31 个绝对点。其主要折衷是增加约 800 毫秒的延迟。
| 配置 | WER | CER | 与贪婪 |
|---|---|---|---|
Greedy、[56, 3] |
29.96% | 12.18% | +0.00 |
Greedy、[56, 13] |
28.65% | 11.39% | -1.31 |
MALSD Beam-4、[56, 3] |
28.81% | 11.48% | -1.15 |
MALSD Beam-8、[56, 3] |
28.62% | 11.40% | -1.34 |
MALSD Beam-8、[56, 13] |
27.25% | 10.63% | -2.71 |
主要的取舍是增加延迟,而不是重新训练成本。每次输出前,13 帧 (而非 3 帧) 的缓冲时间大约增加了 800 毫秒。对于批量转录,例如通话存档、媒体、会议录像,无需重新训练即可提高准确性,并且可以接受额外的缓冲延迟。对于实时字幕,它可能不适合。正确的设置来自部署,而不是准确率。
声束搜索性能很大程度上取决于解码器配置。在之后的扫描中,NeMo 的批量处理 malsd_batch 策略以适中的成本获得了有用的收益:第 4 束将贪婪运行时间从 29.96% 降低到 28.81%,而第 8 束则在 0.64% 的情况下达到 28.62%。因此,4 号光束在我们的测试中提供了最佳的速度精度平衡。我们没有评估 MAES 或 NGPU-LM 融合,因此我们的结论仅限于 MALSD。
无论采用何种策略,一个细节都值得设置:strip_lang_tags=True。否则,系统会将区域设置标签作为文字文本发送,并对每个语音的插入内容进行评分。
| 注意力上下文 | 数据块大小 (延迟) | 用例 |
|---|---|---|
[56, 0] |
80 毫秒 (超低) | 超低延迟语音代理 |
[56, 1] |
160 毫秒 (低) | 交互式语音代理、对话式 AI |
[56, 3] |
320 毫秒 (平衡模式) | 对话式 AI、实时字幕 |
[56, 6] |
560 毫秒 (中级) | 准确性高,延迟合理 |
[56, 13] |
1.12 秒 (高) | 高准确度和高延迟 |
将工作流应用于其他语言
循环保持不变:整理、混合回放、选择适应深度、按持续时间分组、评估独立目标集和回归集。每种语言的变化是语料库元数据、转录规范、归一化、分词器覆盖率、脚本处理和能力指标。
对于另一种语言,您可以从小型的审核清单开始,并根据名称、数字、借用的单词和混合脚本句子测试基础分词器。将阿拉伯语规范化器替换为保留目标脚本中有意义区别的规范化器,并验证端到端 Unicode 规范化和编码。
对于没有空格词边界的语言,WER 可能会产生误导,改用字符、标记或语素级别的度量,并说明其限制。回放数据应代表您需要保留的功能,而不仅仅是方便的高资源语音,并且应真实存在,而非尽可能合成。
通过说话者对话词扩展工作流程
微调 ASR 可改善转录内容;说话者分类可添加说话者的讲话时间。在多扬声器音频中,Diarization 模型识别语音片段并分配一致的扬声器标签。通过将这些标签和时间与经过微调的 Nemotron 3.5 ASR 输出相结合,可创建发言者识别的转录文本,将每个参与者的词语分开,这对于会议、采访、联络中心、教室和其他多发言者环境非常有用。
此工作流还可以帮助语音数据提供商在数据用于 ASR 微调或评估之前,自动生成发言者转向时间和匿名发言者标签,以便进行人工审核,从而为多发言者语料库做好准备。
刚刚发布的 NVIDIA Nemotron 3 Diarization 扩展了这一工作流程,从支持方言识别的转录扩展到支持最多 8 位演讲者的演讲者识别转录。这是一个开放模型,可以添加到您正在使用的任何 ASR 系统中。Diarization 不会转录语音本身;其说话者边界和标签与 ASR 时间保持一致,以生成最终的结构化转录文本。在 Hugging Face 博客 中了解有关架构、基准测试和入门方法的更多信息。
后续步骤
在本教程的对话中,我们提出了一个比单纯的能力更重要的问题:如何使方言适应变得有用、改进目标方言、保留现有技能,以及在改变部署系统的地方投入训练精力。实验给出了实际答案。轻松整理,按权重混合回放,添加所需的确切行为示例,并在数据支持的情况下尽可能多地更新编码器。然后优化解码,并在一个独立的集合上评估每个能力。
开始使用
微调 Notebook:https://github.com/nvidia-riva/tutorials/blob/main/asr-finetune-nemotron-3.5-asr-streaming-prompt.ipynb
微调技能:https://github.com/NVIDIA/skills/tree/main/skills/nemotron-asr-finetune


