

在数千个 GPU 上训练大规模 AI 模型是一项高风险操作,必须内置监控和自动化,才能大规模优化集群弹性和正常运行时间。对于数据中心运营商而言,这一概念并不陌生,他们在 AI 工厂出现之前就已经测量过平均修复时间 (MTTR) 和平均故障间隔时间 (MTBF) 。
现在的风险更高。现代 AI 工厂 在数百个节点上连续数天或数周运行分布式训练作业,在这种规模下,运营模型会发生变化:必须主动管理硬件异常、软件错误、网络超时和资源争用,才能保证工作负载按部就班地进行。当组织在共享基础设施中运行数十个并发多节点工作负载时,依赖人工干预、静态检查点和被动监控的传统方法根本无法扩展。
这就是为什么软件服务 (如 NVIDIA Mission Control 中提供的自主恢复引擎) 对于扩展生产级 AI 至关重要。以前,可以检测、诊断堆栈中的异常情况并进行恢复的自主恢复引擎仅限于利用 Slurm 的高性能计算 (HPC) 工作负载。作为 Mission Control 2.5 的一部分,该服务现已扩展到使用 NVIDIA Run:ai 管理的基于 Kubernetes 的工作负载。
本文将介绍新版 Mission Control 如何将其集成式弹性框架引入 Kubernetes 工作负载,帮助 AI 工厂运营从被动操作维护转向主动、自我修复的基础设施。
内置弹性服务
Mission Control 自主恢复引擎的愿景很简单:AI 工厂应该是自我修复系统,能够立即检测到故障,根据工作负载上下文和故障类型智能地做出恢复决策,并在尽可能减少中断或计算浪费的情况下自动恢复作业。
其目标是了解故障原因,隔离异常并对其进行标记以进行维护,并以尽可能少的时间将工作负载恢复到生产计算。
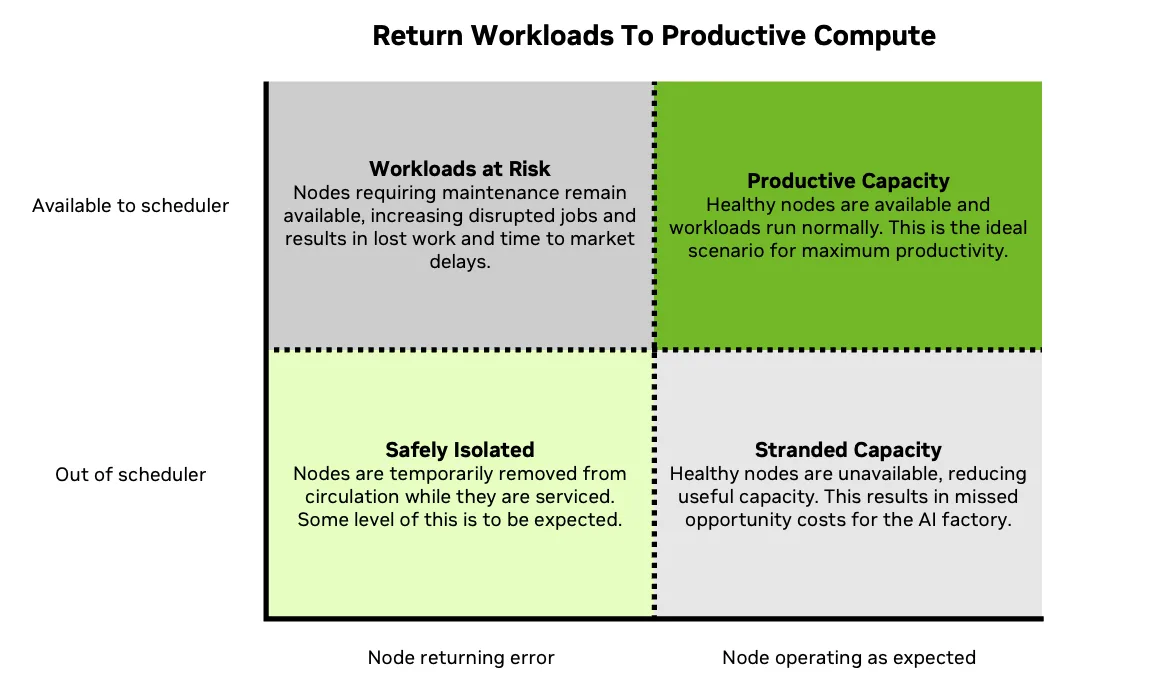
自主恢复引擎包含两项服务:
- 自主作业恢复
- 自主硬件恢复
由于真正的自我管理弹性最好理解为控制循环而不是单一恢复功能,因此自主恢复引擎随后与工作负载调度程序 ( HPC 或 Kubernetes) 配合使用,提供一个集成的三层框架,其中每个组件发挥着独特但协调的作用。
在本文中,我们将重点介绍如何调度基于 Kubernetes 的工作负载。
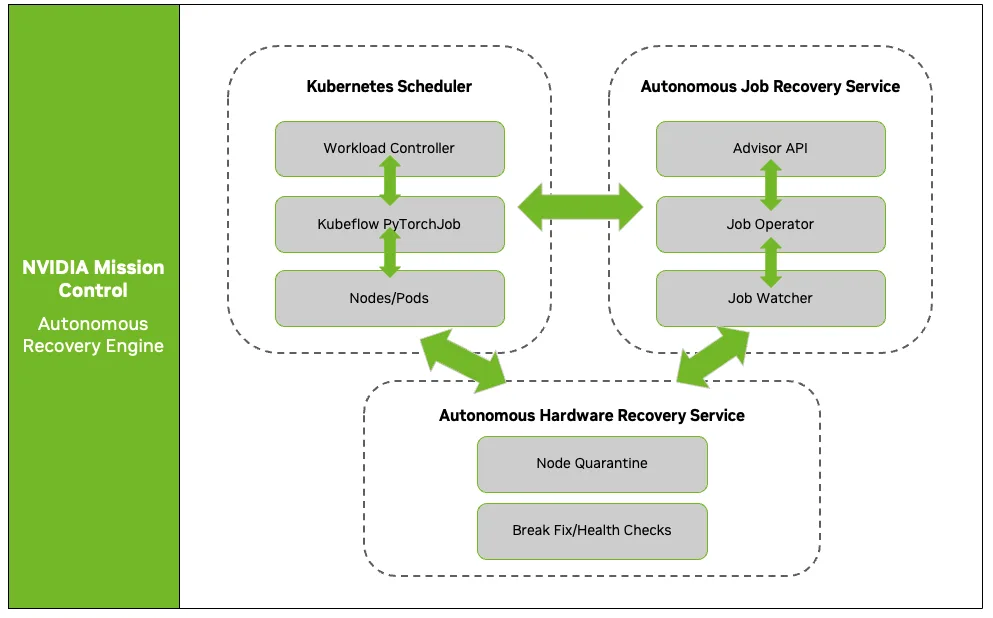
循环中的三个角色
我们先从 Kubernetes 工作负载放置层开始。在 Mission Control 中,NVIDIA Run:ai 是 Kubernetes 的默认调度程序,并作为软件的一部分提供。它管理基于 Kubernetes 的 AI 工作负载、队列、策略,并将作业调度到可用容量。
自主作业恢复服务提供工作负载上下文层。它会监视正在运行的作业,跟踪每个作业的执行位置,并使用故障历史记录和作业拓扑来分类合理的恢复路径。资源管理器集成决定了该指南如何转变为重启、重试、重新排队或放置操作。
自主硬件恢复服务是基础设施健康层。它监控节点和 GPU,在需要时从调度中消除异常,并运行诊断或补救措施,以免硬件问题不断扩散到新作业。
将这些职责分开是模型可移植的原因。自主作业恢复服务不需要维修硬件,硬件恢复服务也不需要了解每个训练框架。最后,调度程序可以将工作负载转向可用容量,而无需等待根本原因诊断。
故障路径的实际应用
以下场景展示了控制回路在 Mission Control 中的不同表现,具体取决于其自主恢复引擎检测到的故障信号。
场景 1. 训练过程中的硬件故障
当一个 GPU 开始出现故障时,分布式训练作业会在 GPU 池中运行。症状可能首先表现为 ECC 错误、作业挂断或作业中的通信超时。
重要的是接下来会发生什么:恢复分为两个并行轨道。自主作业恢复服务可捕获作业上下文并识别可疑节点或 GPU。然后,Kubernetes 调度程序集成通过重启或重新调度作业来推进工作负载恢复。
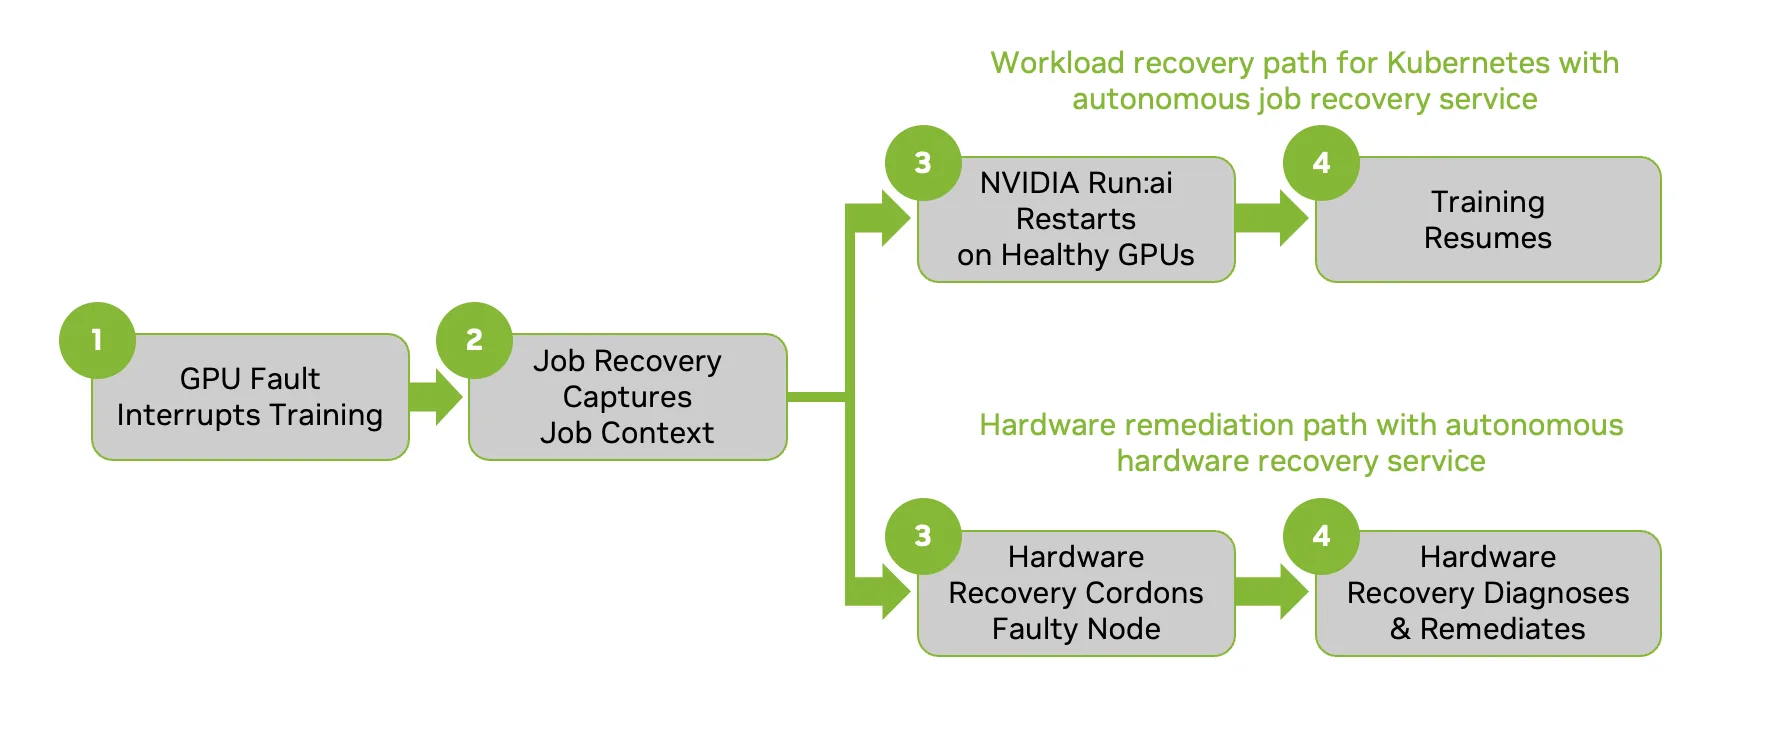
同时,自主硬件恢复服务会隔离出问题节点,记录原因并启动诊断。即使在工作负载再次移动后,该硬件路径也可以继续。
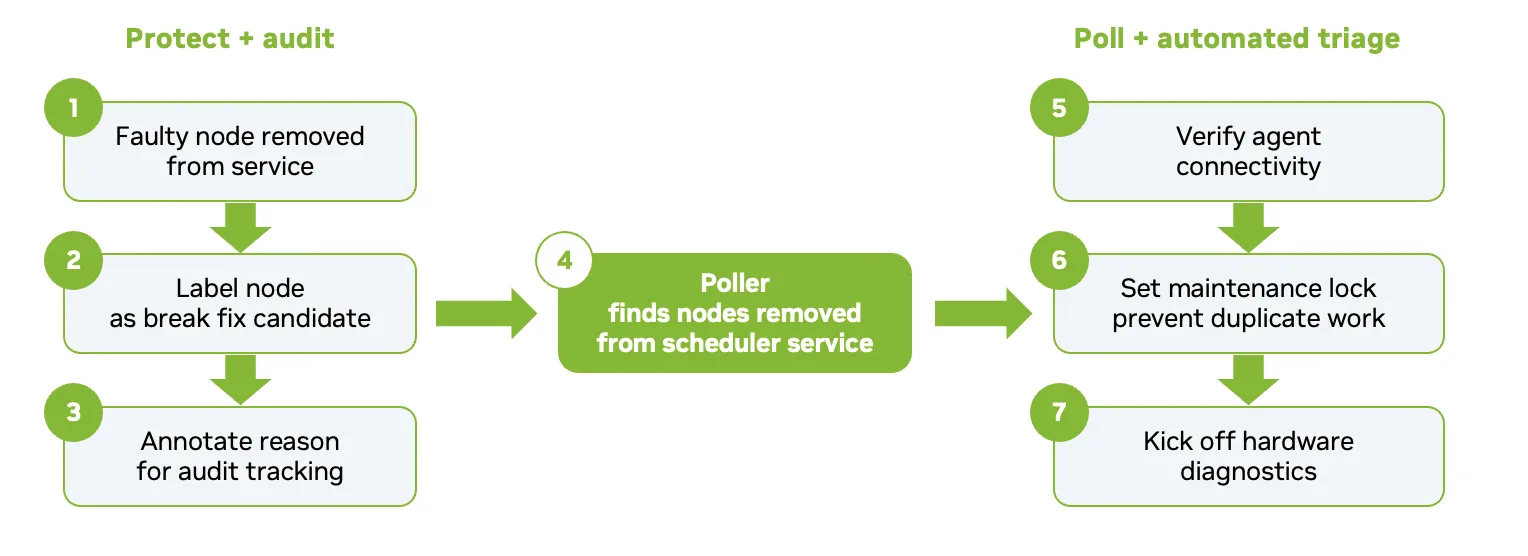
此路径的价值在于减少停机时间。工作负载不会在恢复开始前等待根本原因分析,并且不会意外将故障节点交给下一项作业。
场景 2. 瞬变软件故障
并非每个作业故障都应触发硬件修复。训练工作者可能会退出,遇到可恢复的超时,或在底层节点正常运行的情况下暂时失去协调。
在此路径中,自主作业恢复服务使用作业上下文来避免反应过度。如果故障历史记录看起来很短暂,系统会根据调度程序策略重试,而不是隔离不需要维修的硬件。
虽然 NVIDIA Run:ai 对恢复的表述可能不同于 Slurm 的处理方式,但其意图是相同的:在不进行不必要的硬件修复的情况下将工作负载恢复为高效执行。自主硬件恢复服务会在后台持续进行监控,但除非有新的证据指向硬件,否则它不会进入恢复路径。
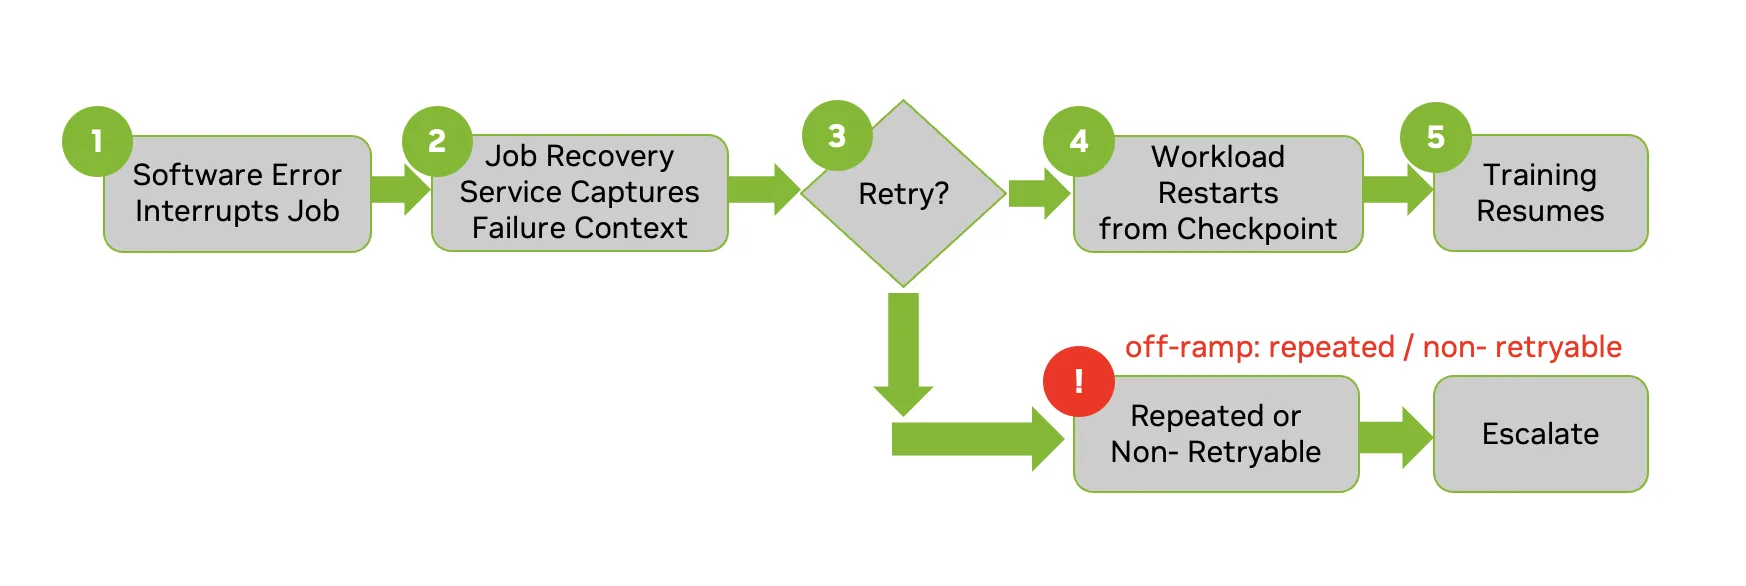
此路径的价值在于约束。系统可恢复工作负载,而不会产生不必要的操作员噪音或缩减调度池。
场景 3. 早期发现的硬件降级现象
Mission Control 中的自主硬件恢复服务还可以在基础设施性能下降成为作业故障之前进行检测。节点可能会开始反复显示 GPU 运行状况警告、连接问题或其他信号,这些信号会给未来调度带来风险。
在此路径中,自主硬件恢复服务可以主动从调度程序资格中删除该节点,并在 AI 训练任务完成之前开始诊断。自主作业恢复服务可能永远不需要响应,因为在中断工作负载之前,系统会将故障容量从循环中移除。
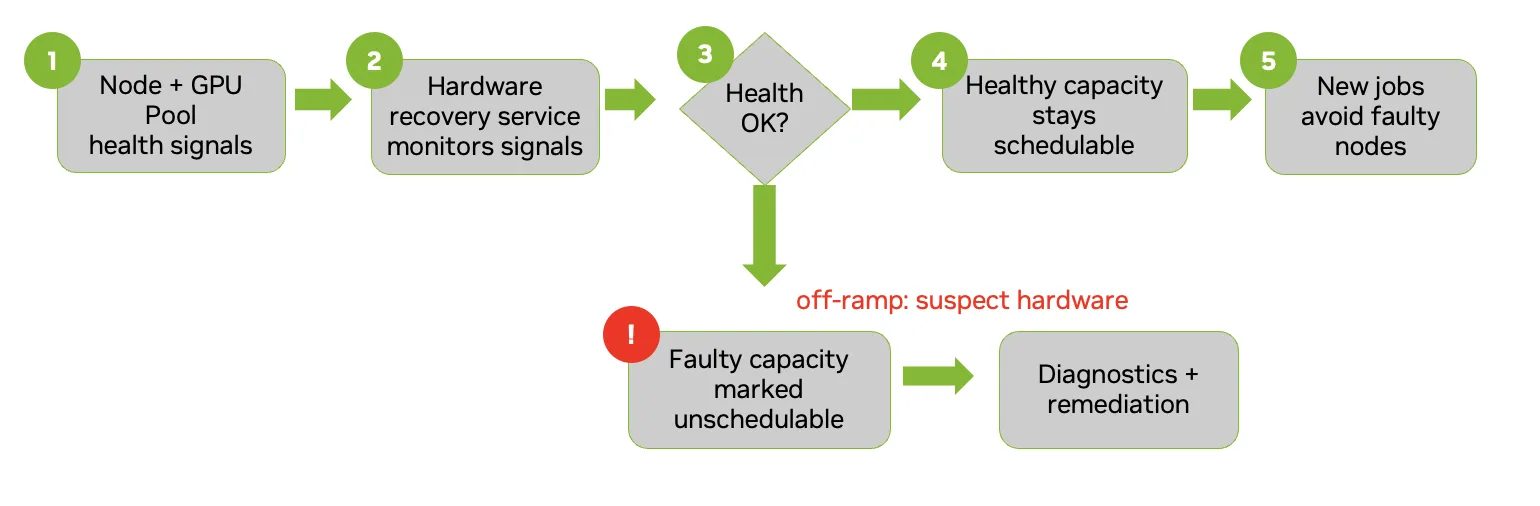
在这种情况下,Mission Control 基于 Kubernetes 的调度程序将受益于更简洁的可用资源池。它可以避免将 Kubernetes 工作负载置于可疑容量上,这与 Mission Control 使 Slurm 在再次验证之前将故障节点排除在分配之外的方式类似。
这条道路的价值在于预防。该系统降低了已知风险节点成为未来 AI 训练中断的可能性。
运营影响
Mission Control 的自主恢复引擎扩展到 NVIDIA Run:ai,标志着 AI 工厂朝着实现自我修复的目标又迈进了一步。这种结构将弹性从调度程序特定的事件工作流转变为调度程序感知型操作模型。
对于平台团队而言,Mission Control 2.5 可在其 Kubernetes 和 Slurm 资产之间提供一致的恢复模型。故障节点会被隔离、标注或记录,并被诊断出来,只有在准备就绪时才会返回服务。
对于 AI 从业者来说,现在 Slurm 和 Kubernetes 用户都可以从更简单的恢复中受益。作业可以根据其已使用的调度程序重新启动、重试或重新排序,而自主恢复引擎则提供所需的上下文,以避免需要维护的基础设施重复发生故障。
对于企业而言,其优势在于能够更好地利用宝贵的加速器容量。该系统减少了因模糊性而停滞的时间,并将更多时间用于保持训练工作负载的效率。
视频 1. NVIDIA Mission Control 演示:基于 Kubernetes 的工作负载的自主恢复能力
开始使用 Mission Control 2.5
Mission Control 2.5 现已推出。NVIDIA Mission Control 的现有用户可以访问文档中心,详细了解如何升级到最新版本。除了将自主恢复引擎扩展到基于 Kubernetes 的工作负载之外,其他版本亮点包括:
- 全新支持 AI 的网络异常检测服务 (仅限测试版)
- 使用中心键斗鱼,改善了用户在跨服务身份验证方面的体验
- 其他安全性和 Kubernetes 强化更新
- 抢先体验 NVIDIA Vera Rubin NVL72
在此处阅读完整的版本说明here或阅读解决方案概述,详细了解 NVIDIA Mission Control 如何使用涵盖工作负载编排、端到端监控和自主恢复的企业就绪型软件简化 AI 工厂运营。

