

GPU 集群可以通过每一次运行状况检查,但仍然无法运行 AI 工作负载。即使每个 GPU、网络链路和 POD 都报告正常,512-GPU 训练作业也可能表现不佳或失败。其原因可能是 GPU 运行缓慢、链路在负载下性能下降,或者配置在较慢的路径上悄无声息地路由流量。操作员可能会在运行几小时或客户提交工单后才发现问题。然后,当容量处于闲置状态时,团队可以花费数天时间对集群进行分割,找出根本原因。
NVIDIA 集群就绪引擎 (NVCRE) 是一个开源 Kubernetes 控制器,可在生产工作负载落地之前将搜索范围缩小到所涉及的特定节点。它跨拓扑感知节点组运行真实的分布式工作负载,测量结果,并报告哪些节点在每次测试中都失败了。运营商不再需要手动编写 NVIDIA 集合通信库 (NCCL) 清单、手动分割机架或从客户工单中了解硬件降级。就绪性成为集群的一个经过验证的属性,而不是一种假设。
证明就绪性需要什么?
GPU 集群分阶段准备就绪。它经历了启动、老化、预生产和生产阶段,每个阶段都设定了不同的标准。通过烟雾测试的节点不一定准备好加入 512-GPU 训练运行。
平台团队通常会在围绕 NCCL 测试的运行手册、电子表格或 shell 脚本中对该进度进行编码。它成为他们必须构建和维护的另一个系统,以及节点配置、GPU 共享和工作负载编排。
集群可以通过标准诊断,但在实际分布式作业下仍然失败,因此测试准备情况的最佳方法是运行工作负载。在 Slurm 上,这需要一个 srun 命令。Kubernetes 没有内置等效数据,因此相同的测试需要 GPU 和远程直接内存访问 (RDMA) 资源请求、与网络结构匹配的 NCCL 设置、足够大的共享内存卷,以及确保所有 POD 一起启动的方法。
NVCRE 填补了 Kubernetes 上的这些空白。它运行的工作负载会暴露实际的硬件问题,并确切地命名导致每次故障的节点。
communication/nccl-all-reduce
Status:       Failed
Runtime:      42m 18s
Scale:        full-scale
Nodes/Job:    8

Failed Nodes:
  gpu-node-07  ThresholdViolation
  gpu-node-12  HardwareFailureDetected

Summary
Categories:   1/2 passed
Failed Nodes: 2
Result:       FAILED
NVCRE 的工作原理
API 是产品表面。自定义资源定义 (CRD) 可定义每个资源,因此您可以使用 kubectl 检查这些资源,并通过 GitOps 工作流进行管理。
分层 API
该 API 在层次结构中安排了三个资源。
- 认证:您创建的资源。它为要测试的节点和要运行的类别命名。
- 工作流:管理一个类别。它应用目录、平台和 GPU 优设;管理迭代数量;设置编排目标;并创建子作业。
- 作业:运行目标节点组的工作负载,监控节点运行状况,并记录测量结果和故障。
认证会为每个类别创建一个工作流,每个工作流都会创建相应的子作业。
然后,结果会向上传播。作业会记录哪些节点发生故障及其原因,工作流会报告测试结果,认证组会按类别报告结果。
该层次结构将每个故障归因于特定节点和类别。例如,一次运行报告显示 gpu-01 在 NCCL 期间发生硬件故障,并且 gpu-02 未达到带宽目标。
验证集群
以下示例展示了认证如何命名其目标和要运行的类别。
apiVersion: nvcre.nvidia.com/v1alpha1
kind: Certification
metadata:
  name: gpu-cluster-cert
spec:
  target:
    nodeSelector:
      nvidia.com/gpu.present: "true"
  categories:
    - domain: communication
      variant: nccl-all-reduce
    - domain: training
      variant: nemotron5-8b
$ kubectl apply -f certification.yaml
$ kubectl get certifications.nvcre.nvidia.com -w
内置目录目前涵盖三个领域:五种 NCCL 通信变体 ( all-reduce、all-gather、all-to-all、loopback 和 跨 NVIDIA NVSwitch 的 loopback) 、NVIDIA Data Center GPU Manager (DCGM) L4 级诊断套件,以及使用 8B 和 56B 参数的 NVIDIA Nemotron 5 模型进行的 NVIDIA NeMo 预训练。每个条目都包含平台感知型默认值。
NVCRE 可从目标节点中检测 GPU 架构和云平台,并获取其余配置,包括每个节点的 GPU、NCCL 环境和特定于平台的网络。
将条件传递为表达式
通过和失败标准使用通用表达式语言 (CEL) ,并根据测量指标进行评估。默认情况下,无值。以下值为 NVIDIA GB200 NVL72 级系统的示例。
  categories:
    - domain: communication
      variant: nccl-all-reduce
      options:
        thresholds:
          busBandwidthGBps: "value >= 900"
    - domain: training
      variant: nemotron5-8b
      options:
        thresholds:
          goodputRatio: "value >= 0.9"
          avgTFLOPsPerGPU: "value >= 800"
当测量的指标未达到目标时,NVCRE 会设置 ValidationFailed 条件,该条件与运行本身是否成功分开记录。工作负载完成但未达到目标时,仍会被报告为失败。
在出现故障的地方进行大规模测试
某些故障仅在特定规模下可见,因此分组策略是明确的。testScale 字段选择该策略。
- 节点内独立测试每个节点。
- 机架内使用
nvidia.com/gpu.clique标签按拓扑域对节点进行分区。 - Full-Scale 将每个节点放入单个组中。
- Diagnose 运行自适应故障隔离 (后面将介绍) 。
您选择的策略决定了要测量的内容。一个 NVIDIA NVLink 域中的 NCCL 测试用于测量 NVLink 带宽,而三个机架中的相同测试用于测量横向扩展结构。这两种方法的衡量标准各不相同。
自适应故障隔离
多节点验证中最难的情况是无法归因于任何单个节点的故障。64 节点 all-reduce 返回低带宽,并且组中的每个节点都具有同等相关性。手动找出原因可能需要数天的工程时间。
NVCRE 可自动实现这种隔离。设置 testScale: diagnose 可运行拓扑感知型分层组测试。引擎会拆分每个失败组,重新运行两部分,然后继续运行,直到到达 minGroupSize。仍无法达到该规模的群组会被标记为可疑群组。maxConcurrent 会限制同时运行的作业数量,使其不会使所测量的结构饱和。
输出将命名为少数可疑节点,而非暗示整个组,并说明每个节点失败的原因。
运行任何工作负载:WorkloadRun API
在 Kubernetes 上运行多节点 GPU 工作负载需要平台检测、框架特定的运行时配置、GPU 和网络资源请求,以及在运行失败后进行清理。这种设置重复且容易出错。
WorkloadRun 负责处理设置:提供容器镜像、选择框架并指定节点数量。
apiVersion: nvcre.nvidia.com/v1alpha1
kind: WorkloadRun
metadata:
  name: nccl-all-reduce
spec:
  image: nvcr.io/nvidia/pytorch:26.01-py3
  framework:
    mpi:
      binary: /usr/local/bin/all_reduce_perf_mpi
      args: ["-b", "8", "-e", "32G", "-f", "2", "-n", "100"]
      mpirunPath: /usr/local/mpi/bin/mpirun
  numNodes: 4
  bandwidthMeasurement:
    logProfileRef: nccl-bandwidth
    testType: all_reduce
framework 字段完全支持 torch (通过 torchrun 进行分布式训练) 、mpi ( NCCL 测试和其他 MPI 工作负载) 或 exec (任意命令) 中的任意一个。NVCRE 会生成匹配的 Kubeflow TrainingRuntime,注入共享内存卷,设置 NCCL 和平台环境变量,并在硬件支持的位置启用 NVIDIA NVLink 纵向扩展网络。
如果没有帮调度程序,Kubernetes 默认调度程序会独立放置 Pod,并在框架会合中为其对等节点排序。在繁忙的集群中,这可能会导致死锁:部分放置的 pod 会容纳 GPU,同时等待从未到达的节点。设置 spec.gangScheduler 可将每个工作负载 pod 选择为可感知的群组调度程序,例如 KAI Scheduler,该程序会保存所有 pod,直到可以一次性放置整个群组。
由于 WorkloadRun 是普通 CRD,因此外部工具可以使用它来运行工作负载,而无需采用 NVCRE 的其余部分。NVCRE 提供执行路径,调用工具提供测试。
大规模配置、验证和监控 AI 集群
集群在走向生产的道路上必须回答三个问题:是否配置正确?是否已准备好运行真正的 AI 工作负载?现在是否健康?一个不同的 NVIDIA DSX OS 层可以解决每个问题。
NVIDIA AI 集群运行时 (AICR) 可建立并维护经过验证的集群配置。AICR 可捕获经过验证的驱动、运算符、内核和系统设置组合,并将其作为版本锁定的方法。团队可以跨集群重现相同的优化配置、验证实时状态并检测漂移。这减少了性能变化,并避免了在昂贵的 GPU 闲置期间进行数天的调整。
NVCRE 可验证集群是否已准备好运行真实的 AI 工作负载。此工作负载驱动的活动层会生成负载,因此可以找到不产生遥测数据的故障。单个降级的 GPU 会将同步训练作业的速度减慢到最差等级,而 NCCL 带宽测试可以在几分钟内发现问题。
NVIDIA NVSentinel 持续监控集群运行状况。作为被动的遥测驱动层,它监视集群已经产生的信号,包括 DCGM 指标、Xid 错误、系统日志和云提供商维护事件。它可以检测运行时故障,并推动隔离、排水和修复工作流。由于它不消耗 GPU 时间,因此可以在生产环境中连续运行,而主动测试会占用 GPU 的时间来处理工作负载。
每个项目都能独立提供价值,并与运行整个堆栈的团队的其他项目进行集成。
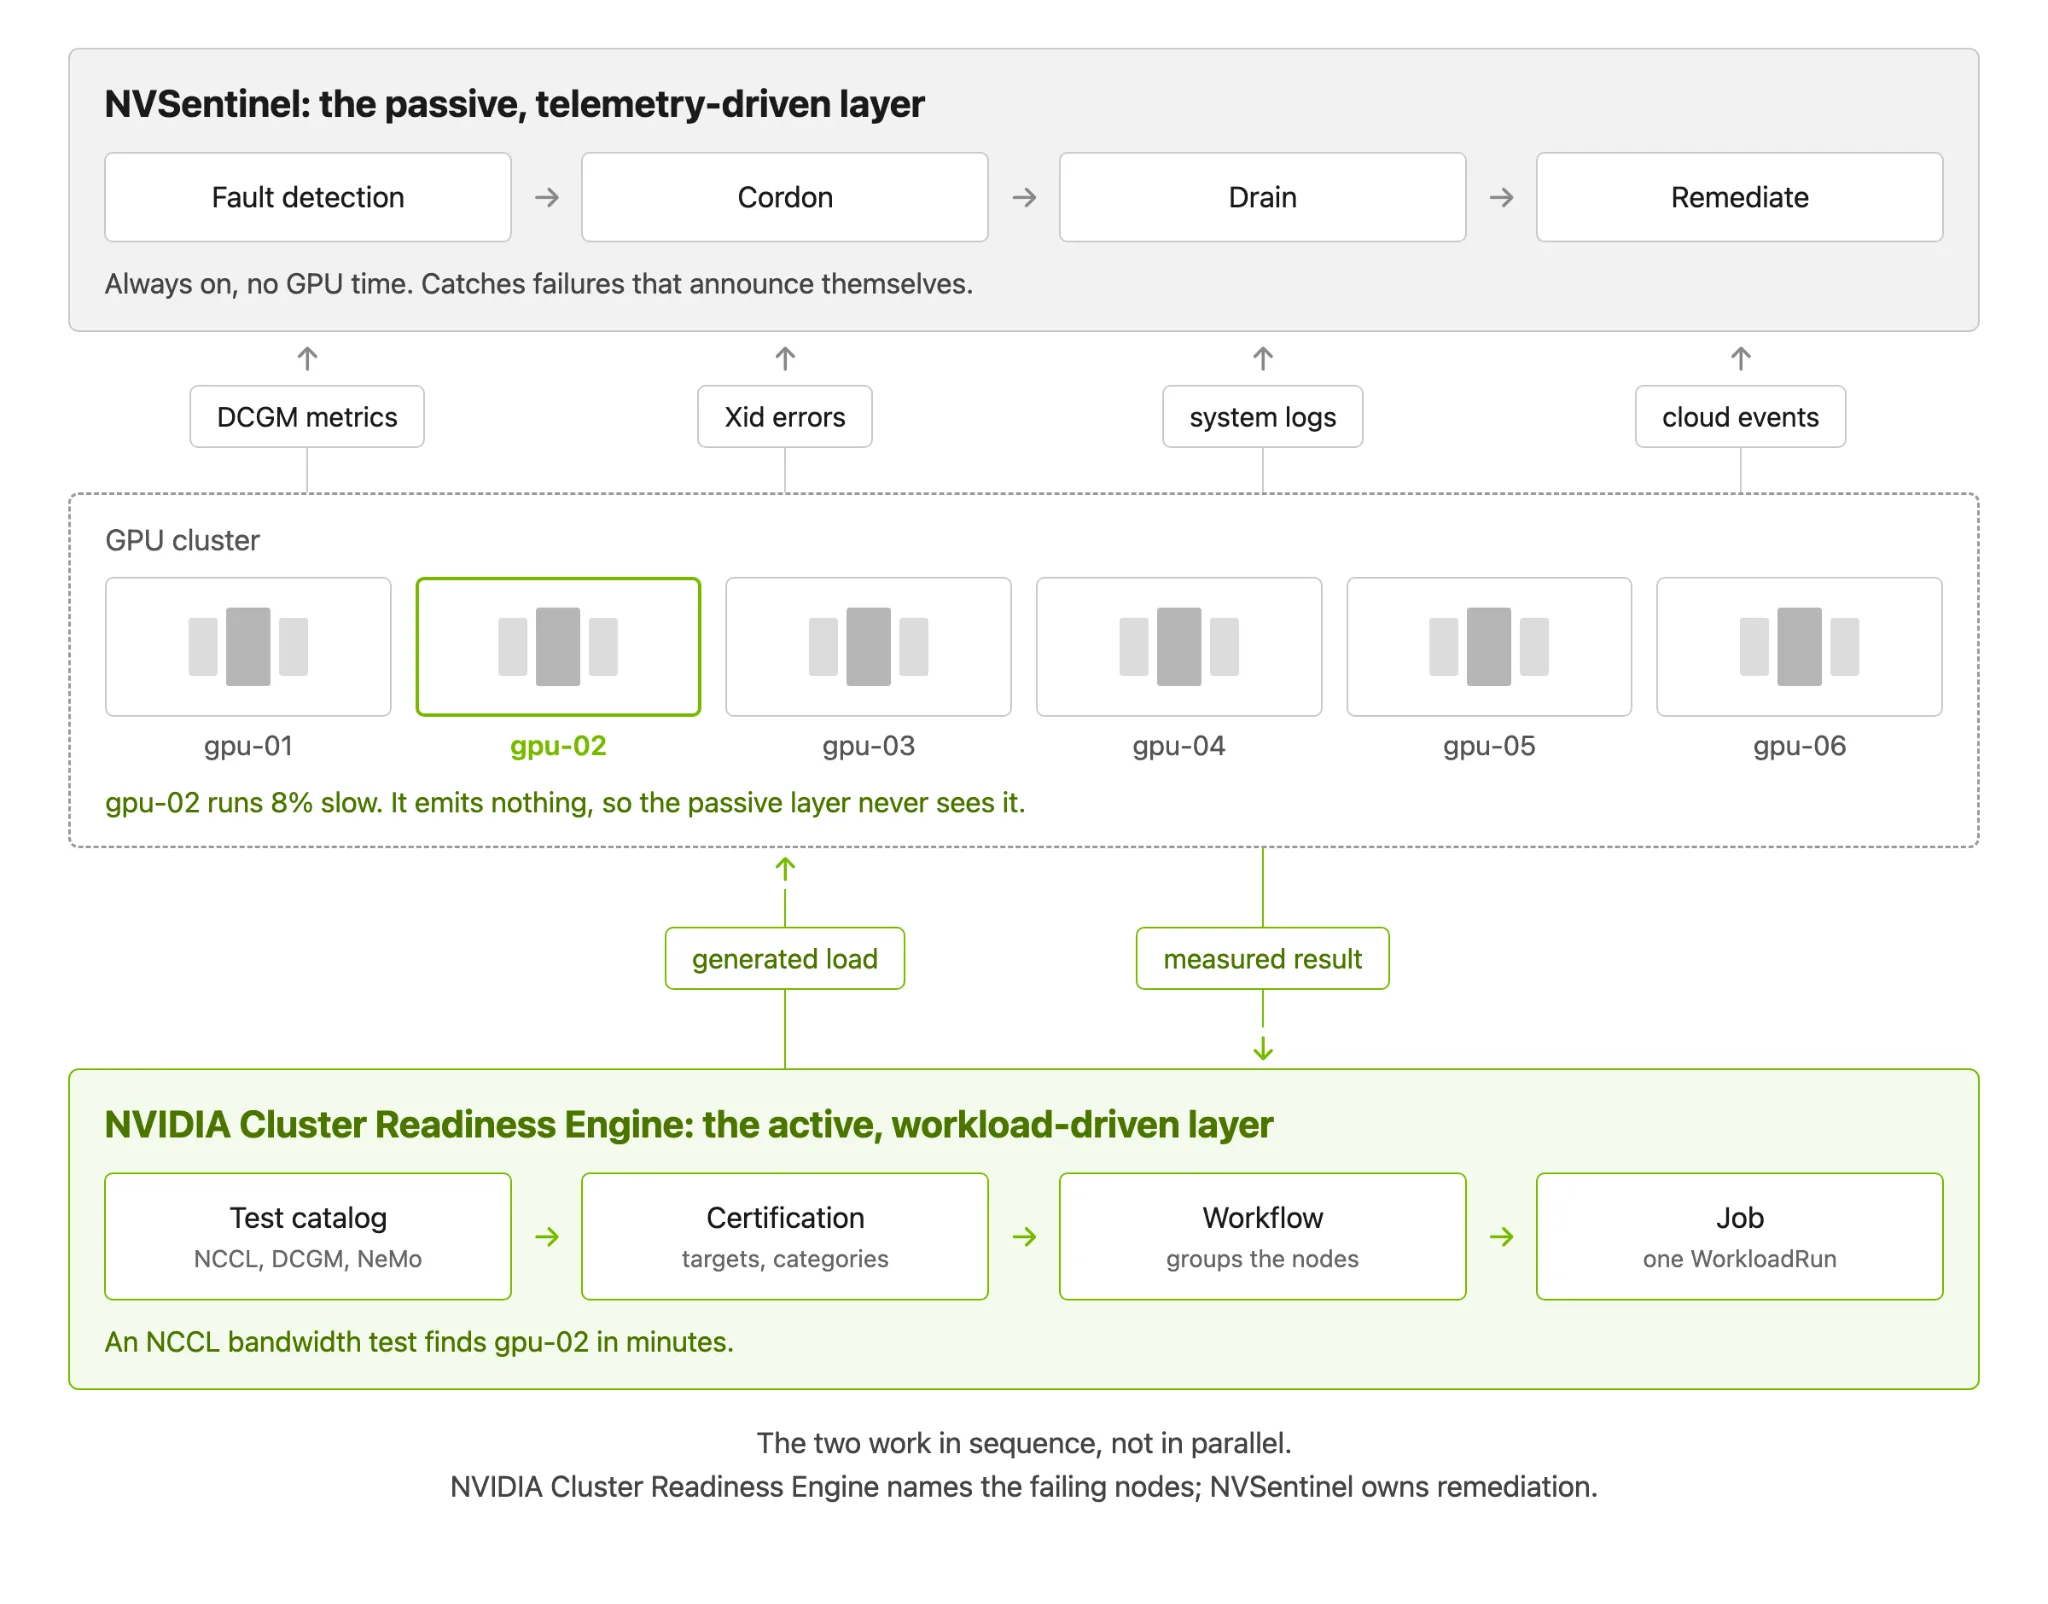
NVCRE 记录失败节点和原因。它不会封锁、污损或修补节点条件,从而避免操作冲突和非同步清理。NVSentinel NVCRE 认证监视器可以将认证失败的结果转化为健康事件。配置的 NVSentinel 策略可以隔离和释放节点,或触发外部补救。后续成功的认证可以清除故障信号并释放污点。
开始使用
NVCRE 需要目标集群上的 Kubernetes 1.29 或更高版本、kubectl、Helm 3.x 和 NVIDIA GPU Operator。NVIDIA GB200 NVL72 和 NVIDIA GB300 NVL72 目录条目还需要适用于 GPU 的 NVIDIA DRA 驱动程序,因为这些条目会创建计算域资源。DCGM L4 类别需要独立的 DCGM 服务。KAI Scheduler 等帮组感知调度程序是可选项,但建议在繁忙的共享集群上使用。
安装 CLI 并设置集群。nvcrectl setup init 命令用于安装 CRD、控制器、Kubeflow Trainer 和默认日志配置文件。
$ curl -fsSL https://github.com/NVIDIA/cluster-readiness-engine/releases/latest/download/installer | bash
$ nvcrectl setup init
然后运行端到端验证。
$ nvcrectl certification run --cert-file certification.yaml --wait
$ nvcrectl certification report gpu-cluster-cert -n <namespace>
以下报告列出了每个类别的状态、运行时、测量带宽和任何故障节点,以及每次故障的原因。
Certification Report

Name:     gpu-cluster-cert
Platform: aws
GPU:      gb300
Nodes:    16

communication/nccl-all-reduce
Status:       Succeeded
Runtime:      3m 56s
Scale:        full-scale
Nodes/Job:    16
MNNVL:        Enabled

Bandwidth:
  Size       AlgBW        BusBW        Samples
  16 GB      473.44 GB/s  932.09 GB/s  9

Summary
Categories:   1/1 passed
Failed Nodes: none
Result:       PASSED
参与
NVCRE 在 Apache 2.0 下获得许可,并在开放环境中开发。在 GitHub 上发送拉取请求之前,报告错误、请求功能或提出更改建议。您还可以提供目录条目、工作负载适配器、测试和文档。
在生产前使用该引擎验证 GPU 集群。其共享工作流和测试目录在 Kubernetes 集群中持续运行,并为新的 NVIDIA 架构、推理和自动生命周期验证提供路线图支持。
在下一个生产工作负载到来之前验证您的 GPU 集群。
该项目是 NVIDIA DSX OS (NVIDIA DSX AI 工厂平台) 的一部分。

