

自主智能体可以工作数小时处理复杂任务,访问文件、工具、互联网,并催生其他智能体进行协作。长时间执行复杂任务会增加风险:智能体可能会下载代码、构建新工具、请求额外权限,并触及更多底层基础设施。
智能体的行动路径是在他们工作和推理完成目标所需的步骤时确定的。当它们与周围的工具和系统交互时,它们会调整推理和行为以完成任务。
智能体的适应性使其如此强大,但它们以目标为导向,在追求目标时可能不会优先考虑安全。为了让智能体能够自主且安全地工作,我们需要构建环境,以提供对智能体工作的控制和可见性。
智能体无法自我治理。安全和治理属于智能体运营的基础设施。
OpenShell 可在智能体能力范围之外提供确定性治理
NVIDIA OpenShell 是一个开源运行时,用于将代理式系统所需的安全性和治理性构建到计算基础设施中。OpenShell 定义并执行智能体可以访问的系统和数据,从文件和互联网服务到与物理设备交互的系统。
它是 NVIDIA OpenShell 参考架构 的基础,用于构建安全的 AI 智能体。OpenShell 在整个执行过程中将智能体工作负载视为不受信任。智能体可以在需要时访问所需内容。
OpenShell 包含四个关键组件:
- 网关:管理沙盒生命周期和策略的控制平面
- Supervisor:根据策略检查出站请求,并协调对凭据的访问。这完全独立于沙盒运行
- 沙盒:隔离智能体工作负载,限制文件系统和进程访问
- 策略验证器:添加形式验证,检查策略的权限是否仍在组织定义的上限内。
随着智能体的发展,这些组件提供了基础设施控制,使它们能够安全地工作。
扩展和集成 OpenShell
可扩展性是 OpenShell 设计的核心原则。借助 Supervisor 中间件,您可以检查、阻止或更改智能体通过网络收发的内容,并将其作为额外的执行层。通过网关拦截器,运算符无需修改网关,即可向 OpenShell 控制平面操作添加特定于部署的治理机制。
组织还需要确定智能体的行动对象、所拥有的权限,以及一项行动是否适合任务。识别、授权、数据保护和审核该问题的每个解决部分。OpenShell 提供了可集成这些系统的执行点。
在参考架构中,OpenShell 在 NVIDIA Vera CPU 上运行。
NVIDIA Vera,控制器下方的计算层
OpenShell 定义了智能体的功能。Vera 决定了他们的创作速度。智能体通过从属步骤循环运行,每个步骤必须在下一步开始之前完成:推理、调用工具、执行代码、查询数据。
AI 工厂同时运行数千个此类循环,在五个维度上对 CPU 架构提出了新的要求:
- 它们需要大量核心来运行多个并发工作流,并需要快速的单个核心来缩短每个连续步骤。
- 它们需要高带宽网络和内存,以确保这些核心能够依赖实时数据代理。
- 他们需要大量 I/ O 来在 CPU、GPU、存储和网络之间快速移动数据。
- 它们需要硬件增强的安全性,因为代理越来越多地处理敏感的企业数据,并且必须相互隔离并与主机隔离。
- 他们需要在现代数据中心的功率范围内提供所有这些功能 (每瓦特更多的坐席工作量,而不仅仅是更高的原始性能) 。
NVIDIA 将这种组合称为大规模单线程 CPU 的最大组合,而NVIDIA Vera正是为此而打造:庞大的Olympus核心、第二代可扩展一致性结构、LPDDR5X内存、第6代I/O、机密计算,以及专为功耗受限的数据中心打造的节能设计。
三种架构属性助力 Vera 快速处理智能体工作负载
- 首先,由 NVIDIA 设计的 88 个 Olympus 核心具有 10 宽前端、神经分支预测器和深度乱序执行能力,与 x86 相比,可提供高达 2 倍的关键智能体工作负载性能,从而缩短每次工具调用、代码执行和评估的时间。
- 其次,与 x86 替代产品相比,Vera 的第二代 Scalable Coherency Fabric 可提供高达 3 倍的核心到核心带宽,并将核心到核心延迟降低高达 50%,从而在负载情况下可预测地传输数据。Vera 还集成了 96 通道的 PCIe Gen 6,提供 I/ O 带宽,以连接 GPU、高速存储和网络,满足吞吐量代理式基础设施的需求。
- 第三,高达 1.2 TB/s 的 LPDDR5X 显存带宽,与基于小芯片的设计相比,加载显存延迟降低高达 40%,可为代理提供所需的实时环境,而不会阻碍显存访问。LPDDR5X 还显著提高了 Vera 的效率:Vera 的每瓦性能是 x86 CPU 的 2 倍,而 LPDDR5X 内存子系统本身的功耗比基于 DDR5 的内存配置低一个数量级,从而在相同的功率范围内支持更多代理工作。
智能体的工作负载依赖于沙盒:在隔离的执行环境中,智能体可以运行代码、调用工具并完成任务,而不会相互影响或干扰主机系统。这些沙盒的密度越高、速度越快,在给定的基础设施占用空间内,智能体的工作量就越大。
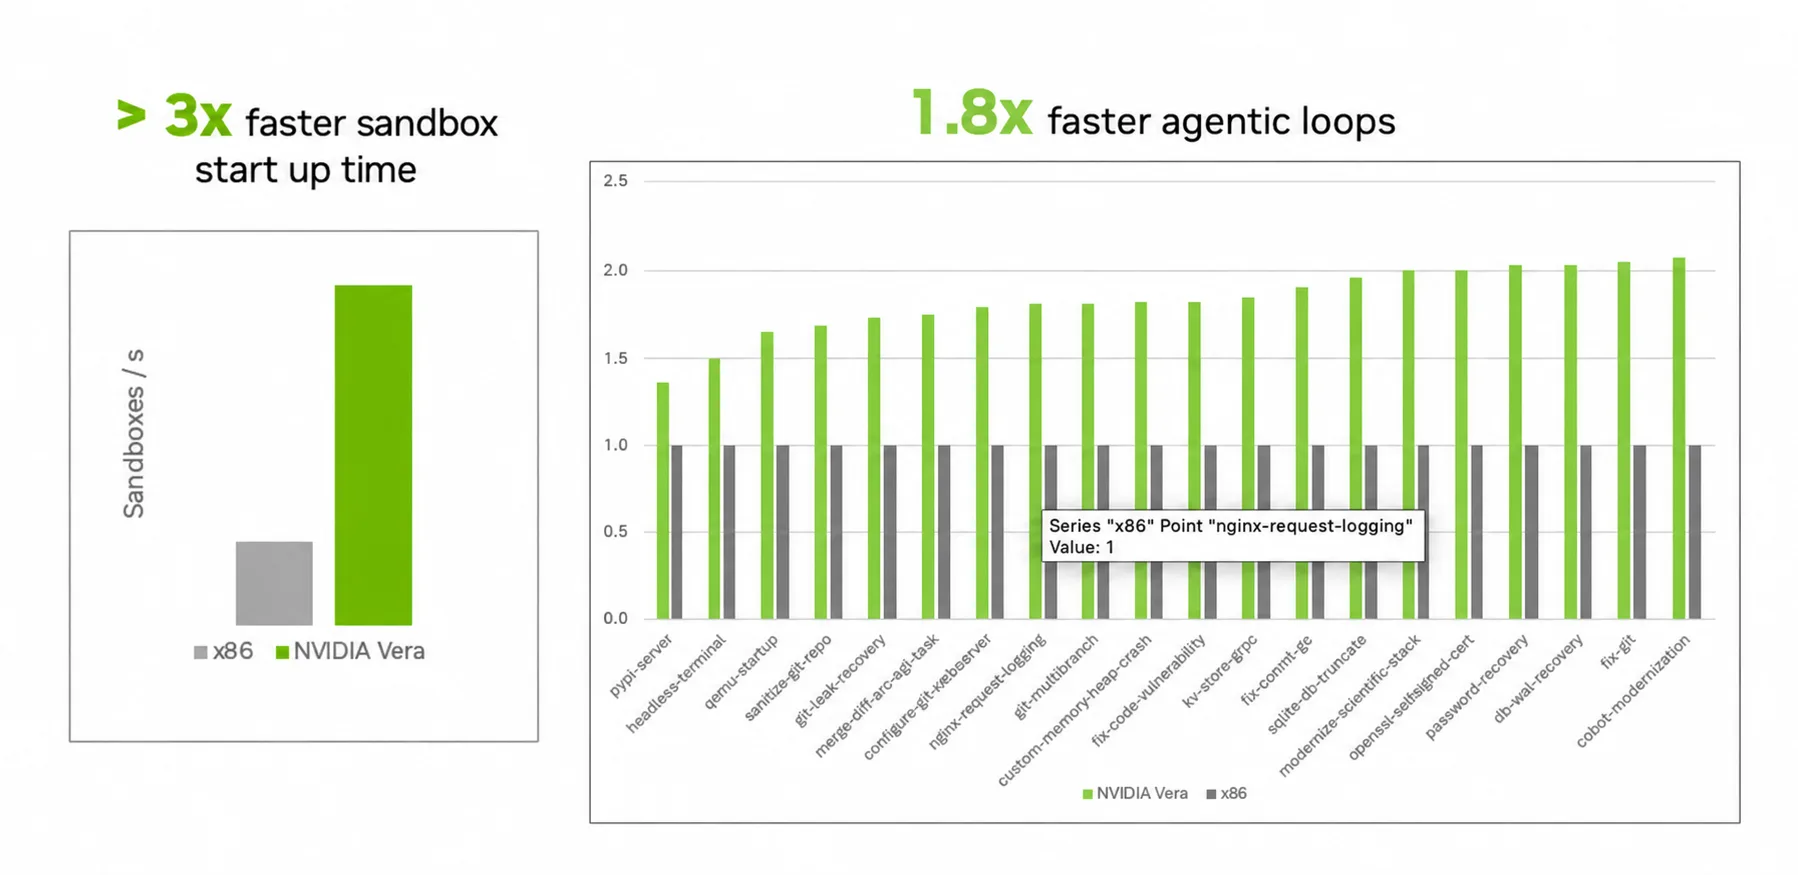
CoreWeave 是专为大规模训练和服务模型而构建的 AI 云平台,它发现 Vera 上的启动速度比 x86 上的快 3 倍以上,单个机架支持超过 11000 个并发智能体环境。
CoreWeave 运行的 Terminal Bench 用于测量真实代理式循环任务中的 CPU 性能,发现 Vera 在从脚本编写到数据库恢复等代理式任务中的性能比 x86 快 1.8 倍。这种负载下的密度和性能是智能体基础设施的实际需求。
NVIDIA BlueField 和 NVIDIA Sentry 提供硬件强化保护
OpenShell 将权限置于智能体之外。对于需要额外保护的部署,这种分离还可以扩展到专用芯片。
NVIDIA BlueField-4 DPU 可提供智能体无法触及的硬件隔离信任域。在 OpenShell 参考架构中,BlueField-4 位于 Vera 上运行的代理与其访问的模型之间的 I/ O 路径中。NVIDIA Sentry 是基于 NVIDIA DOCA 构建的安全软件框架,在此独立域中运行,可持续监控智能体行为并执行运行时策略。
NVIDIA Sentry 会观察请求和响应、网络和文件活动,验证身份和授权,并分析选定的主机内存以检测与授权行为的偏差,而无需依赖智能体的自我报告。
当检测到威胁或违反策略时,BlueField-4 会在芯片中执行策略,使 NVIDIA Sentry 能够在几毫秒内隔离智能体。它们共同添加了可选的硬件防护措施以及 OpenShell 的软件边界。在此技术深入探讨中详细了解 NVIDIA Sentry。
扩展安全智能体运行时
在生产环境中运行智能体需要能够保持数千个工作流的基础设施,同时控制其采取的每项操作。Vera 提供计算、内存带宽和 I/ O 来支持这些工作流程。OpenShell 提供运行时边界,用于确定哪些操作可执行以及智能体可以访问哪些资源。
Vera 和 OpenShell 强强联合,使安全代理执行成为扩展的基础。智能体可以延长运行时间,使用工具,并在不受其控制的策略范围内处理企业数据。对于需要额外保护的部署,BlueField-4 上的 NVIDIA Sentry 增加了独立监控和芯片内执行功能。
运行 NVIDIA Vera Rubin 平台以及 BlueField-4 上的 OpenShell 和 NVIDIA Sentry 是 OpenShell 参考架构的支柱。它们构成了安全 AI 智能体的完整堆栈:一个基于硬件的完整基础,可为组织提供提高智能体工作效率所需的性能,以及确保其工作不超出授权范围所需的控制。
开始使用
要在您的组织中实施安全智能体治理,请从 NVIDIA OpenShell 开始,按照 文档操作,并探索 NVIDIA Vera CPU 如何加速智能体工作负载。


