

NVIDIA DSX AI Factory Platform 整合了多种技术,可帮助生态系统设计、构建和运营更高效的 AI 工厂,包括专为支持多租户运营和扩展而构建的开源模块化软件组件。
运营 AI 工厂需要对分布式工作负载有共同的理解:组件、Pod 模板、副本数量和状态。在 Kubernetes 上,每个框架对这些信息进行不同的编码。JobSet、LeaderWorkerSet 和其他自定义资源通常需要单独的适配器,然后工具才能解释和管理这些资源。
NVIDIA 工作负载地图提供了 Kubernetes 工作负载结构的通用描述,用户可以跨框架重复使用。作为 NVIDIA DSX AI Factory Platform 的一部分,Workload Map 使集成的调度程序、控制器和平台能够解释受支持的工作负载类型,而无需维护单独的特定于框架的解析代码。
本文将介绍如何描述一次分布式工作集工作负载,然后将该定义重复用于工作负载检查、分组调度和平台可见性。
为什么每种工作负载类型都需要自己的网卡
在 Kubernetes 上,真正的工作负载很少是单个 Pod。分布式训练作业或多节点推理服务器是一个小的资源树:pod 组,每个都有一个角色、一个副本计数、一个 pod 模板,以及取决于工作负载类型的状态。
构建调度器、控制器、仪表板或成本工具的团队必须在这些工作负载中工作,他们会立即遇到这种情况。NVIDIA Run:ai 团队在创建平台时也面临着同样的挑战。对于每个新的自定义资源定义 (CRD) ,开发者都会在代码中回答相同的问题:NVIDIA Run:ai。
- 工作负载类型的结构是什么?
- 如何将资源状态解释为阶段?
- 如何在不破坏工作负载的情况下更改 Pod 规格?
开发者会针对每种工作负载类型回答一次这些问题,然后生成一个 CRD 网卡。客户带来的每个新框架都需要另一个适配器。这使得适配器开发成为每个框架的路线图项目,而不是一次性成本,这就是为什么对新工作负载类型的支持往往需要等待发布。
以下清单显示了用户提交的分布式训练作业:包含一个领导者工作和两个工作者工作的工作集,每个工作集都有一个请求四个 GPU 的 Pod。
apiVersion: jobset.x-k8s.io/v1alpha2
kind: JobSet
metadata:
  name: demo
spec:
  replicatedJobs:
    - name: leader
      replicas: 1
      template:
        spec:
          parallelism: 1
          completions: 1

          template:
            spec:
              containers:
                - name: leader
                  image: ghcr.io/example/trainer:latest
                  resources:
                    limits:
                      nvidia.com/gpu: 4
    - name: worker
      replicas: 2
      template:
        spec:
          parallelism: 1
          completions: 1

          template:
            spec:
              containers:
                - name: worker
                  image: ghcr.io/example/trainer:latest
                  resources:
                    limits:
                      nvidia.com/gpu: 4
该清单描述了一名领导者、两名工作者,以及总共 12 个 GPU 的请求。解释该结构需要使用可感知工作集的代码;kubectl 会单独列出资源。
图 1. kubectl将演示作业集、其三个作业及其 Pod 列为单独的资源条目
$ kubectl get jobset,jobs,pods
NAME                      TERMINALSTATE   RESTARTS   COMPLETED   SUSPENDED   AGE
jobset.jobset.x-k8s.io/demo               0                                  3m46s

NAME                      STATUS   COMPLETIONS   DURATION   AGE
job.batch/demo-leader-0   Running  0/1           3m46s     3m46s
job.batch/demo-worker-0   Running  0/1           3m46s     3m46s
job.batch/demo-worker-1   Running  0/1           3m46s     3m46s

NAME                          READY   STATUS    RESTARTS   AGE
pod/demo-leader-0-0-ksb4l     1/1     Running   0          3m47s
pod/demo-worker-0-0-qv955     1/1     Running   0          3m47s
pod/demo-worker-1-0-5smfn     1/1     Running   0          3m47s
所有者引用将工作连接到他们的工作集,但平台仍然需要定义来解释其角色和聚合资源请求。
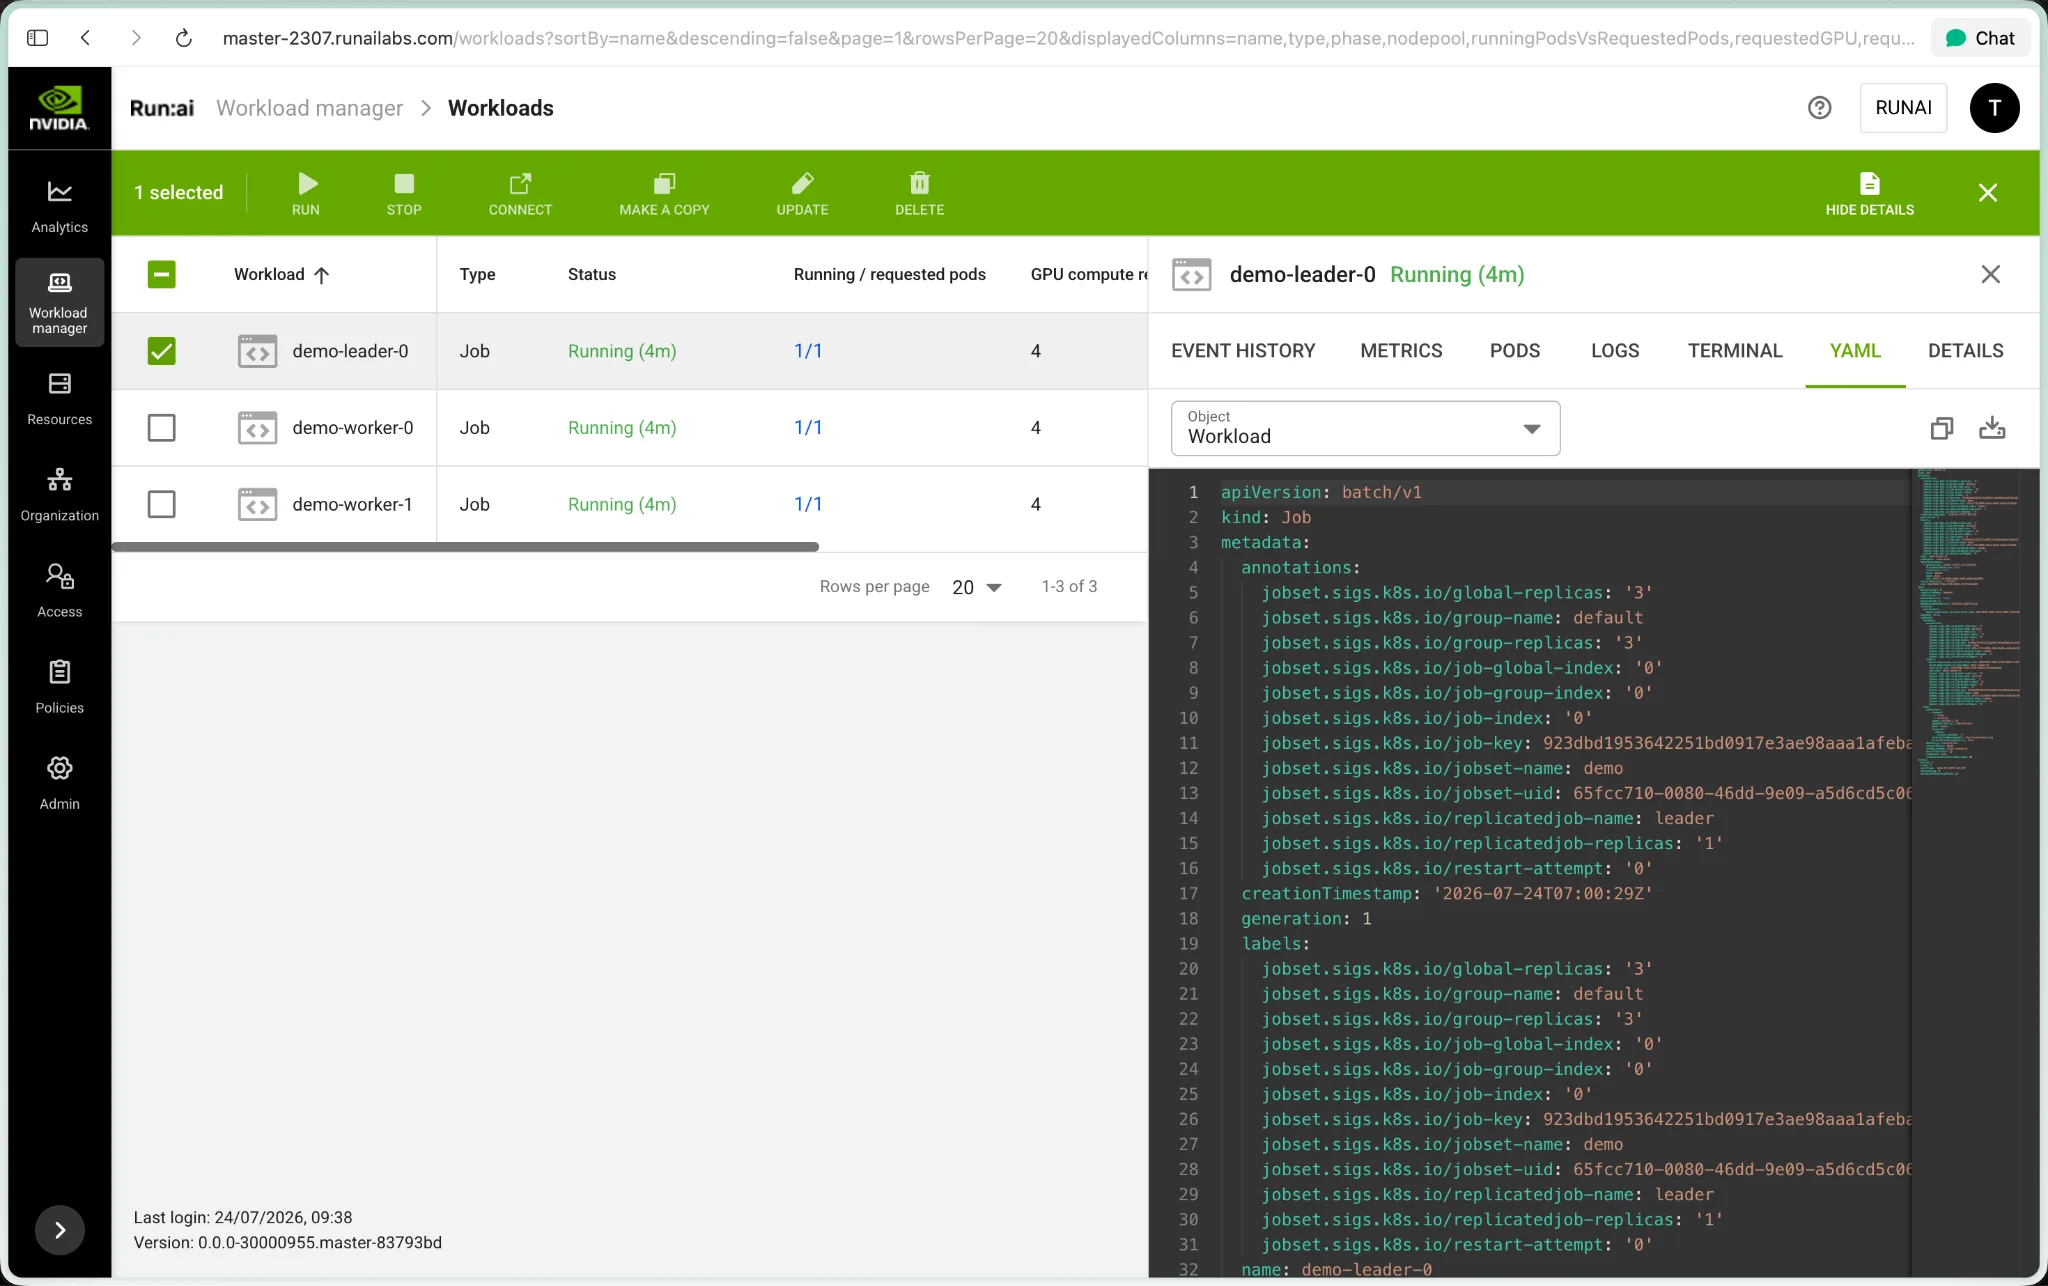
如果没有共享工作负载描述,用户必须自行重建工作负载及其 GPU 请求总数。
Kubernetes 工作负载结构的通用说明
工作负载地图 (以前称为 Karta;CRD 的资源类型仍然是 Karta) 作为 Kubernetes CRD 和 Go 库提供,用于解释工作负载定义。每个定义都指定了在何处查找其工作负载类型的 Pod 模板、副本数量和状态字段。
Workload Map 为调度和平台用户提供共享的结构视图。KAI Scheduler 使用其定义来解释 Pod 分组和轮调度指令,而 NVIDIA Run:ai 则使用它们进行工作负载管理和可见性。每个消费者根据相同的描述采取行动,从而减少对单独的框架特定解析器的需求。
Go 库将实时对象解析为统一的结构视图。有了工作负载定义,消费者可以:
- 提取 Pod 模板、副本数量、状态和元数据。
- 更新每个实例中的 Pod 规格、标签和标注。
- 了解工作负载层次结构,例如,工作集的复制作业及其 POD。
工作负载地图包括一个预构建且经过测试的定义目录,适用于 JobSet、PyTorchJob、RayCluster、RayJob、RayService、KServe、Knative、MPIJob、NVIDIA NIM、LeaderWorkerSet、Milvus、Grove PodCliqueSet 和 NVIDIA Dynamo。通过编写描述工作负载结构和状态的 YAML 定义,可以添加其他工作负载类型。
关键在于工作负载知识可以从编译的适配器转移到数据开发者可以编写、审查和应用于集群,就像任何其他清单一样。本文的其余部分将介绍 JobSet 示例,然后展示同一定义如何支持工作负载检查、分组调度和平台可见性。
为 JobSet 编写工作负载定义
工作负载定义 (表示为工作负载地图资源) 描述了该形状。以下摘录显示了工作集定义的关键部分。完整版将在资源库中发布。
根组件定义工作负载本身的类型及其状态的读取方式。
apiVersion: run.ai/v1alpha1
kind: Karta
spec:
  structureDefinition:
    rootComponent:
      name: jobset
      kind:
        group: jobset.x-k8s.io
        version: v1alpha2
        kind: JobSet
      statusDefinition:
        conditionsDefinition:
          path: .status.conditions
        statusMappings:
          running:
          - byExpression:
              expression: "(.status.replicatedJobsStatus // []) | any(.ready > 0 and .active > 0) and all(.failed == 0)"
              expectedResult: "true"
          completed:
          - byConditions:
            - type: Completed
              status: "True"
          failed:
          - byConditions:
            - type: Failed
              status: "True"
statusMappings 是翻译层。JobSet 不会报告简单的“运行”条件,因此定义通过 replicatedJobsStatus 上的 jq 表达式 (任何工作准备就绪和处于活动状态,均未失败) 推导出该条件,并将原生的“已完成”和“失败”条件映射到消费者已使用的共享词汇表上。描述 RayJob 或 LeaderWorkerSet 时,其截然不同的状态会映射到相同的类别。
下一个摘录定义了子组件:工作负载内部的结构。
    childComponents:
    - name: replicatedjob
      kind: { group: batch, version: v1, kind: Job }
      ownerRef: jobset
      specDefinition:
        podTemplateSpecPath: .spec.replicatedJobs[].template.spec.template
      scaleDefinition:
        replicasPath: .spec.replicatedJobs[] | .replicas * .template.spec.parallelism
      instanceIdPath: .spec.replicatedJobs[].name
工作集将其角色声明为列表,因此 .spec.replicatedJobs 会为每个角色保留一个条目。这些路径中的 [] 表示“该列表中的每个条目”,且每个条目都是 Workload Map 调用的实例。podTemplateSpecPath 指向每个工作的 Pod 模板。scaleDefinition 使用 jq:每个复制作业的 pod 数量等于 replicas 乘以 parallelism,这就是示例清单显式设置 parallelism 的原因。instanceIdPath 从 .spec.replicatedJobs[].name 中获取每个实例的名称,即“领导者”和“工作者”如何显示为不同的角色,而不是三个匿名作业。
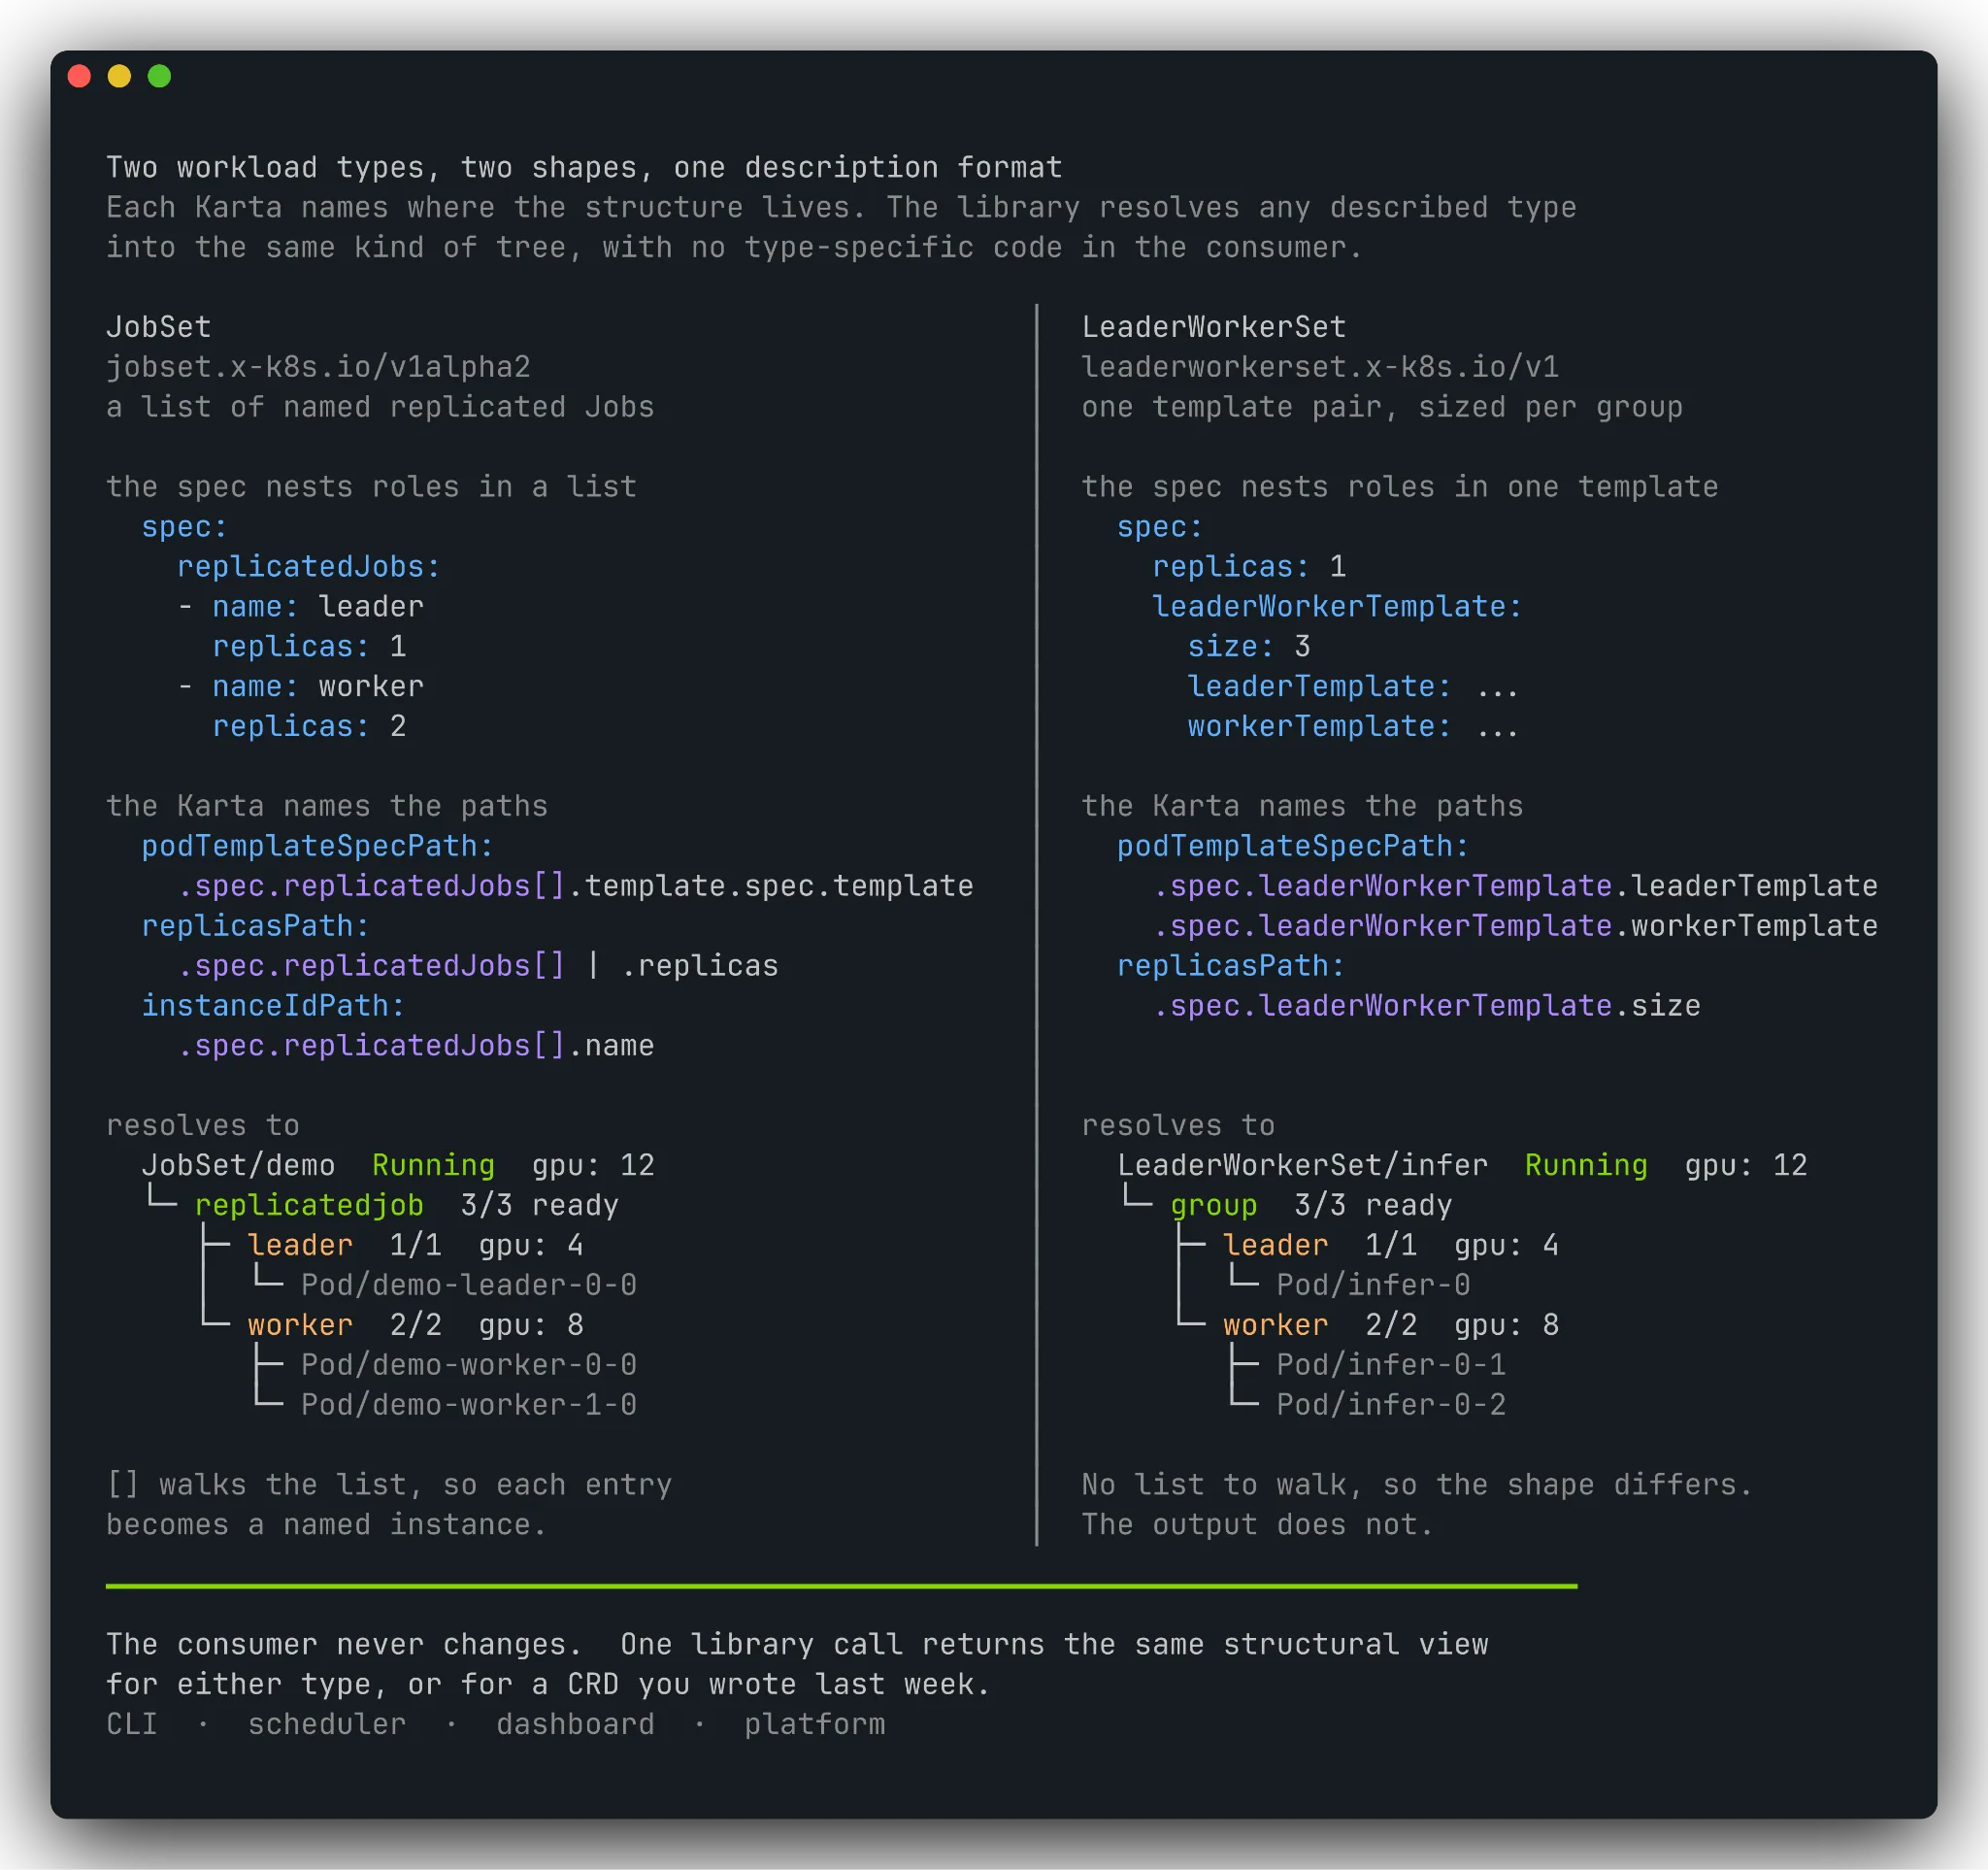
特定于框架的结构现在以一种可重复使用的定义捕获。下一节将展示不同的消费者如何使用它。
跨工具使用一个描述
相同的工作集定义支持三个工作流程:检查工作负载、将它们一起调度,以及将它们作为一个工作负载进行管理。
使用工作负载地图 CLI 检查工作负载
工作负载地图 CLI 从集群中读取工作负载,并通过其工作负载定义进行渲染。对于演示版工作集,CLI 加载工作集描述,解析实时对象及其 pod,并打印树。CLI 使用 kubeconfig 访问集群,并包含内置的工作负载定义。此检查工作流无需在集群中安装 Workload Map。
以下命令在 macOS 或 Linux 上安装 CLI with Homebrew,并确认可执行文件位于 PATH 上。
brew tap dsx-ai-factory/kli https://github.com/dsx-ai-factory/workload-map
brew install dsx-ai-factory/kli/kli
kli --version
在当前 Kubernetes 环境中运行演示版工作集时,以下命令会检查该工作集。必须将 <namespace> 占位符替换为包含工作负载的命名空间。
kli describe jobset/demo -n <namespace>
JobSet/demo   namespace: default   definition: jobset-x-k8s-io-jobset-v1alpha2 (catalog)   age: 20s

`-- replicatedjob                   3/3 ready   gpu: 12   runai-cluster-worker-0-0
    |-- leader                      1/1 ready   gpu: 4    runai-cluster-worker-0-0
    |   `-- demo-leader-0-0-ck6kg   Running     gpu: 4    runai-cluster-worker-0-0
    `-- worker                      2/2 ready   gpu: 8    runai-cluster-worker-0-0
        |-- demo-worker-0-0-j9pdc   Running     gpu: 4    runai-cluster-worker-0-0
        `-- demo-worker-1-0-rrsxz   Running     gpu: 4    runai-cluster-worker-0-0

Phase: Running

Resources:
COMPONENT   REPLICAS   GPU   CPU   MEMORY
leader      1          4     0     0
worker      2          8     0     0
TOTAL       3          12    0     0
输出标识了领导者和工作者角色,并显示了示例工作负载的总共 12 个 GPU 请求。
图 4. 早期的 Karta CLI 视图将工作集解析为领导者和员工角色,显示就绪情况、GPU 总数和节点布局
$ karta workload tree demo
JobSet/demo [Running]
└─ replicatedjob  (3/3 replicas)  3/3 ready  gpu: 12  runai-cluster-worker-0-2,runai-cluster-worker-0-5,runai-cluster-worker-0-7
   ├─ leader  (1/1 replicas)  1/1 ready  gpu: 4  runai-cluster-worker-0-7
   │  └─ Pod/demo-leader-0-0-ksb4l  Running  gpu: 4  runai-cluster-worker-0-7
   └─ worker  (2/2 replicas)  2/2 ready  gpu: 8  runai-cluster-worker-0-2,runai-cluster-worker-0-5
      ├─ Pod/demo-worker-0-0-qv955  Running  gpu: 4  runai-cluster-worker-0-5
      └─ Pod/demo-worker-1-0-5smfn  Running  gpu: 4  runai-cluster-worker-0-2

$ karta workload list
NAMESPACE   NAME  KIND    PHASE    COMPONENTS           GPU  AGE
karta-demo  demo  JobSet  Running  leader(1), worker(2)  12   3m
该定义提供了特定于工作集的结构,因此 CLI 无需专用解析器即可检查工作负载。
使用 KAI Scheduler 启用群组调度
对于调度工作负载的消费者而言,定义还可以包括可选的批量调度指令。
  optimizationInstructions:
    gangScheduling:
      podGroup:
        name: job
        subGroups:
        - componentName: replicatedjob
该定义提供分组信息;KAI Scheduler 强制实施帮派接纳,并做出安排决定。KAI Scheduler 在其 POD Grouper 中使用 Workload Map 作为后备,用于处理工作负载类型,而无需原生插件。匹配的定义可提供结构和分组信息,而无需使用新的特定于框架的插件,而原生插件保留优先级。
在 NVIDIA Run:ai 中管理相同的工作负载
在 NVIDIA Run:ai 中,单个 API 调用使用相同的目录定义来注册工作负载类型,而无需额外代码。然后,平台使用该描述将工作集作为一个工作负载进行管理。
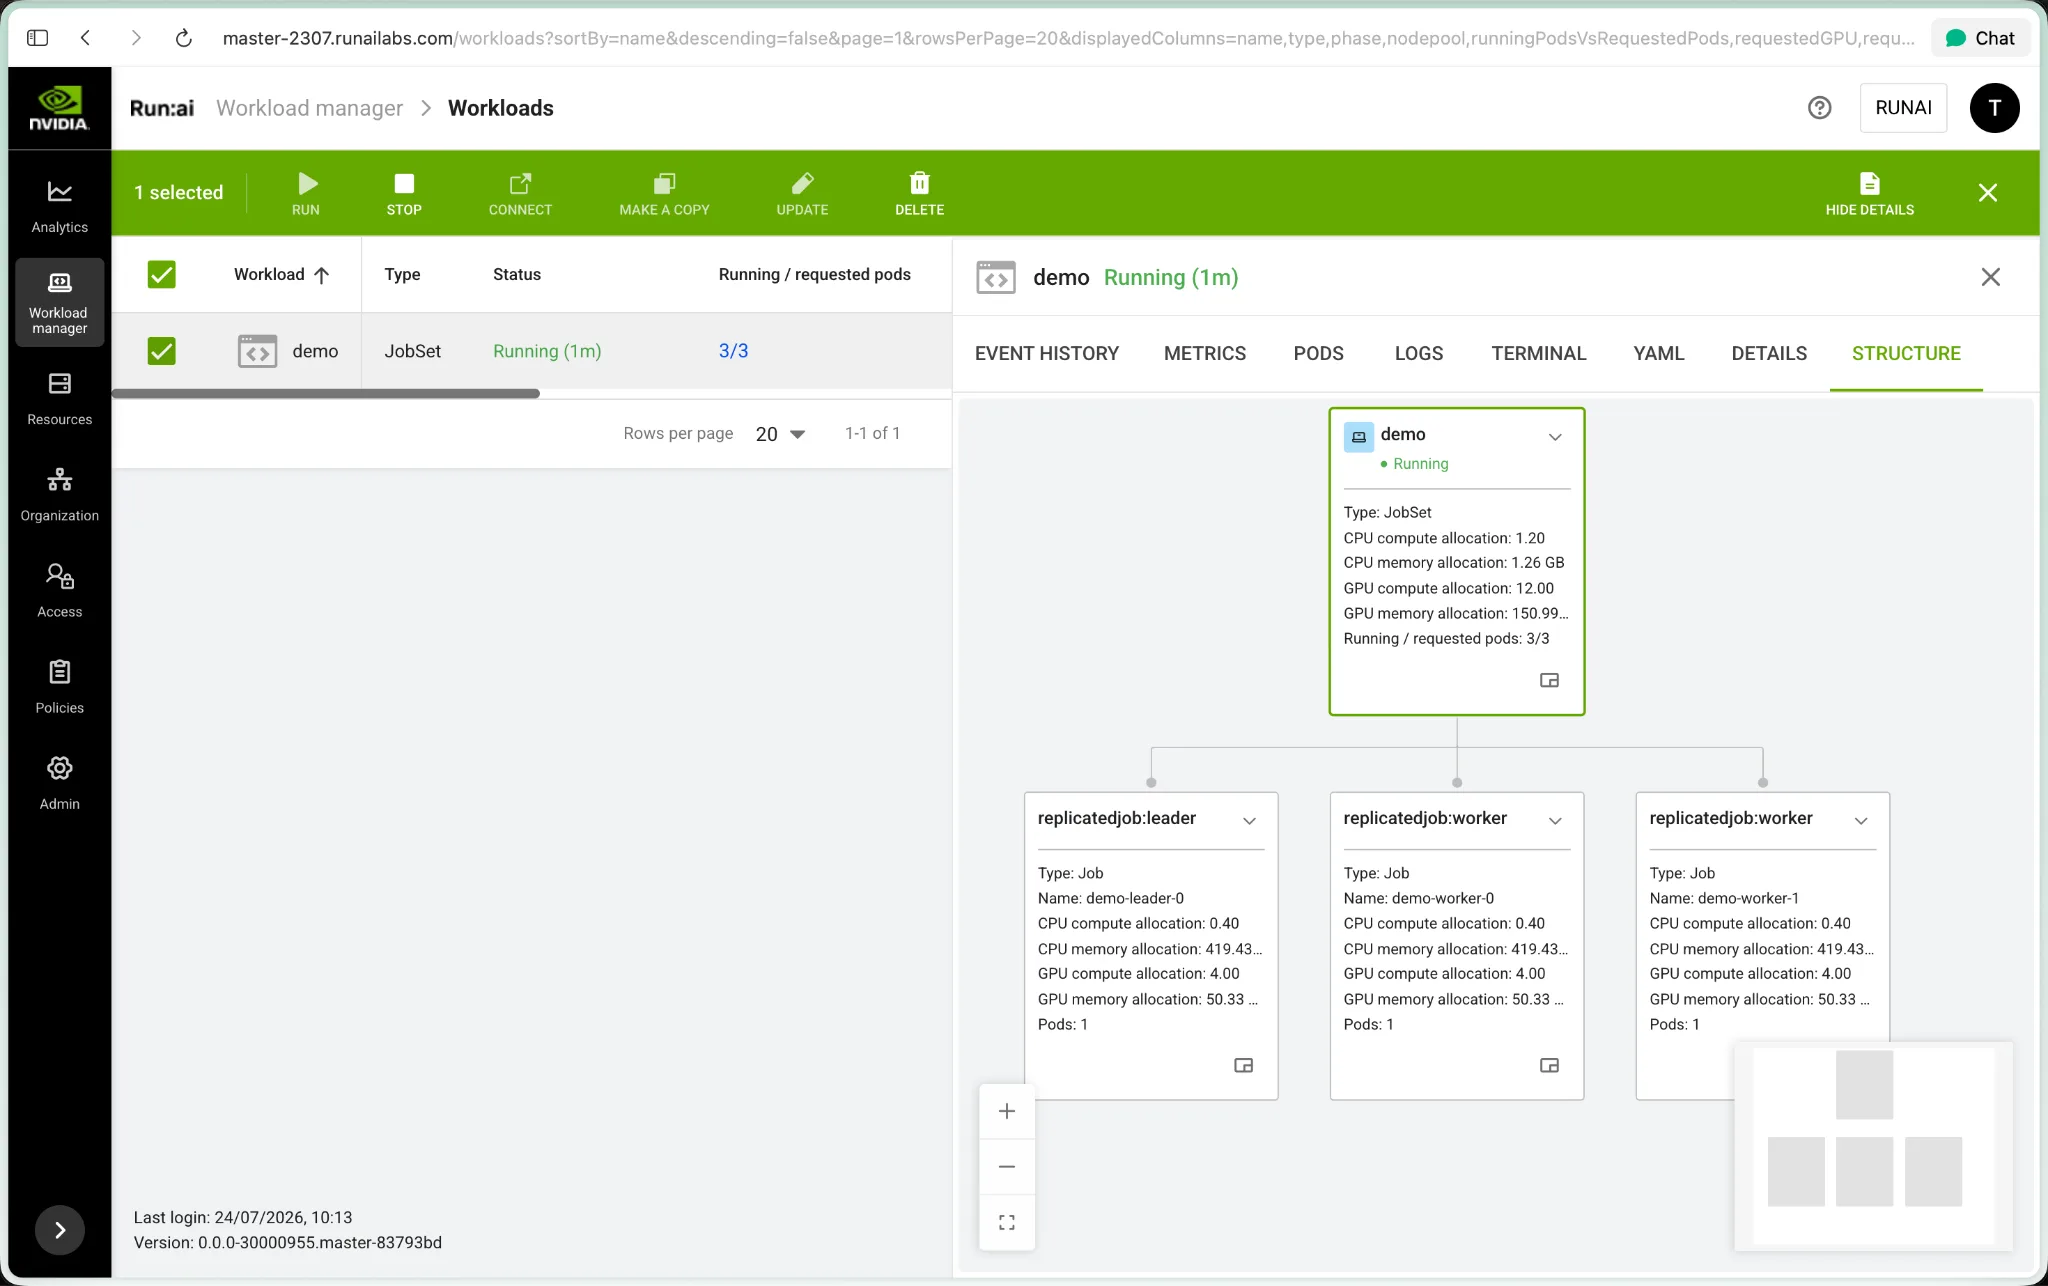
CLI、KAI Scheduler 和 NVIDIA Run:ai 将相同的定义用于不同的目的:检查、调度和平台可见性。对于另一种受支持的工作负载类型,相应的目录定义通过同一接口提供其结构。
跨调度程序和平台采用工作负载地图
NVIDIA 工作负载地图根据 Apache 2.0 许可证 提供,并在 NVIDIA Run:ai 中用于生产。其声明性定义支持跨受支持的 Kubernetes 工作负载类型的工作负载可见性、状态解释、提交和突变。
采用范围还扩展到多集群调度。Elotl 的 Nova 在为分布式工作负载选择集群时,使用 Workload Map 解释工作负载结构和资源需求。通过使用预构建的定义,Nova 减少了对框架特定解析逻辑的维护需求,展示了同一个工作负载描述模型如何支持不同的调度和平台用户。
开始使用
NVIDIA 工作负载地图 是一个开源组件,可通过 NVIDIA DSX AI Factory GitHub 组织 获取。如果您在 Kubernetes 上运行 AI 工作负载,并且需要以一致的方式跨框架解释其结构,则 Workload Map 有助于弥合差距。
从工作负载目录开始,查找您已使用的框架的定义,或对其进行调整以支持自定义工作负载类型。使用Slack 邀请链接加入 NVIDIA DSX AI Factory Slack 工作空间上的对话。我们迫不及待地想看到您构建的内容。


