

智能体可以完成任务,但路径仍然效率低下。搜索失败会触发另一次搜索。读取截断的文件会导致命令再次获取相同内容。正确的最终答案隐藏了这些额外的步骤,尽管它们会增加延迟并消耗 token。效率低下会增加失败几率。
为了改善智能体的行为,开发者必须了解任务是否成功以及智能体如何完成任务。成功检查本身并不能解释为什么智能体从工具错误中恢复、提早停止或需要额外的模型调用。
在本教程中,您将使用 NVIDIA NeMo Relay 运行两个 Hermes ToolPerf 示例。您将使用生成的追踪结果来检查模型和工具调用、错误、重试、持续时间和token使用情况,然后将该证据与每个任务的验证结果进行比较。爱马士 ToolPerf 案例研究展示了如何使用相同的方法来评估重复运行时的线束变化。
本教程和视频将解释如何:
- 通过其原生 NeMo Relay 集成,设置一个隔离的 Hermes Agent 运行时。
- 运行简单的终端工具任务,检查其事件流和轨迹。
- 运行文件和网络研究任务,并在 Arize Phoenix 中探索其 OpenTelemetry 追踪。
- 将任务验证与追踪证据相结合,以评估对智能体工具的更改。
预备知识
开始之前,请确保您拥有:
- macOS 或 Linux
- Git 和 curl
- 安装并运行 Docker Desktop 或 Docker Engine
- 适用于 NVIDIA Nemotron 3.5 Lightning 的 NVIDIA Build API 密钥。打开模型页面,然后选择Generate API Key (生成 API 密钥) 。
接下来,我们将概述本教程中使用的技术,以及这些技术如何协同工作。
NeMo Relay 如何与 Hermes Agent 线束配合使用
NeMo Relay为智能体开发者提供了一种观察和控制模型和工具执行的通用方法。广受欢迎的智能体工具Hermes Agent原生包含NeMo Relay,并在NeMo Relay的范围层次结构中表示其会话、回合、模型调用和工具调用。NeMo Relay会在工作开始和结束时记录生命周期事件,从而保留其时间和亲子关系。
了解追踪输出
NeMo Relay 用于实现智能体可观察性。您将使用智能体执行的三种表示形式:
| 格式 | 其中包含的内容 | 何时使用 |
|---|---|---|
| 智能体轨迹可观测性格式 (ATOF) | 范围开始、范围结束和时间点标记的 JSONL 日志,以及用于重建智能体运行的 ID 和时间。 | 使用 ATOF 调试或审核个人事件、计时和亲子关系。 |
| 代理轨迹交换格式 (ATIF) | 根据生命周期事件收集的智能体交互、工具调用和观察数据的分步 JSON 记录。 | 使用 ATIF 逐步审查、分析或评估智能体的路径。 |
| 搭载 开放推理 的 OpenTelemetry | OpenTelemetry 将运行记录为 parent-child span。OpenInference 标记代理、LLM,以及工具 span 并定义其属性。 | 在符合 OTEL 标准的工具 (如 Phoenix) 中使用它,以检查模型和工具调用、持续时间、token 使用情况和错误。 |
ATIF 工具请求会显示模型要求运行的内容,但不会确认结果。要验证发生了什么,请检查 ATOF 是否存在匹配的工具开始和结束事件以及任何记录的错误。其共享的 uuid 会对事件进行配对,而 parent_uuid 会将工具调用连接到其父节点。
在分享之前查看痕迹。根据您的配置,它们可能包含提示、模型响应、工具参数和结果、文件路径以及其他应用程序数据。
对于智能体安全和安全治理,NeMo Relay 有助于提供证据层:结构化的追踪和轨迹,企业、评估者和安全系统可以使用这些追踪和轨迹来调查智能体行为、评估策略、改进控制或创建扩展 Relay 的专用安全插件。
我们开始运行第一个代理任务。
实验# 1:使用 Hermes Agent 运行简单的工具使用任务
第一个示例有意设置得较小,因此您可以在添加 Web 搜索和 Phoenix 之前验证完整设置。Hermes 使用其终端工具在隔离的 Docker 容器内运行包含的 Python 脚本。脚本打印:VALUE=42.
这种固定输出会让跑步者准确检查结果是否成功。通过运行还可以确认,Hermes 已到达模型,调用了沙盒中的终端工具,并生成了两个 Relay 跟踪文件。
容器无法访问网络、存储库结账或 NVIDIA API 密钥。此外,Hermes 也无法回退到在主机上运行终端命令。
按顺序运行以下命令。复制 keys.env 后,将您的 NVIDIA API 密钥添加到该文件中,然后再继续。
# Clone the tutorial repository.
git clone https://github.com/NVIDIA/nemoclaw-community

# Enter the cloned repository.
cd nemoclaw-community/examples/tools/hermes-relay-tracing

# Create the isolated Hermes Agent and NeMo Relay runtime.
./scripts/setup_tutorial_runtime.sh

# Copy the API key template.
cp keys.env.example keys.env

# Add NVIDIA_API_KEY to keys.env before continuing.

# Verify that Docker is running.
docker version

# Build the Docker image for the terminal-tool task.
./scripts/build_tutorial_image.sh

# Run the task and generate the ATOF and ATIF traces.
./scripts/run_tutorial.sh
在此资源库的本地环境中运行的是 Hermes Agent 和 NeMo Relay 进程。Docker 分别用于终端工具沙盒和本地凤凰服务。
资源库中的设置脚本会在 .tutorial-runtime/ 下创建一个自包含的环境,其中包含所有适当的依赖项,例如使用 NeMo Relay 0.8.3 的 Python 3.11 和 Hermes 0.21.1。它不会修改您现有的 Python 或 Hermes 安装。
任务完成后,运行器会检查响应和跟踪文件。通过的运行会打印验证结果,然后打印 ATOF 和 ATIF 摘要。
查看追踪摘要
在 Hermes 完成任务后,运行器会验证预期结果和生成的痕迹。它会检查终端命令是否成功,ATOF 追踪是否包含已完成且使用token的 LLM 活动且无工具错误,以及是否创建了非空的 ATIF 轨迹。以下输出来自一次验证运行。token数量、标识符和文件路径会因运行而异。
ATOF 总结
events: 74
completed llm scopes: 2
llm scopes with usage: 2
prompt tokens: 7239
completion tokens: 96
total tokens: 7335
tool calls: 1
tool errors: 0
correlated events: 74
ATIF 摘要
agent: Hermes Agent
model: nvidia/nemotron-3.5-lightning-30b-a3b
steps: 3
llm calls: 2
requested tool calls: 1

Task verified: VALUE=42
Artifacts: .../artifacts/runs/<run-id>
查找包含 Task verified: VALUE=42 的代码行,以确认预期结果。ATOF 摘要报告已完成的模型范围、token 使用情况、工具调用和工具错误。ATIF 摘要展示了与三步轨迹相同的执行情况。
Artifacts: 之后的路径标识了包含完整 ATOF 事件流和 ATIF 轨迹的运行目录。配套存储库解释了如何再次检查或汇总其中一个文件。
实验# 2:运行多工具研究任务并探索其痕迹
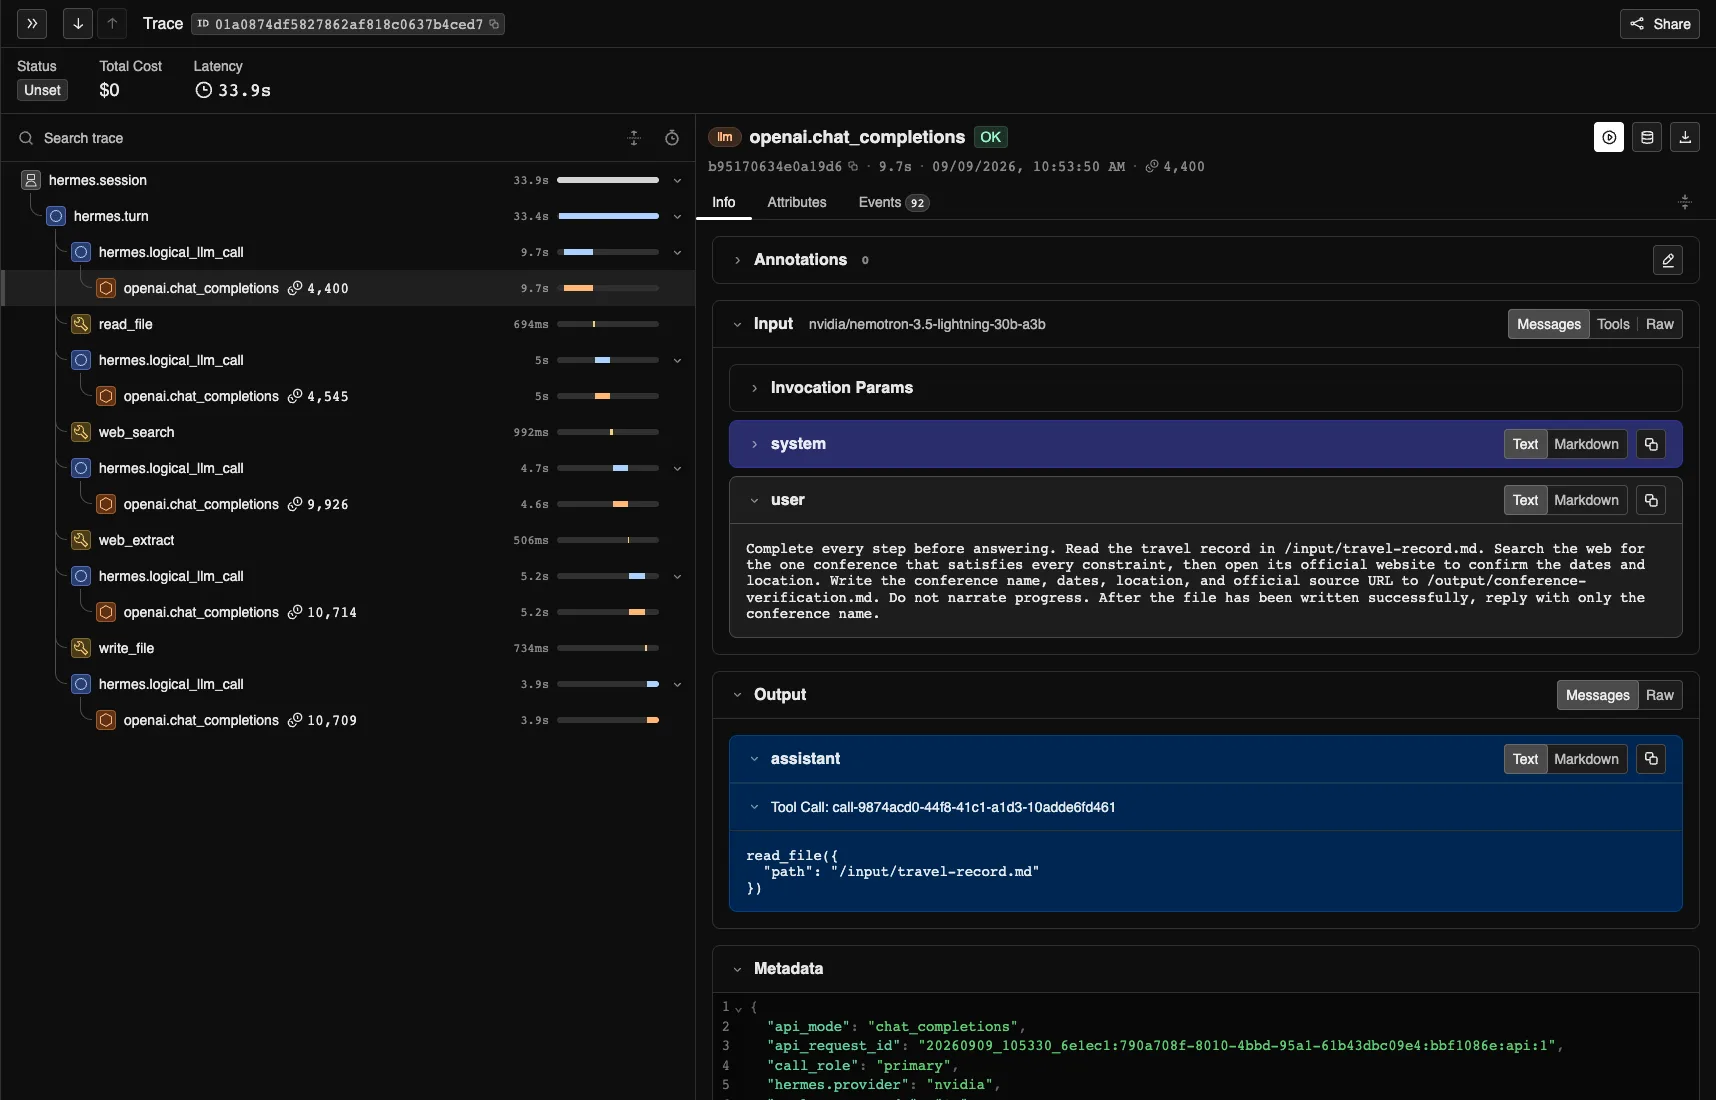
在验证基本设置后,第二个示例使用相同的 Hermes 和 NeMo Relay 环境来执行需要多个工具的任务。Hermes 会收到一份旅行记录,其中包含有关某个未命名机器学习会议的线索。它必须阅读记录,找到与主题、日期和地点匹配的会议,在官方网站上确认答案,将验证信息保存在报告中,然后返回会议名称。
使用 NeMo Relay 的 OpenInference 导出器,将 OpenTelemetry Span 发送到 Arize Phoenix over OTLP (OpenTelemetry Protocol) 。Phoenix 将运行显示为交互式追踪,您可以在其中检查模型和工具调用、计时、token使用情况、错误以及可用的输入和输出。
您可以通过更改端点和身份验证设置,将相同的 OpenTelemetry 追踪发送到其他兼容 OTLP 的后端,例如 LangSmith。NeMo Relay 可观察性指南介绍了其他可用的导出器和配置选项。
该示例重用了第一个示例中的 NVIDIA Nemotron 模型和 NVIDIA API 密钥。赫耳墨斯公司使用其内置的无密钥网络搜索功能,然后亚军在固定的本地容器中启动凤凰。运行会议搜索示例:
./scripts/run_conference_research_with_phoenix.sh
运行期间,NeMo Relay 会在本地保存 ATOF 事件流和 ATIF 轨迹。
在报告成功之前,领跑者会检查一下:
- 将
COLT 2026识别为会议名称 - 已保存包含预期会议详细信息和官方来源的报告
- 成功完成
read_file、web_search、web_extract和write_file调用 - 生成了一个非空的 ATIF 轨迹
- 将具有正 token 使用率的模型和工具 span 发送到 Phoenix
检查通过后,终端输出包括指向 Phoenix 项目和本地运行目录的链接。在 Phoenix 中打开项目,跟随从初始文件中运行的智能体,通过网络搜索、源验证、报告写入和最终响应进行读取。
尝试使用其他模型执行此任务
要了解其他模型如何处理同一会议查询,请按照配套资源库中的模型配置文件说明进行操作。保持查询、可用工具、执行限制和验证器不变,以便您检查执行路径的差异。
由于任务使用实时网络搜索,因此使用这些运行来探索行为而不是对模型进行排序。受控比较需要固定的搜索响应和重复运行。
使用跟踪评估智能体的线束变化
这两个示例展示了如何验证结果并检查一次运行。评估线束更换需要在受控的重复条件下进行相同的检查。
智能体利用评估步骤
- 选择具有精确、自动化成功检查的固定任务。
- 定义基准,并对提示词、工具、配置或工具束进行一次重点更改。
- 保持更改以外的所有内容不变,包括模型快照、提供程序、任务输入、执行预算和超时。
- 启用 NeMo Relay 后,为基准和候选项运行相同数量的重复次数。
- 首先比较已验证的任务结果。然后使用这些追踪数据来检查模型调用、工具调用、重试、错误、使用时间、token使用情况和成本。
- 在泛化结果之前,对预期更改将支持的模型或工作负载重复评估。
只有当任务完成率实现可重复的提高,或者在保持完成率的同时提高可靠性、延迟或您打算更改的成本衡量标准时,才能为候选者进行改进。一次更快的运行或更少的调用有助于解释结果,但两者本身都无法建立优化。
不变的结果也很有用。它可以显示明显的改进取决于特定的模型、环境或样本。
用于评估 Hermes 工具层更改的基准案例研究
Nous Research 在分析生产会话、审核工具模式并挖掘生产会话日志以寻找故障分类后,开发出了 Hermes ToolPerf 基准测试。然后,使用 NeMo Relay ATOF 追踪进行真值转向计算。通过检查九种故障模式,将结果转化为确定性基准案例,然后用于评估一批爱马士工具层修复程序。
8 月 6 日的重新运行比较了九项任务中的 Hermes 固定基准和固定修订。每个任务每个模型在每只手臂上运行三次,总共运行 108 次,而且整个过程中的提示词、工具、执行限制和成功检查相同。任务验证器测量完成情况,NeMo Relay ATOF 追踪捕获的模型调用、工具调用、错误、重试、工具结果数据和定时。
| 模型 | ARM | 任务成功 | Mean LLM calls | 均值工具调用 | 工具结果数据平均值 | 平均持续时间 |
|---|---|---|---|---|---|---|
| 克劳德・索内 4.5 | 基准 | 24/ 27 ( 89%) | 2.9 | 2.2 | 17 KB | 16 秒 |
| 克劳德・索内 4.5 | 修复 | 23/ 27 ( 85%) | 2.8 | 2.1 | 17 KB | 22 秒 |
| Qwen3 编码器 30B | 基准 | 19/ 27 ( 70%) | 3.8 | 2.8 | 16 KB | 27 秒 |
| Qwen3 编码器 30B | 修复 | 22/ 27 ( 81%) | 4.9 | 3.9 | 33 KB | 42 秒 |
在这次运行中,Sonnet 没有显示任何真正的变化。在 27 次基准运行中,它完成了 24 次,在 27 次修复中完成了 23 次,与一次运行相比。其转弯、工具调用和结果数据在双臂上都是相同的。
Qwen Coder 是修复程序发挥作用的地方,其效果有两种。它成功完成了另外三项任务,从 27 项中的 19 项成功完成到 27 项中的 22 项。这对他们来说也更加困难:平均 LLM 调用从 3.8 增加到 4.9,工具调用从 2.8 增加到 3.9,工具结果数据从 16 KB 增加到 33 KB,持续时间从 27 秒增加到 42 秒。这些修复使放弃基准的任务取得成功,并且代价是速度更慢、更健谈的智能体。
任务级审核会显示这些权衡的来源。
- 在 blocked-command 任务中,基准 Qwen 在解析器块中死亡并得分 33%,而恢复方法则将修复臂提升至 100%。而这正是完成次数增加的原因:回收成本转而放弃从未花费过的成本。
- 不区分大小写的搜索任务则相反。零匹配探针输出使 Qwen 在三个代表中的两个进行了额外的探索性搜索,将其从 3.3 圈缩短到 9.3 圈,这是一个值得自己关注的回归。
- 在两个关键帧和两个关键帧模型上,隐藏文件搜索均保持在 0 – 33% 的水平,与最初在这些关键帧中找到且打开的结果相同。
仅凭任务的成败无法得出这一结论。NeMo Relay 追踪记录了所有 108 次运行的每次模型调用、工具调用、错误、重试、结果负载和计时。Qwen 的额外转变是恢复而不是连击,其中一项任务的回归可以追溯到特定的探针输出。系统会将追踪记录检查到结果目录中,因此任何人都可以将其解压缩,并从原始记录中重新生成这些表。
开始评估智能体追踪
NeMo Relay 为您提供了一种一致的方法来捕获证据,以评估更改,从而优化智能体的利用。ATOF 会保留有序的生命周期事件,而 ATIF 会呈现与可读轨迹相同的工作。通过将这些追踪与确定性验证器配对,您可以比较线束更改,而不会混淆调用次数和结果。
配套仓库提供示例构件,包括本博文中使用的可运行任务、验证器、NeMo Relay 配置和 Phoenix 设置。
了解详情:


