

CUDA 13.2 发布后进行了重大更新:NVIDIA CUDA Tile 现已支持具有 8.X 架构 ( NVIDIA Ampere 和 NVIDIA Ada ) 计算能力的设备,以及 10.X、11.X 和 12.X 架构 ( NVIDIA Blackwell )。在即将发布的 CUDA 工具包版本中,从 Ampere 开始的所有 GPU 架构都将获得全面支持。如果您使用 Ampere、Ada 或 Blackwell GPU 架构,请查看 cuTile Python 快速入门指南,开始使用 CUDA Tile。
本文将探讨 CUDA 13.2 版本,该版本通过添加各种新的 Python 功能 (包括在 CUDA Python 中进行分析和调试 Numba 内核) 来提高开发者的工作效率。数学库为高性能模拟库提供扩展支持,而 CUDA 核心计算库 (CCCL) 则不断提升性能和功能改进,为 C++ 开发者提供高性能的现代 GPU 编程接口。
cuTile Python
cuTile Python,CUDA Tile 编程模型的 Python DSL 表达式,将发布一系列功能增强。其中包括对以下内容的增强语言支持:
- 递归函数
- 使用 Capture 的闭包 (嵌套函数、lambda 函数)
- 自定义归约和扫描功能
- 允许使用类型标注进行分配
- 增强的阵列支持
Array.slice在子数组上创建视图
我们还提供了简单的安装路径。以下 pip install 命令将安装 cuTile Python 并拉取所有必要的依赖项,而无需在系统范围内单独安装 CUDA 工具包。
pip install cuda-tile[tileiras] |
核心增强功能
本节将详细介绍 CUDA 13.2 中的核心增强功能。
memcpy具有属性
上一个版本的 CUDA (12.8) 引入了批量处理 memcpy API。您可借此指定要通过单次函数调用调用的批量内存拷贝。您还可以指定属性,以便更好地控制和优化内存传输。
这些 API 可以更好地控制内存传输。但是,如果您只有一次传输,并且还想使用属性特征,则需要调用批量 API,然后将批量大小设为 1。这有点麻烦。
为简化此用例,我们新增了两个 API 函数,cudaMemcpyWithAttributesAsync以及cudaMemcpy3D 属性同步。这些函数允许您在内存调用中使用属性,而无需使用更复杂的批处理接口。
为了简化编程,如果您已使用cudaMemcpyAsync要使用属性,您可以继续使用cudaMemcpyAsync。它的参数列表与cudaMemcpyWithAttributesAsync。
减少 Windows 中每个上下文的本地内存占用
GPU 上的本地内存 (LMEM) 按线程分配,并用于寄存器溢出、堆栈变量等。从 CUDA 13.2 和 CUDA 驱动 R595 开始,在驱动模式 WDDM 的 Windows 上运行,LMEM 的使用量显著减少。这一变化的影响将主要体现在内存受限的 vGPU 环境中。
查询内存池的属性
CUDA 支持使用内存池进行高效内存管理。CUDA 13.2 引入了一个 API,用于从内存池句柄查询内存池的属性。这些属性是通过调用 cudaMemPoolGetAttribute 并使用适当的标志来获取的。
此新功能的一个用例是创建与已创建内存池相同类型的内存池。例如,使用 CUDA Graphs,API cudaGraphAddMemAllocNode 会将池属性作为参数接受。您可以使用当前内存池的属性来创建具有相同属性的新池。
Windows 计算驱动程序默认使用 MCDM 而非 TCC
在 Microsoft Windows 系统上,从 CUDA 驱动程序版本 R595 开始,在兼容的系统上,之前在 TCC 中默认启动的 GPU 现在将默认在 MCDM 中启动。此更改应能解决与某些系统的兼容性问题,即用户在启动时由于与操作系统/ 系统功能不兼容而在 TCC GPU 上出现黄色爆炸。对于依赖 TCC 的用户,它目前仍然可用,可以使用nvidia-smi -dm 1 -g < GPU ID >。
接下来,我们打算逐步永久过渡到 MCDM,因为它带来了以前在 WDDM 模式下保留给 GPU 的功能:
- WSL2:MCDM GPU 将显示在 WSL2 中,并且能够在 WSL 中运行 CUDA
- 容器:支持原生 (和 WSL) 容器
- 高级内存管理 API:
cuMemCreate、cudaMallocAsync所有相关 API 现在都支持 - 通过与 CUDA 工具包 13.1 中发布的 WDDM RDMA 相同的接口实现 RDMA
- 内存超额认购和裁剪通知。
由于 MCDM 中的一些额外开销,我们意识到现在的提交延迟略高于 TCC,我们正在积极努力将其与 TCC 和 Linux 原生版本 (在 WDDM 和 MCDM 上) 相美,以确保 WDDM/ MCDM 将成为适用于我们所有 Windows GPU 的未来验证驱动模型。
CUDA_DISABLE_PERF_BOOST
CUDA 工具包 13.2 和 CUDA 驱动程序版本 580 及更高版本添加了新的环境变量,CUDA_DISABLE_PERF_BOOST。这允许在运行 CUDA 应用程序时禁用将 GPU 提升到更高功率状态的默认行为。将此环境变量设置为 1 将禁用加速。在使用 NVENC/ NVDEC 等功能时,禁用性能提升可能会节省电量。
CUDA 计算多态函数以获取图节点参数
CUDA Graphs提供您创建GPU操作工作流程(如核函数启动和内存复制)为单个单元,而非一系列单独命令的能力。CUDA 13.2添加了新的多态API函数cudaGraphNodeGetParams,允许您获取图形节点的参数。这是现有多态函数(如cudaGraphNodeSetParams、cudaGraphAddNode和cudaGraphExecNodeSetParams)的配套函数。
编译器
CUDA 13.2 带来了新的编译器更新,包括对 Visual Studio 2026 等新主机编译器的支持、对 gcc 的 ARM C 语言扩展程序 支持,以及适用于 Tegra 和桌面 GPU 的单一统一工具包,从而减少容器和库的开销。
嵌入式设备
之前,在 CUDA 13.0 (和 NVIDIA JetPack 7.0) 中引入了适用于 Arm 的统一 CUDA,通过跨服务器级和嵌入式设备 (例如 NVIDIA Jetson Thor) 统一 CUDA 工具包来简化 Arm 平台的开发。
从 CUDA 13.2 开始 (以及即将推出的 JetPack 7.2 – 敬请关注) ,所有 Arm 目标均可使用相同的 Arm SBSA CUDA 工具包。此版本还支持同一 CUDA SBSA 工具包上的 NVIDIA Jetson Orin 设备。对于开发者而言,这意味着减少 CI 工作流中的重复,简化容器管理,并消除以前因杂用不同 SDK 而产生的细微错误和不一致之处。
CUDA 13.2 和 JetPack 7.2 引入了 NVIDIA 多实例 GPU (MIG) 支持,允许将集成 Jetson Thor 的 GPU 划分为两个完全独立的实例,每个实例都有专用的内存、缓存和计算资源。这种能力对于人形机器人等混合关键度应用尤为重要。在这些情况下,开发者可以将安全关键型工作负载 (例如电机控制和安全系统) 与非关键处理任务隔离开来。
如果没有 MIG,在同一 GPU 上运行的安全关键型和非关键型工作负载 (例如低延迟电机控制以及更繁重的感知或语言模型) 就会争夺共享资源。具有高内存带宽需求的突发任务可能会窃取安全关键型内核的容量,导致控制和安全系统抖动并错过延迟截止日期。
借助 MIG,关键和非关键工作负载可在单独的 GPU 实例上运行,且每个实例都具有专用的计算、显存和带宽。这种隔离可为控制和关键任务提供可预测的延迟和服务质量,同时通过在另一个实例上同时运行更繁重的感知或语言工作负载来保持 GPU 的高利用率。
数学库
CUDA 13.2 改进了包括 NVIDIA cuBLAS 和 NVIDIA cuSOLVER 在内的数学库。
NVIDIA cuBLAS
采用 Grouped GEMM 的全新实验性 API 现已支持适用于 NVIDIA Blackwell GPU 的 MXFP8。之前的支持 (在 CUDA 13.1 中) 包括 FP8 和 BF16/ FP16 Blackwell GPU 支持。在 Mixed of Experts (MoE) 用例中,支持 CUDA Graphs 的知名数据类型的 GEMM 分组可提供无主机同步的设备端形状实现,与多流 GEMM 实现相比,速度可提升高达 4 倍。
NVIDIA cuSOLVER
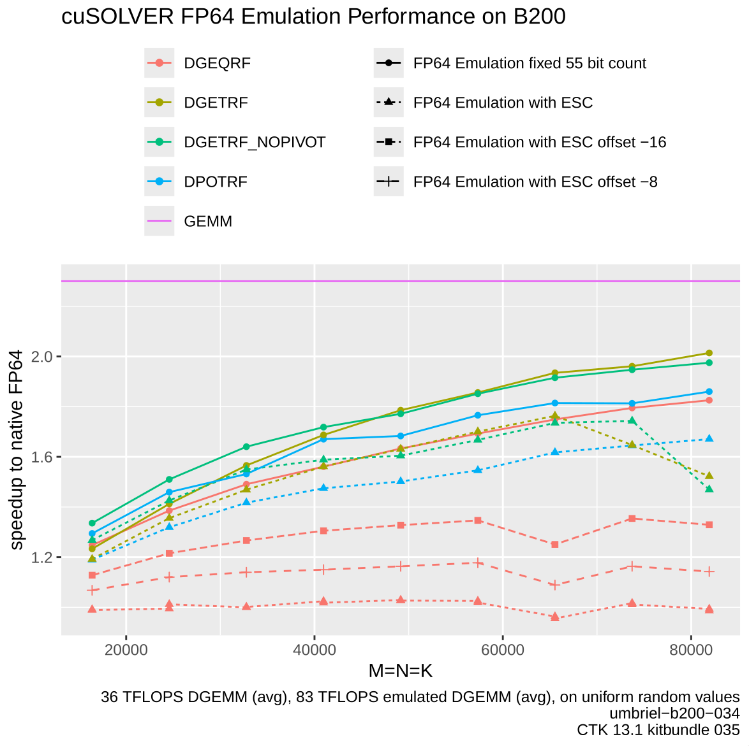
引入了用于 FP64+ 模拟计算的 cuSOLVERD API。这使得 INT8+ 与 FP64 吞吐量比率较高的平台能够实现显著的性能提升,特别是对于计算密集型工作负载。仿真的优势在用于 QR、LU 和 Cholesky 分解的关键 API 中最为明显。如需详细了解 NVIDIA 在仿真技术方面的最新进展,请参阅在 cuBLAS 中通过浮点仿真解锁 Tensor Core 性能。
图 1 显示了 NVIDIA B200 系统上 FP64+ 模拟 GDEQRF、DGETRF 和 DPOTRF 的结果。性能优势会随着矩阵大小的增加而增加,当矩阵大小接近 8 万时,QR 是三种运算中计算密集程度最高的运算,最多可提升至原来的 2 倍。
开发者工具
本节将详细介绍此版本的新开发者工具。
NVIDIA Nsight Python
NVIDIA Nsight Python 是一个新的内核分析接口,可将 NVIDIA 分析工具的强大功能直接提供给 Python 开发者。借助此版本,您可以直接从 Python 无缝配置通过 Python 框架跨多种配置启动的 CUDA 核函数。
用户只需使用几个修饰器,即可自动配置、分析和绘制内核性能比较图。Nsight Python 还支持访问常见 Python 数据结构中的性能数据,以进行高级分析。 从 PyPI 下载 Nsight Python。您还可以为 NVIDIA/nsight-python GitHub 资源库做出贡献,并访问 NVIDIA 开发者论坛,提出任何疑问或问题。
@nsight.analyze.plot("02_paramater_sweep.png")@nsight.analyze.kernel(configs=sizes, runs=10)def benchmark_matmul_sizes(n: int) -> None: """ Benchmark matrix multiplication across different sizes. The 'n' parameter comes from the configs list. """ a = torch.randn(n, n, device="cuda") b = torch.randn(n, n, device="cuda") with nsight.annotate("matmul"): _ = a @ b |
Numba-CUDA 调试
现在,借助 CUDA-GDB 命令行调试和 NVIDIA Nsight Visual Studio Code Edition,首次可以调试在 GPU 上运行的 Numba-CUDA 内核。用户可以像使用主机和原生 CUDA 调试器一样,设置断点、逐步执行语句并检查程序状态。此初始支持的功能集有限,团队正在积极寻求反馈以改进此功能集。如需了解详情,请查看 Numba-CUDA 调试文档,并在 开发者论坛 上寻求帮助或反馈。
NVIDIA Nsight 工具更新
NVIDIA Nsight Compute 2026.1 包含可从“File” (文件) >“Merge Reports” (合并报告) 菜单访问的新报告聚类和合并工具。这有助于用户理解重复实验、单独的分析会话或生成多个报告的多进程应用所产生的数据。
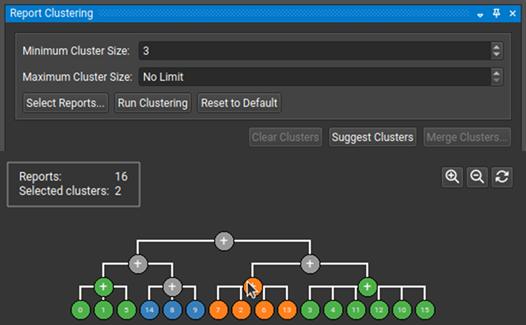
“Source” (源) 页面上新增了“Register Dependency Relationship” (寄存器依赖项) 相关窗口,可帮助用户识别源行依赖项,以快速找到瓶颈。CUDA Graphs 查看器工具窗口已得到显著改进,可以显示在交互式分析模式下构建和分析的图形,并以直观方式将收集的结果与图形节点关联起来。Nsight Compute 包含在 CUDA 工具包中,可独立下载。
NVIDIA Nsight Cloud 更新了适用于 Kubernetes 的 Nsight Operator,以及用于在集群内访问和查看 Nsight 工具报告的 Nsight Streamer Kubernetes 和 Docker 容器。
NVIDIA Nsight Copilot 是一款免费的 AI 赋能 CUDA 编码助手,现已面向拥有 NVIDIA 开发者帐户的所有人提供。
NVIDIA Nsight Systems 2026.1 包括:
- PyTorch 分析改进,可显示向前和向后扩展模块的形状和训练参数
- 在 Python 采样功能中支持 Python 3.14
- 用于捕获 GPUDirect Storage DMA 操作指标的新选项
CCCL
CUDA 13.2 随附 3.2 版本的 CCCL。亮点包括新的现代 CUDA C++ 运行时 API 和新的优化算法,包括 Top-K。
现代 CUDA C++ 运行时
CCCL 3.2 为核心 CUDA 运行时和驱动功能广泛引入了新的惯用 C++ 接口。
如果您已经编写了 CUDA C++,您可能已经围绕当今类似 C 语言的 API 构建 (或采用) 了某种形式的便捷封装器,例如cudaMalloc或cudaStreamCreate。
CCCL 3.2 中添加的新 API 旨在为核心 CUDA 结构提供 C++ 的生产力和安全优势,因此您可以减少重塑包装器的时间,并将更多时间用于编写内核和算法。
亮点包括:
- 适用于核心 CUDA 概念的新型便捷词汇表类型 (
cuda::stream、cuda::event、cuda::arch_traits) - 使用内存资源和 内存资源 和
cuda::buffer更轻松地管理内存 - 更强大、更便捷的核函数启动
cuda::launch
示例 (向量加法、重述) :
cuda::device_ref device = cuda::devices[0];cuda::stream stream{device};auto pool = cuda::device_default_memory_pool(device);int num_elements = 1000;auto A = cuda::make_buffer<float>(stream, pool, num_elements, 1.0);auto B = cuda::make_buffer<float>(stream, pool, num_elements, 2.0);auto C = cuda::make_buffer<float>(stream, pool, num_elements, cuda::no_init);constexpr int threads_per_block = 256;auto config = cuda::distribute<threads_per_block>(num_elements);auto kernel = [] __device__ (auto config, cuda::std::span<const float> A, cuda::std::span<const float> B, cuda::std::span<float> C){ auto tid = cuda::gpu_thread.rank(cuda::grid, config); if (tid < A.size()) C[tid] = A[tid] + B[tid];};cuda::launch(stream, config, kernel, config, A, B, C); |
请持续关注,以更深入地了解设计目标和预期使用模式,以及这些新 API 如何与现有 CUDA API 配合使用。
新算法
本节将详细介绍 CUDA 13.2 的新算法。
Top-K 选择
CCCL 3.2 引入了cub::DeviceTopK(例如,cub::DeviceTopK::MaxKeys) 选择 K 个最大 (或最小) 元素,而不对整个输入进行排序。对于 K 较小的工作负载,与完整的基数排序相比,这可以提供高达 5 倍的加速,并且在您不需要排序结果时可以减少内存消耗。
Top K 是 CCCL 的一个活跃工作领域。路线图包括计划中的分割 Top* K 以及块* 范围和线程束* 范围 Top* K 变体。如需详细了解计划内容并分享最重要的 Top# K 用例,请参阅 NVIDIA/cccl GitHub Issue# 5673。
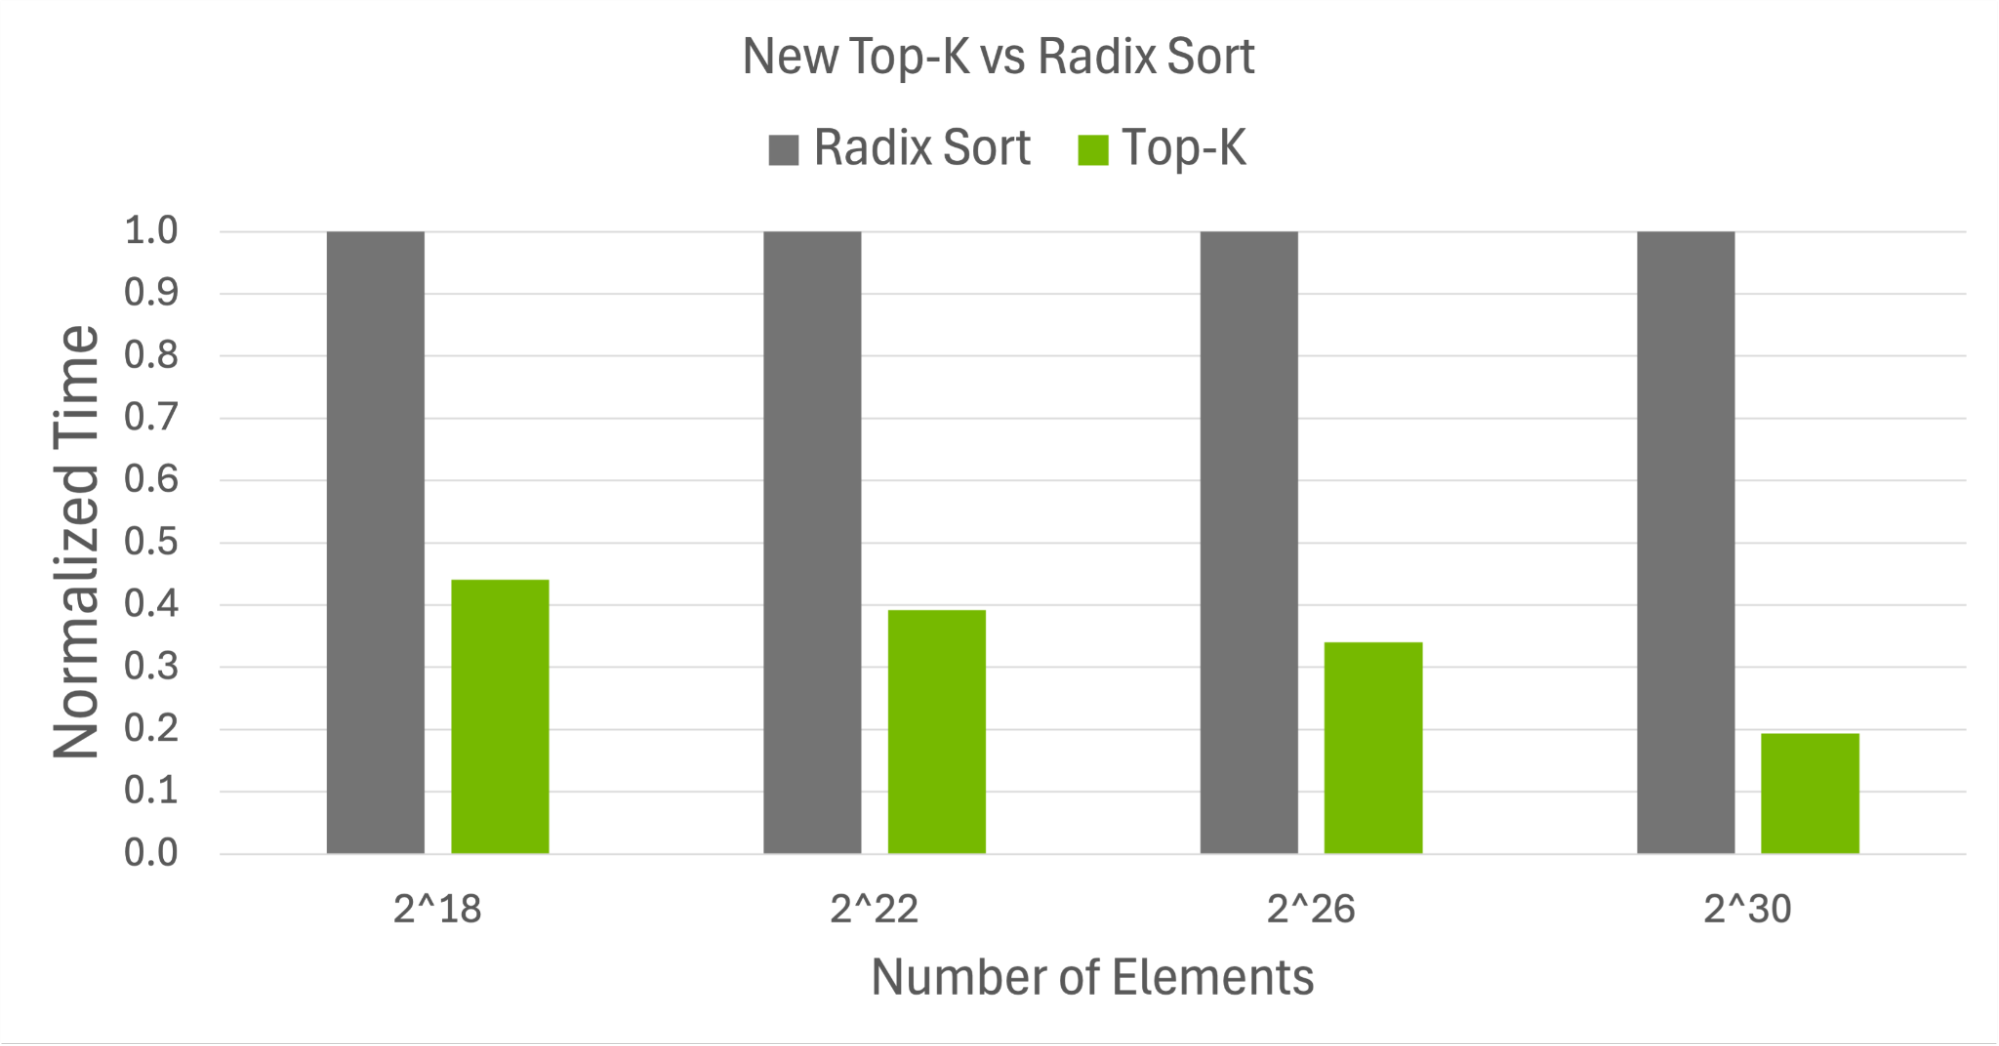
cub::DeviceTopK::MaxKeys for K = 3执行完整基数排序的常见解决方案固定大小的分段归约
CCCL 3.2 现在提供了一个新的 cub::DeviceSegmentedReduce 变体,该变体接受统一的 segment_size,从而在段大小固定的普通情况下消除了偏移迭代器开销。这可实现小段规模 (高达 66 倍) 和大段规模 (高达 14 倍) 的优化。
// New API accepts fixed segment_size instead of per-segment begin/end offsetscub::DeviceSegmentedReduce::Sum(d_temp, temp_bytes, input, output, num_segments, segment_size); |
在图 4 中,与为每个线段指定开始和结束偏移量的现有实施方案相比,新的固定大小变体显示小型和大型线段的速度显著提升。
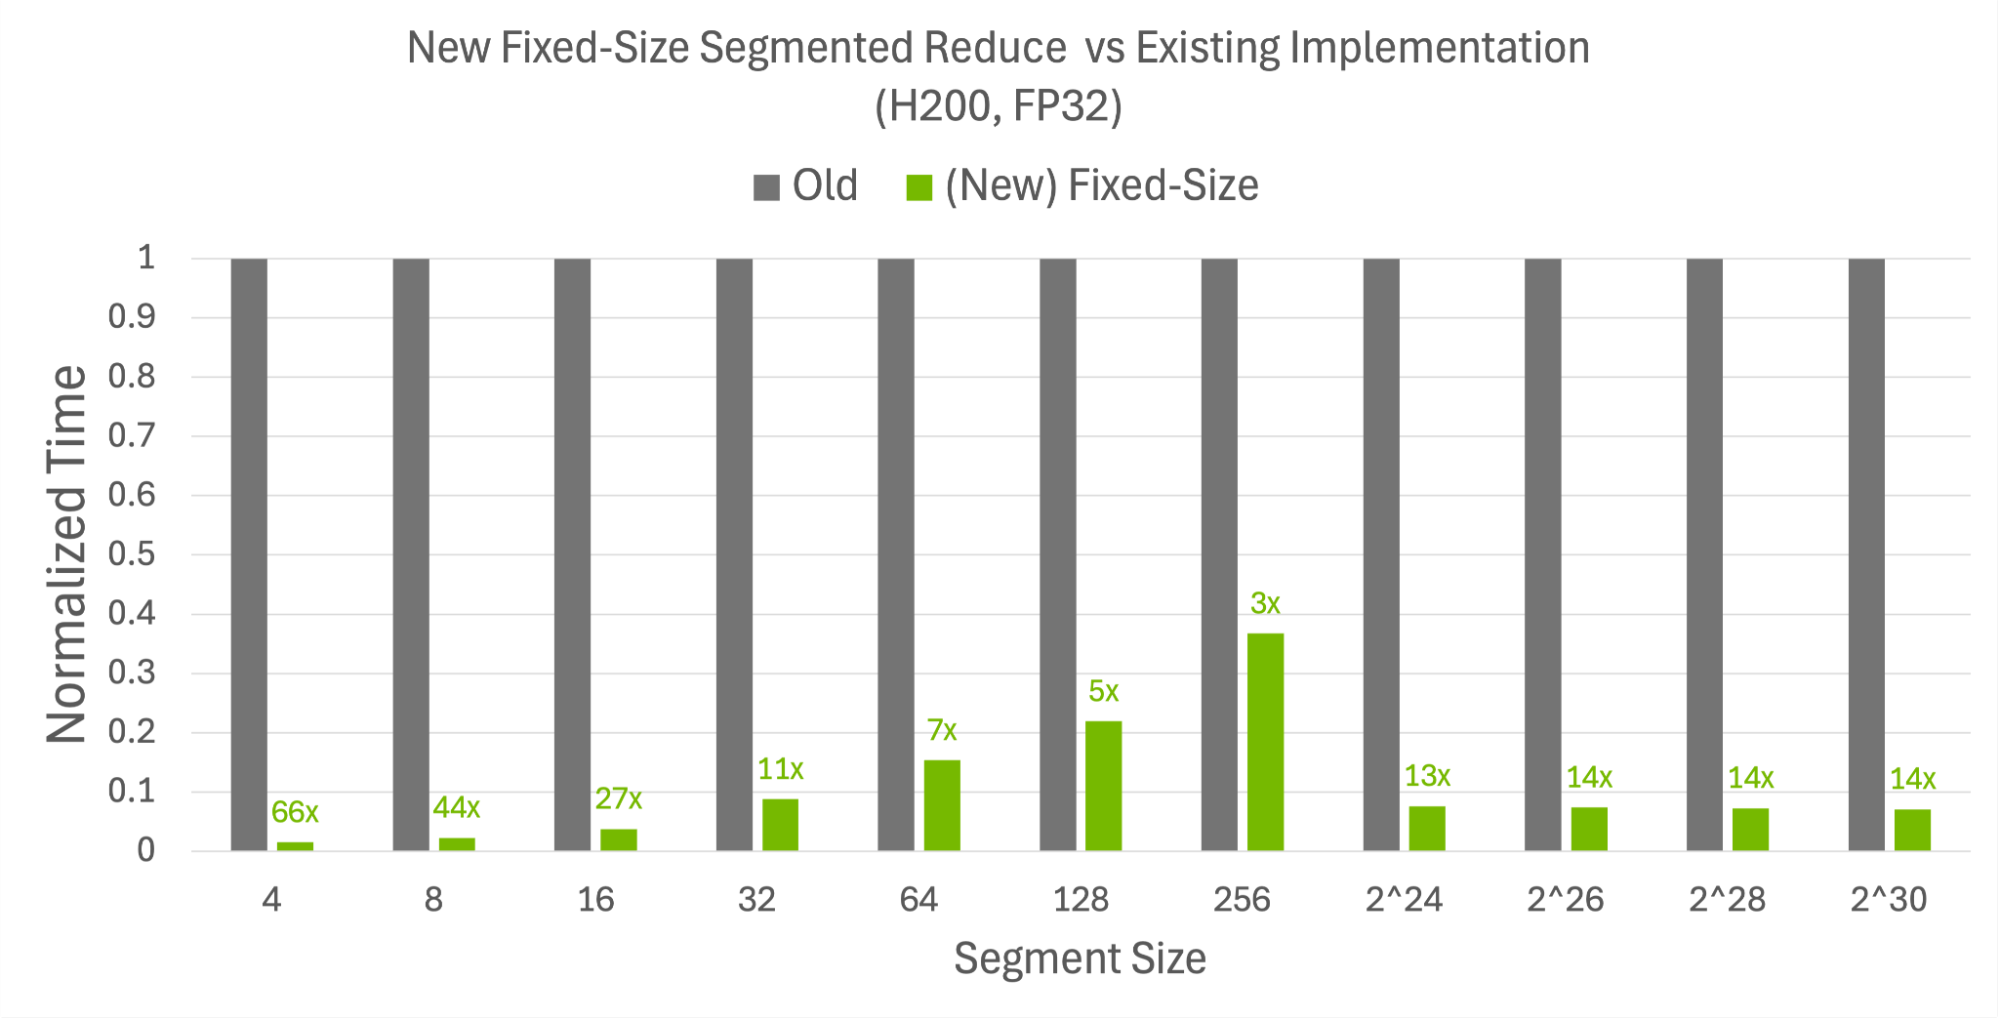
cub::DeviceSegmentedReduce现有实现CCCL 3.2 中的更多新算法
Segmented Scan: cub::DeviceSegmentedScan 提供并行扫描的分段版本,可高效计算多个独立段的扫描操作。
二进制搜索: cub::DeviceFind::[Upper/ LowerBound]对有序序列中的多个值执行并行搜索。
Search: cub::DeviceFind::FindIf 在无序输入中搜索第一个满足给定条件的元素。得益于其早期退出逻辑,其速度比搜索整个序列快 7 倍。
CUDA Python
CuPy 现在支持 CUDA 13.0 和 13.1,并且 PyPI 中提供了适用于 CUDA 12 和 CUDA 13 的 wheels。这意味着,在没有系统级 CUDA 工具包的情况下,安装 CuPy 比以往更容易。
pip install cupy-cuda12xpip install cupy-cuda13x |
CuPy 现在实现了 CUDA 流协议,支持与 PyTorch、JAX 和其他支持该协议的框架进行直接流共享。这意味着无需手动指针管理即可实现零拷贝互操作性。
# Share a CuPy stream with PyTorchpytorch_stream = torch.cuda.ExternalStream(cupy_stream)# Or import an external stream into CuPycupy_stream = cupy.cuda.Stream.from_external(pytorch_stream) |
现已支持ml_dtypes.bfloat16将原生降低精度计算引入 CuPy,这是一种常用于 AI 训练和推理的类型。通过对通用 ufunc、数组运算符和标量处理进行快速路径优化,一些核心运算的性能得到了提升。对多线程应用程序的支持得到了改进。CuPy 数组现在可以被视为cuda::std::mdspan对象ndarray.mdspan可控制 32 位和 64 位索引。这使用户能够更好地控制算术运算和性能。
cuda.core 0.6 引入了用于 GPU 监控和管理的 NVML 绑定 (cuda.bindings.nvml),以及用于胖二进制操作的新 nvFatbin 绑定 (cuda.bindings.nvfatbin)。新的 cuda.core.system 模块提供对系统信息的 Pythonic 访问,例如基于 NVML 构建的设备温度监控和 CPU/ GPU 亲和性,建在 NVML 之上。
对构建 CUDA 计算图的支持已从实验性命名空间毕业,并且可在主命名空间下使用cuda.core命名空间。这使开发者能够捕获操作序列并以最少的开销进行回放,并支持条件执行等高级模式 (if_cond以及while_loop) ,fork-join。以下代码展示了 API 的工作原理:
# Build a graph by capturing operationsgb = device.create_graph_builder()gb.begin_building()# Capture kernel launches in the graph (not executed)launch(gb, LaunchConfig(grid=256, block=256), kernel_a, data_ptr)launch(gb, LaunchConfig(grid=256, block=256), kernel_b, data_ptr)launch(gb, LaunchConfig(grid=256, block=256), kernel_c, data_ptr)# Finalize and instantiate the graphgraph = gb.end_building().complete()# Launch the graph into an existing CUDA Streamgraph.launch(stream) |
有关更多信息,请参阅 cuda.core.GraphBuilder 文档和 示例。
开始使用 CUDA 13.2
CUDA 13.2 通过继续将 Python 提升为一流公民,并引入以生产力为重点的语言功能,在易用性和 GPU 峰值性能之间架起桥梁,从而简化高性能开发。
致谢
感谢以下 NVIDIA 贡献者:Jake Hemstad、Becca Zandstein、Jackson Marusarz、Mridula Prakash、Rekha Mukund、Daniel Rodriquez、Bo Dong、Andy Terrel、Raphael Boissel 和 Rob Armstrong。
